

PSGRN:利用合成金标准进行自训练,从单细胞扰动数据中推断基因调控网络
PSGRN: Gene regulatory network inference from single-cell perturbational data through self-training with synthetic gold standards
1. 领域背景与文献
发表期刊:Science Advances;影响因子:未公开;研究领域:生物信息学,单细胞基因调控网络推断。
理解基因表达间的因果关系、构建基因调控网络(GRN)对治疗方案设计和药物功效评估具有重要价值。领域共识:单细胞高通量测序技术的发展突破了传统研究的限制,使得单次实验可同时分析数千个遗传扰动事件,极大拓展了细胞系统中因果推断的研究范围。现有GRN推断方法主要分为两类,一类将网络推断问题转化为特征排序问题,代表方法如GENIE3、GRNBoost,这类方法基于其他基因的表达预测单个基因的表达,根据特征重要性评分对调控关系进行排序;另一类属于因果发现领域方法,通过引入连续可微约束适配深度学习和梯度优化,代表方法如DCDI,这类方法可处理结合观测和干预数据的大规模复杂数据集。
尽管现有方法已取得诸多进展,但在最新的单细胞扰动基准数据集CausalBench评估中,现有方法仍存在显著的性能缺口:原本针对观测数据设计的GRN推断方法,在加入干预数据后性能往往无法得到提升,即使提供了额外的扰动数据,前沿因果发现算法的性能提升也十分有限,这与“干预数据可增强因果推断能力”的普遍假设相悖。现有研究认为,这种局限性可能来源于模型基于间接金标准(如基因表达)训练、采用不稳定指标(如特征重要性评分)评估,或是基于合成测试数据集验证,因此获取反映直接基因-基因互作的可靠注释,在其监督下训练模型,是推进单细胞扰动研究中GRN推断发展的关键。本研究针对这一核心问题,开发了基于合成伪金标准自训练的半监督GRN推断工具,为单细胞扰动数据的基因调控网络推断提供了更准确鲁棒的新方法。
2. 文献综述解析
作者将现有GRN推断研究按方法原理分为基于特征排序的传统方法和基于可微约束的因果发现深度学习方法两类,在此基础上分别梳理不同方法的优势与局限性,通过对比突出本研究的创新必要性。现有基于特征排序的方法优势在于算法逻辑简洁,可适配常规转录组表达数据,已在多个场景得到应用,但这类方法的局限性在于未针对单细胞扰动数据设计,无法充分利用扰动提供的干预信息,在基准测试中性能提升十分有限。基于因果发现的深度学习方法优势在于可整合观测与干预数据,处理更大规模的复杂数据集,通过编码网络结构引入结构约束,但其局限性同样表现为无法有效利用额外扰动数据提升性能,在CausalBench基准测试中整体表现较差。此外,现有方法普遍存在依赖间接金标准训练、评估体系不稳定的问题,无法有效捕获直接的基因调控互作。
本研究的创新价值明确,针对现有方法无法有效利用单细胞干预数据、依赖间接金标准训练的核心缺陷,首次提出了基于合成伪金标准自训练的半监督GRN推断工具PSGRN,通过基因表达相关性生成初始伪注释,结合自训练迭代对初始噪声标签去噪优化,可有效整合观测和干预数据的关联信息,学习超出简单相关性的高阶调控模式。该方法获得了2023年GSK.ai CausalBench挑战赛冠军,在基准测试以及多个外部公开单细胞数据集上均展现出更优的准确性和鲁棒性,同时该方法可适配纯观测数据场景,拓展了GRN推断的应用范围,解决了现有领域的核心痛点问题。
3. 研究思路总结与详细解析
本研究的整体研究目标是开发可从单细胞扰动数据中准确推断基因调控网络的新方法,核心科学问题是如何利用合成伪金标准结合自训练有效整合观测与干预数据,提升GRN推断的准确性与鲁棒性,技术路线遵循“数据集收集与质控→伪注释生成→特征提取→模型训练与推断→多维度性能验证”的闭环逻辑,完成了方法开发与全面基准测试。
3.1 数据集收集与质量控制
实验目的:获得高质量的单细胞扰动数据集,用于后续模型开发与性能验证。方法细节:采用CausalBench挑战赛提供的K562和RPE1两个细胞系的数据集,均来源于全基因组规模CRISPR扰动的Perturb-seq实验,对原始干预数据进行两步质量控制:在扰动层面,保留满足三个条件的扰动事件,即至少诱导50个差异表达基因、至少包含25个高质量活细胞、靶基因敲低效率至少达到30%;在细胞层面,剔除扰动后靶基因表达高于观测数据中未扰动对照表达第10百分位数的细胞,同时剔除有效细胞数少于100的扰动,保留未扰动对照细胞作为观测数据,后续对表达矩阵进行总唯一分子标识符归一化和对数转换,最终仅保留有效扰动对应的基因作为分析特征。结果解读:质控后K562数据集保留622个独特扰动,共132572个细胞,622个基因,每个扰动的中位细胞数为162(n=622);RPE1数据集保留383个独特扰动,共101253个细胞,383个基因,每个扰动的中位细胞数为144(n=383),数据质量满足后续模型训练与评估的要求。
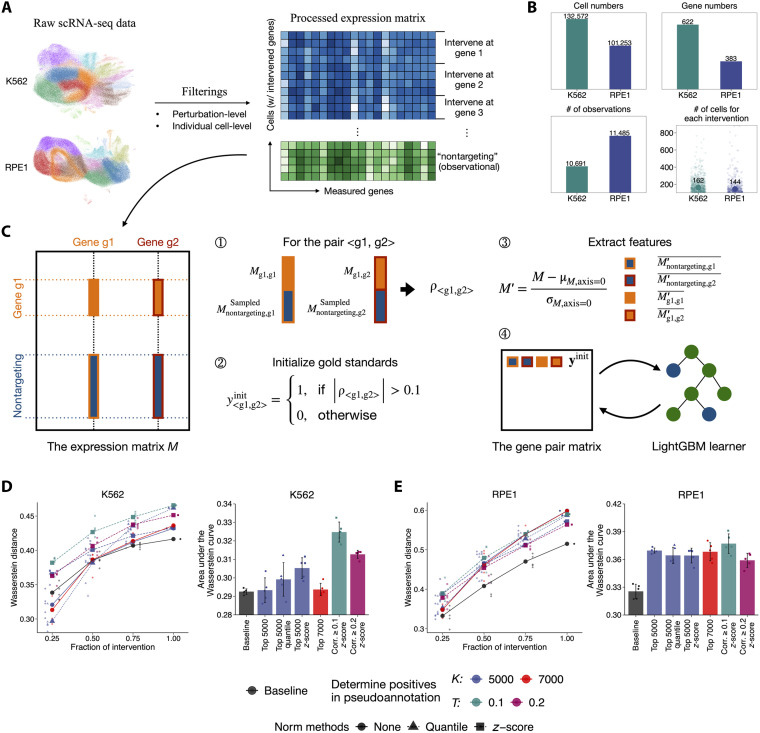
文献未提及具体实验产品,领域常规使用10x Genomics单细胞测序试剂盒、CRISPR-Cas9基因编辑工具。
3.2 PSGRN模型框架构建与超参数优化
实验目的:构建PSGRN自训练模型框架,筛选得到最优超参数组合。方法细节:PSGRN基于自训练框架设计,核心步骤包括:首先对所有测量基因生成基因对,基于基因表达相关性计算为基因对分配伪注释,随后提取每个基因对在干预前和干预后的平均表达作为特征,结合伪注释构建训练数据集,最后训练二分类模型,对所有基因对预测调控概率,选取概率最高的前1000(PSGRN 1K)或前5000(PSGRN 5K)基因对作为最终推断的调控关系。本研究采用LightGBM作为二分类模型,设置核心参数为单树最大叶数5、最大深度2、学习率0.05、迭代次数1000;对不同比例(0.25、0.5、0.75、1.0)的干预数据进行超参数筛选,采用瓦瑟斯坦距离和瓦瑟斯坦距离曲线下面积(AUC-Wasserstein)评估性能。结果解读:最优超参数组合为相关性阈值T=0.1,特征层面采用z分数归一化,该设置下PSGRN在K562数据集的平均AUC-Wasserstein为0.3248(±0.005),在RPE1数据集为0.3771(±0.01),性能优于基于相关性的基线方法(K562:0.2926±0.001,RPE1:0.3255±0.008),同时也显著优于DCDI、GRNBoost等对比方法,性能超过其他所有超参数组合至少3.83%(文献未明确提供P值,基于文本结果推测),因此选择该优化模型用于后续所有分析。
文献未提及具体实验产品,领域常规使用Python的LightGBM工具包实现模型训练。
3.3 多场景性能基准测试与对比
实验目的:评估PSGRN在不同干预比例、不同样本量以及纯观测数据下的鲁棒性、可扩展性和泛化能力,与现有主流方法进行全面对比。方法细节:分别设置不同比例(5%、15%、25%、50%、75%、100%)的干预数据和不同比例的总样本量,训练模型后在留存测试集上评估,采用统计精度、错误遗漏率(FOR)、瓦瑟斯坦距离作为统计评估指标;同时整合CORUM、STRING、染色质免疫沉淀测序(ChIP-seq)数据构建生物学金标准,采用精确率、召回率、F1分数作为生物学评估指标;额外设计按扰动分层拆分训练测试集的实验,评估模型对未见过的扰动事件的泛化能力;最后在BEELINE流程的6个纯观测单细胞RNA测序数据集(人胚胎干细胞、人成熟肝细胞、小鼠胚胎干细胞、三个小鼠造血干细胞亚群)上评估模型性能,采用精度召回曲线下面积(AUPRC)衡量性能。结果解读:统计评估结果显示,随着干预数据比例增加,PSGRN的统计精度逐步提升,在K562中PSGRN 1K精度从0.8122提升至0.9950,PSGRN 5K从0.4712提升至0.9612,提升幅度显著优于对比方法MixScale;全干预数据下,PSGRN在K562比MixScale精度高12.4%(1K)和24.1%(5K),在RPE1高16.5%(1K)和21.1%(5K);瓦瑟斯坦距离方面,全干预训练的K562中PSGRN瓦瑟斯坦距离超过MixScale 29.5%(1K)和27.4%(5K),RPE1中超过42.7%(1K)和26.6%(5K),同时PSGRN在K562中获得所有方法中最低的错误遗漏率。生物学评估结果显示,随着干预数据量增加,PSGRN的精确率和召回率逐步提升,全干预数据下K562中PSGRN 5K的F1分数达到0.1174,RPE1达到0.1753;K562中PSGRN 5K比GRNBoost 5K精确率高30.2%,召回率高142.4%,比MixScale 5K精确率高154.0%;RPE1中比最优基线方法精确率高12.7%,召回率高107.8%;自训练后,生物学验证的真实调控互作排名平均提升9446.56位(K562)和4066.42位(RPE1),证明自训练可有效提升真实调控对的优先级。在按扰动拆分的泛化实验中,PSGRN瓦瑟斯坦距离平均提升126.87%,错误遗漏率提升10.23%,泛化性能优异。纯观测数据下,PSGRN性能也优于其他对比方法,在K562中PSGRN 1K瓦瑟斯坦距离为0.2237,精度为0.695,优于其他算法至少66.17%和117.32%;在6个外部纯观测数据集的评估中,PSGRN性能与当前最优方法GRNBoost相当,在人源数据集上表现更优,展现出良好的跨场景适应性。
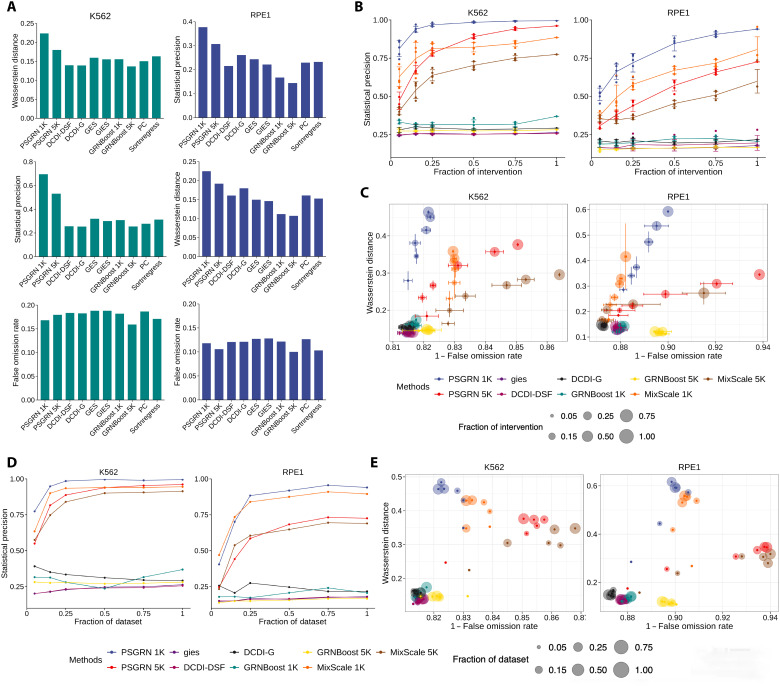

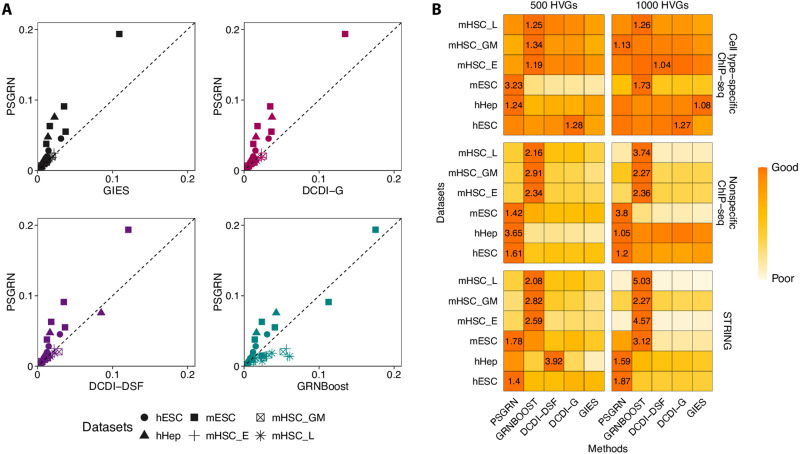
文献未提及具体实验产品,领域常规使用Python的scikit-learn、R的DESeq2等工具包实现基准方法对比。
3.4 推断调控网络的生物学有效性验证
实验目的:验证PSGRN推断的调控网络的生物学相关性,与传统差异表达基因分析方法进行比较。方法细节:对PSGRN和差异表达基因分析推断的前5000个调控互作分别进行疾病术语富集分析和调控网络构建,比较两者富集的疾病术语和核心调控子网络。结果解读:在K562数据集,PSGRN鉴定出10个校正P值小于0.01的显著疾病术语,与差异表达基因分析的结果重叠度高,富集的核心术语与造血过程相关,包括钻石布莱克法贫血、纯红细胞再生障碍性贫血、造血系统疾病,符合K562细胞的白血病起源特征;RPE1数据集两种方法均显著富集加洛韦莫瓦特综合征,符合细胞系的生物学特征。调控网络分析显示,PSGRN和差异表达基因分析均得到核糖体和线粒体基因富集的高度连接子网络,共享RPL8、MRPS22、PNPT1等核心枢纽基因,同时PSGRN还额外鉴定出ACTB(与细胞骨架重塑和造血相关)、RPL5(与核糖体病相关)、HSPA9(与线粒体贫血相关)等疾病相关调控因子,能够在保留核心生物学结构的基础上提供互补的调控信息,证明PSGRN推断的网络具有良好的生物学一致性和实用价值。
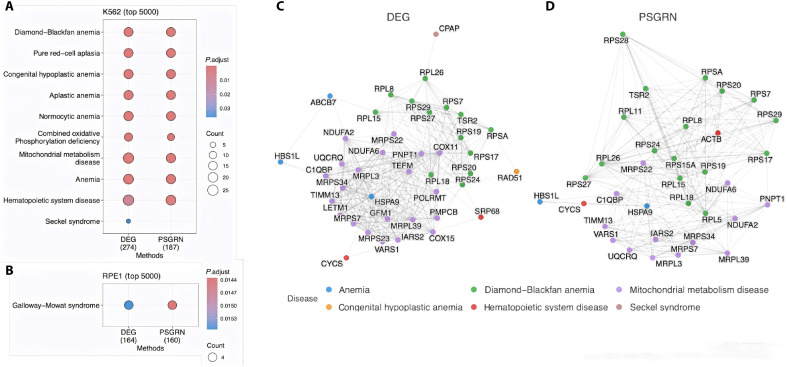
文献未提及具体实验产品,领域常规使用R的clusterProfiler包实现富集分析。
4. Biomarker 研究及发现成果
本研究为基因调控网络推断的方法学研究,核心内容是开发新的GRN推断算法并完成性能验证,全文未涉及生物标志物的筛选、验证及功能相关研究,无相关Biomarker研究成果产出。