

利用分位数阈值法(QuanT)识别微生物组数据中未测量的异质性
Identifying unmeasured heterogeneity in microbiome data via quantile thresholding (QuanT)
1. 领域背景与文献
文献英文标题:Identifying unmeasured heterogeneity in microbiome data via quantile thresholding (QuanT)。
发表期刊:未公开;影响因子:未公开;研究领域:微生物组生物信息学、宏基因组统计分析。
领域共识:下一代测序技术的普及推动了大规模微生物组研究的发展,公共可获得的微生物组数据量近年来大幅增长,整合多来源、多批次的微生物组数据开展荟萃分析已经成为领域研究热点,而数据整合过程中隐藏的技术或生物学异质性是影响结果可靠性的核心问题。未识别校正的隐藏异质性会掩盖真实生物学信号,导致假阳性结果,尤其在整合公共数据时,批次标签等异质性来源信息经常缺失,该问题更为突出。
当前领域中,针对已知批次标签的批次效应校正已经开发了多款工具,基因组领域的ComBat、微生物组领域的MMUPHin、DEBIAS-M、ConQuR等方法都可以实现有效校正,但这类方法均依赖于已知异质性来源标签,无法处理未测量的未知异质性。针对未测量异质性,现有方法均来自基因组研究,代表性方法包括替代变量分析(SVA)和去除无关变异(RUV),但这类方法并不适配微生物组数据的特征,存在三大核心缺陷:一是未考虑微生物组数据普遍存在的零膨胀和过离散特性,二是仅检测均值层面的变异,忽略分布其他位置的异质性,三是RUV需要用户预先指定隐藏因子的数量,参数设置错误会直接导致假阳性或假阴性。因此,领域缺乏专门针对微生物组数据特点开发的未测量异质性识别方法,本研究针对该空白开发了首款专门工具QuanT,为微生物组数据整合和下游分析提供了稳健的方法支撑。
2. 文献综述解析
作者按照方法适用场景对现有研究进行分类梳理,核心逻辑围绕异质性是否可测量展开,第一类为可测量异质性校正方法,第二类为未测量异质性识别方法。对于可测量异质性校正方法,现有研究已经验证了这类方法在标签已知时的校正效果,多款工具已经在领域得到广泛应用,优势是校正效率高、计算速度快,但局限性非常明确:仅能处理已知来源的异质性,无法应用于没有标签的公共数据整合场景,不能应对未知来源的隐藏异质性。对于未测量异质性识别方法,现有方法均来自基因组研究,核心优势是不需要预先提供异质性标签,能够通过统计方法从数据中识别隐藏变异,已经在基因表达研究中得到应用,但是这类方法迁移到微生物组研究中存在明显缺陷:它们没有适配微生物组零膨胀、过离散的分布特点,仅关注均值层面的变异,无法识别分布其他位置的异质性,同时存在参数依赖问题,容易导致假阳性或假阴性结果。
对比现有研究的缺陷,本研究的创新价值非常明确:这是首款专门针对微生物组数据开发的未测量异质性识别工具,从方法设计层面适配了微生物组数据的分布特点,不需要用户预先指定隐藏因子数量,能够识别均值偏移之外的异质性,作为非参数方法对分布假设要求低,输出的分位数替代变量可以方便整合到各类下游分析流程中,也可以和现有批次校正工具结合使用,解决了领域的核心需求,填补了未测量异质性识别方法的空白。
3. 研究思路总结与详细解析
本研究的整体目标是开发专门适配微生物组数据特征的未测量异质性识别方法,核心科学问题是如何在没有异质性标签的情况下,有效识别微生物组数据中的隐藏混杂异质性,同时适配微生物组零膨胀、过离散的分布特点。技术路线采用“方法设计-模拟验证-真实数据验证”的闭环逻辑,核心算法为两阶段结构:第一阶段通过分位数回归和奇异值分解提取初始异质性结构,第二阶段通过迭代特征加权和相关性校准得到最终可用的分位数替代变量,最终通过多场景模拟和三个不同类型的真实数据集验证方法性能,与现有主流方法做比较。
3.1 算法整体框架设计
实验目的:明确QuanT算法的整体结构和基本参数规则。方法细节:算法整体为两阶段设计,以微生物组分类单元相对丰度矩阵为输入,将每个分类单元的相对丰度作为回归结局,纳入研究关注的主要变量和需要校正的协变量,默认设置0.1到0.9之间步长0.005的分位数序列,对于存在大量零值的分类单元,自动剔除低于零值比例的分位数水平,实现数据自适应的有效分位数选择,避免无效计算。结果解读:这种自适应设计可以充分利用不同分布特征分类单元的信息,兼顾了统计效能和计算效率,方法整体的非参数特性适配了微生物组的复杂分布,不需要对数据分布做严格假设。文献未提及具体实验产品,领域常规使用R语言生物信息学工具完成方法开发。

3.2 第一阶段:初始异质性结构识别
实验目的:从原始数据中提取出与已知变量无关的系统性异质性结构。方法细节:对每个可行的分类单元-分位数组合拟合分位数回归模型,得到估计分位数后,将观察丰度与估计分位数做比较阈值化,生成二值化的中心化残差,所有残差拼接得到残差矩阵;随后对残差矩阵做奇异值分解,结合两个标准选择奇异向量:一是奇异向量的分布与完全零假设下的正态分布存在统计学差异,二是奇异向量解释残差矩阵的变异比例较高,使用SelectiveSeqStep程序同时满足两个标准,控制错误发现率得到第一阶段奇异向量。结果解读:双标准选择策略是QuanT的创新点,既保留了解释变异较大的系统性结构,又能够识别出有生物学意义但解释变异比例较小的结构,解决了现有方法仅关注高变异成分的缺陷,第一阶段奇异向量能够有效捕获不依赖已知变量的系统性变异。文献未提及具体实验产品,领域常规使用R语言quantreg包实现分位数回归,RSpectra包实现奇异值分解。
3.3 第二阶段:迭代特征加权与相关性校准
实验目的:修正第一阶段奇异向量无法捕获混杂异质性的缺陷,得到可用于下游校正的最终结果。方法细节:第一阶段拟合模型时已经剔除了已知变量的影响,导致得到的奇异向量与主要研究变量不相关,无法捕获和主要变量相关的隐藏混杂异质性,因此第二阶段在不剔除已知变量的情况下重新构建二值中心化残差,通过迭代过程对分类单元-分位数组合加权:每次迭代中通过两次模型比较得到两个p值,小p值说明该组合能够捕获初始异质性信息,大p值说明该组合受已知协变量影响小,对两个p值分别计算局部错误发现率,以两者的乘积作为该组合的权重,加权后重新做奇异值分解得到新的迭代奇异向量,重复迭代直到相邻迭代结果收敛或者达到默认10次的最大迭代次数,收敛后的奇异向量就是最终输出的分位数替代变量(QSV);若第一阶段未筛选出奇异向量,则改用仅按变异解释比例选择初始奇异向量,后续依然执行相同的校准步骤。结果解读:相关性校准保证了输出的分位数替代变量能够有效捕获隐藏的混杂异质性,同时保留了和主要研究变量的相关性,可以直接作为协变量纳入下游分析,也可以结合现有批次校正工具去除隐藏异质性。文献未提及具体实验产品,领域常规使用R语言统计工具完成迭代计算。
3.4 模拟验证实验设计与结果
实验目的:在异质性已知的模拟数据中评估QuanT的性能,和现有主流方法做比较。方法细节:以人类微生物组项目的两个真实数据集(肠道炎症性肠病数据集IBDMDB、阴道微生物组数据集MOMS-PI)为模板,分别采用参数化Dirichlet-多项分布、非参数MIDASim、对数线性模型三种方式生成模拟数据,模拟设置了不同的批次效应和研究变量效应大小,将批次作为未测量的异质性,以校正真实批次的结果作为金标准,比较QuanT、SVA、RUV三种方法在差异丰度分析中的错误发现率和结果一致性。结果解读:两个模板数据集覆盖了微生物组不同的稀疏度和过离散水平,三种模拟方式覆盖了不同的数据生成机制,保证了验证结果的稳健性,所有模拟场景下QuanT的错误发现率控制都优于SVA和RUV,结果与金标准的一致性更高;当QuanT结合ConQuR批次校正方法时,可以在消除隐藏批次效应的同时完整保留研究变量的效应,符合方法设计预期。
3.5 真实数据集验证实验
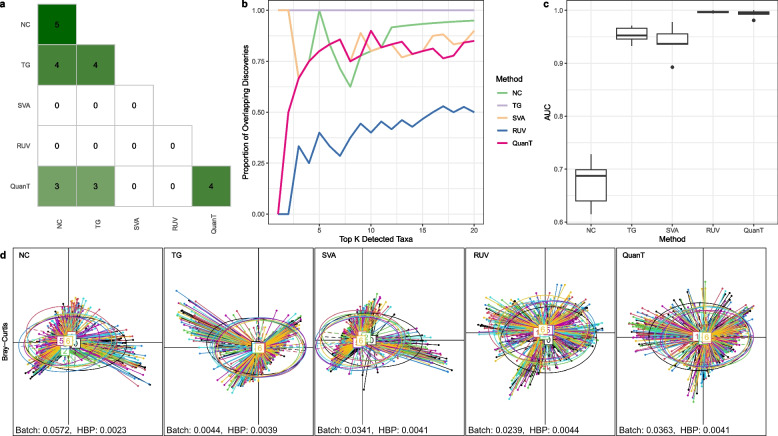
实验目的:在真实微生物组研究数据中验证QuanT的实际应用表现。方法细节:选择三个不同异质性来源的真实数据集,均将真实批次/研究标签作为未知,以校正真实标签的结果作为金标准,从差异分析一致性、预测准确性、异质性去除效果三个维度比较三种方法的性能。第一个数据集为心血管领域的CARDIA研究,包含633个样本、145个分类单元,样本分七个测序批次,以高血压为研究变量,性别、种族为协变量;第二个为整合多个HIV研究的HIVRC数据集,包含61个样本、126个分类单元,以HIV感染状态为研究变量,年龄、性别、BMI为协变量;第三个为整合两个结直肠癌研究的CRC数据集,包含234个样本、166个分类单元,以五分类疾病表型为研究变量,年龄、性别为协变量。结果解读:在CARDIA数据中,校正真实标签得到4个差异分类单元,QuanT识别出3个真阳性和1个假阳性,SVA和RUV未识别出任何真阳性,QuanT预测高血压的ROC曲线下面积优于SVA和未校正,与RUV相当,主坐标分析显示QuanT降低批次效应的效果接近校正真实标签,保留了高血压相关的信号(n=633,P<0.05)。
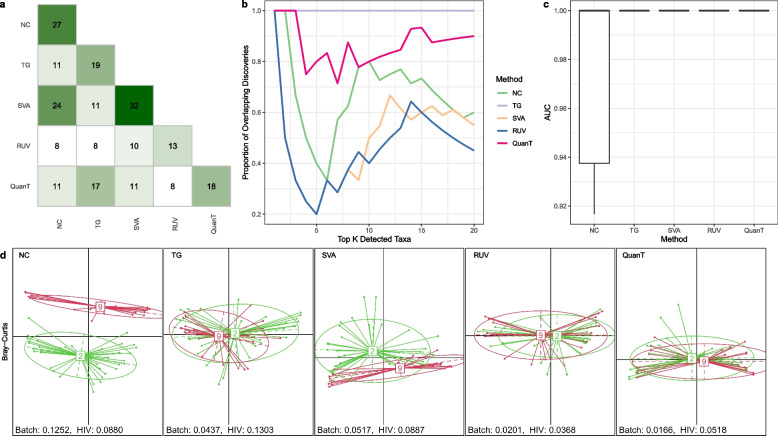
在HIVRC数据中,校正真实标签得到19个差异分类单元,QuanT得到17个真阳性和1个假阳性,错误发现率远低于SVA、RUV和未校正,与金标准结果的一致性最高,PERMANOVA结果显示QuanT对未测量异质性效应的降低幅度最大,预测HIV感染的ROC曲线下面积达到1.00(n=61,P<0.05)。
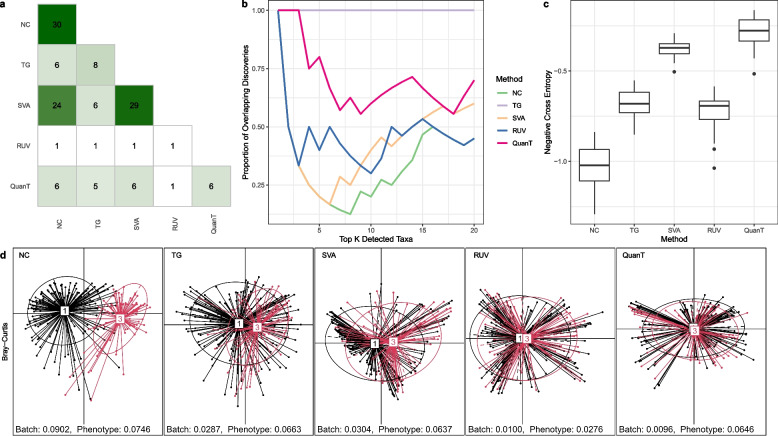
在CRC数据中,校正真实标签得到8个差异分类单元,QuanT得到5个真阳性和1个假阳性,未校正和SVA存在明显的假阳性膨胀,RUV仅得到1个真阳性,QuanT与金标准的一致性最高,预测表型的负交叉熵最高,数据 harmonization 效果接近校正真实标签(n=234,P<0.05)。计算性能方面,QuanT因为需要拟合多个分位数回归,计算速度慢于SVA和RUV,但对于常规规模的微生物组数据集,运行时间仍然在可接受范围,且支持并行计算提升效率。
4. Biomarker研究及发现成果
本文属于微生物组数据分析方法学研究,核心目标是开发未测量异质性的识别校正方法,未开展特定疾病相关生物标志物的筛选与验证研究,无明确研究相关的Biomarker产出。该方法的核心应用价值在于,能够有效降低微生物组差异分析中未测量异质性导致的假阳性,提升微生物组相关生物标志物筛选研究的准确性和可靠性,为后续微生物组Biomarker的发现与验证提供了稳健的方法学工具。推测:未来将QuanT应用于大规模整合微生物组研究,有望帮助发现更多可靠的疾病相关Biomarker。