自闭症患者的分类归纳能力在青春期中期有所提高
Autistic Individuals' Categorical Induction Abilities Improve by Mid-Adolescence
1. 领域背景与文献
文献英文标题:Autistic Individuals’ Categorical Induction Abilities Improve by Mid-Adolescence;
发表期刊:文献未明确提供;影响因子:未公开;研究领域:发育心理学(自闭症谱系障碍认知发展方向)
类别归纳是人类认知发展的核心能力之一,指将已知类别的属性扩展到新成员的推理过程,其发展对个体适应环境、获取知识具有关键作用。领域共识:20世纪80年代,Gelman与Markman的经典研究奠定了类别归纳的理论基础,发现典型发育(TD)幼儿依赖语言标签进行类别属性扩展;90年代Osherson等提出,青少年及成人会结合样本量与多样性线索优化归纳推理,且TD群体的这类能力在9岁后逐渐发展成熟。
在自闭症谱系障碍(ASD)研究领域,现有横断研究多聚焦于儿童阶段,发现自闭症儿童在基础类别归纳任务中的表现显著差于同龄典型发育儿童,部分研究显示13岁自闭症个体开始出现基于多样性线索的推理,但仍落后于典型发育群体。然而,当前研究存在三大核心空白:一是尚未探索13岁以上大龄自闭症个体的类别归纳能力,无法明确其是否能随发展追平典型发育群体;二是未在同一统计模型中对比语言与非语言认知的相对作用,之前的组间差异可能被语言发展水平混淆;三是缺乏纵向研究设计,无法直接验证自闭症个体类别归纳能力的发展变化及早期预测因素。针对这些空白,本研究通过横断与纵向结合的设计,系统探究自闭症青少年的类别归纳能力特征及影响因素,为自闭症认知发展的干预提供理论依据。
2. 文献综述解析
作者按研究对象(典型发育群体、自闭症群体)、研究任务复杂度(基础类别归纳任务、基于多样性/样本量的进阶任务)、研究设计类型(横断研究、纵向研究)三个维度对现有研究进行分类评述,系统梳理了类别归纳能力的发展规律及自闭症群体的认知特征,明确了现有研究在大龄自闭症个体研究、多因素交互分析、纵向发展追踪方面的空白。
现有研究中,典型发育群体的研究显示,幼儿阶段主要依赖语言标签进行类别属性扩展,9岁后逐渐开始使用样本量与多样性线索优化归纳推理,且发展过程中存在显著个体差异,如早期词汇学习能力较强的儿童在5岁时的类别归纳表现更稳定。自闭症群体的研究则表明,儿童在基础类别归纳任务中的表现显著低于典型发育儿童,6.5岁自闭症儿童的属性扩展率与随机水平无差异,10岁自闭症个体在多样性推理任务中仍表现较差,13岁个体虽能完成部分多样性推理,但仍落后于同龄典型发育群体。现有研究的技术方法优势在于通过标准化任务实现了跨群体的可比较性,局限性则体现在:多数研究聚焦于低龄儿童,缺乏对13岁以上大龄自闭症个体的探索;横断研究无法揭示能力的纵向发展变化;未在同一模型中控制语言与非语言认知的交互作用,之前的组间差异可能源于典型发育样本的语言水平超前于实际年龄。
本研究的创新价值在于,首次将研究对象拓展至青少年晚期/青年早期自闭症个体,采用横断与纵向结合的设计,控制语言水平后重新比较组间类别归纳表现,同时明确语言与非语言认知的相对预测作用,填补了大龄自闭症个体类别归纳研究的空白,为自闭症认知发展的“追赶式发展”假说提供了实证支持。
3. 研究思路总结与详细解析
本研究以“自闭症个体类别归纳能力的发展特征及影响因素”为核心科学问题,围绕三个递进式研究目标展开:一是通过横断设计比较青少年晚期自闭症与典型发育个体的类别归纳表现;二是明确表达语言与非语言认知对两类群体类别归纳能力的预测作用及相对权重;三是通过纵向设计验证类别归纳能力的发展变化并探索早期预测因素。整体技术路线遵循“问题提出→多任务行为测试→多维度统计分析→结论推导”的闭环逻辑,结合横断与纵向数据全面揭示自闭症个体类别归纳能力的发展规律。
3.1 研究对象招募与分组
实验目的:建立匹配的典型发育与自闭症纵向研究队列,确保初始阶段两组的表达语言能力匹配,为后续横断与纵向分析提供具有可比性的样本。
方法细节:从“早期语言纵向研究(LSEL)”中选取样本,自闭症儿童通过美国新英格兰地区的自闭症服务机构招募,入组时距诊断不超过6个月且语言表达处于短语前阶段;典型发育儿童通过社区招募,入组时的语言表达特征与自闭症样本匹配。所有入组者的诊断状态通过《自闭症诊断观察量表-通用版(ADOS-G)》确认,初始阶段通过《Mullen早期学习量表(MSEL)》匹配两组的表达语言原始得分。后续横断分析的最终样本为22名典型发育青少年与20名自闭症青少年,纵向分析样本为完成中期与结果期两次测试的亚组。
结果解读:初始阶段,自闭症组的年龄显著大于典型发育组(自闭症组M=32.25个月,n=20;典型发育组M=18.86个月,n=22,P<0.001),但两组的表达语言、接受语言及视觉接收得分无显著差异;青少年时期,两组的年龄匹配(自闭症组M=17.17岁,n=20;典型发育组M=16.32岁,n=22,P=0.349),但典型发育组的语言水平(《临床语言基础评估-第5版(CELF-5)》)与非语言智商(《差异能力量表-II(DAS-II)》)显著高于自闭症组(P<0.001)。
产品关联:文献未提及具体实验产品,领域常规使用自闭症诊断观察量表、Mullen早期学习量表、CELF语言评估量表、DAS智力评估量表等标准化测试工具。
3.2 类别归纳任务设计与实施
实验目的:通过两种不同难度的类别归纳任务,分别评估不同发展阶段的类别归纳能力,其中进阶任务测试基于样本量与多样性线索的推理能力,基础任务测试基于语言标签的属性扩展能力。
方法细节:进阶任务采用Gutheil与Gelman于1997年开发的多样性任务,包含9组自然类别(如蛇、鸟类等),设置三种试次类型:多样组vs同质组(DH)、多样组vs单一个体(DS)、同质组vs单一个体(HS),被试选择更具包容性的选项(即能支持属性扩展到新成员的组)得1分;基础任务采用Gelman与Markman于1987年开发的早期类别归纳任务,包含8组自然类别,被试将目标属性扩展到类别匹配项得1分。所有测试在被试家中完成,任务试次的呈现顺序随机分配。
结果解读:多样性任务的表现不受呈现顺序影响(t(37)=1.03,P=0.309),确保了任务结果的稳定性;早期任务通过统计被试将属性扩展到类别匹配项的正确率,反映基础类别归纳能力。
产品关联:文献未提及具体实验产品,领域常规使用定制化的图片刺激材料、标准化测试脚本。
3.3 横断数据分析(研究问题1与2)
实验目的:比较青少年时期自闭症与典型发育个体的类别归纳表现,明确表达语言与非语言认知对两类群体类别归纳能力的预测作用及相对权重。
方法细节:采用单样本t检验判断两组的类别归纳表现是否显著高于随机水平;采用协方差分析(ANCOVA)控制表达语言水平后,比较两组的类别归纳表现差异;通过组内线性回归分析,分别验证非语言智商、表达语言对类别归纳表现的预测作用;采用卡方检验分析两组在扩展者类型(完美、近乎完美、稳定、中等、非扩展者)上的分布差异;采用混合ANCOVA分析试次类型对两组表现的影响,并检验组间交互作用。
结果解读:单样本t检验显示,两组的类别归纳表现均显著高于随机水平(典型发育组M=74.24%,n=22,P<0.001;自闭症组M=62.78%,n=20,P=0.008);控制表达语言水平后,两组的类别归纳表现无显著差异(F(1,39)=0.24,P=0.629),结果如图1所示。
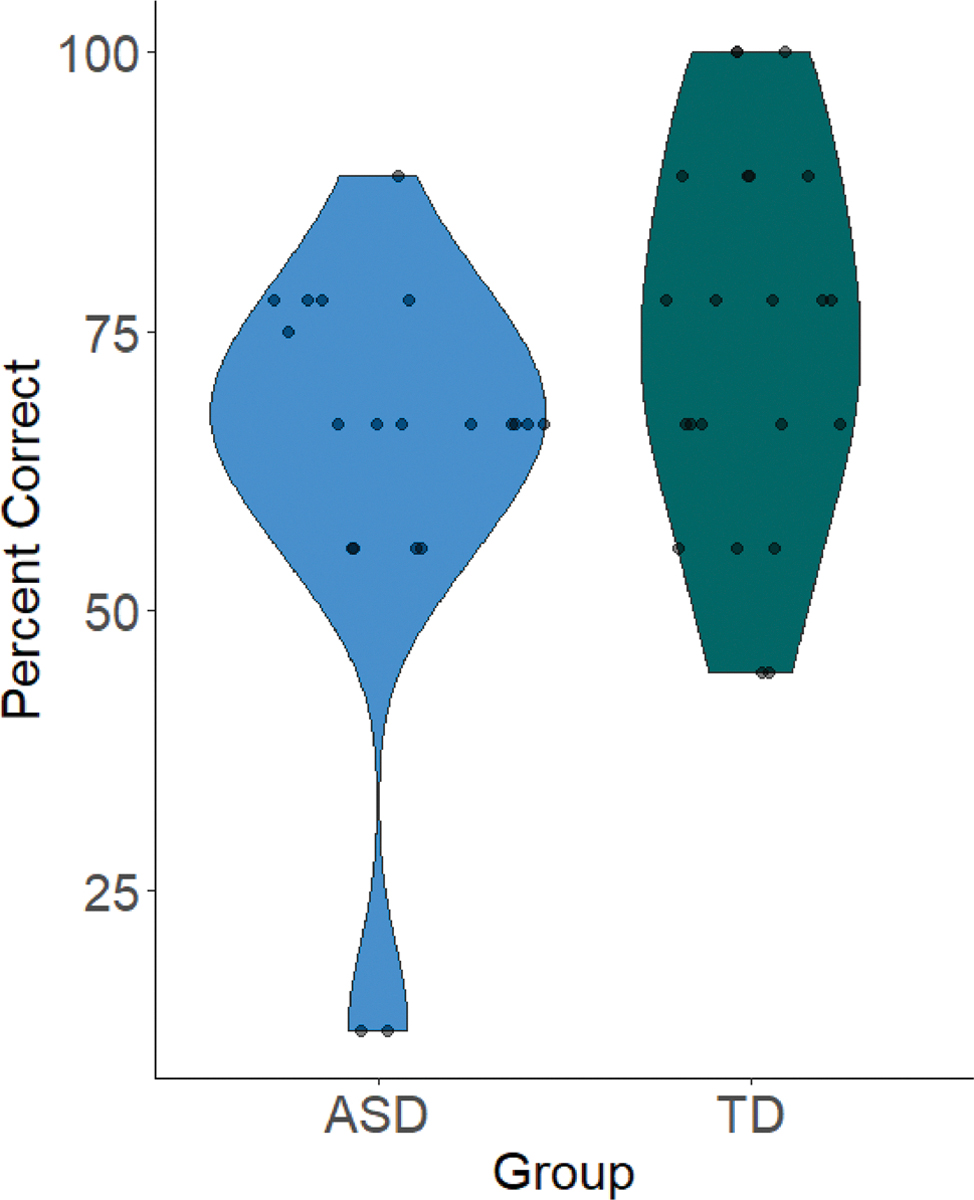
组内回归分析显示,仅纳入非语言智商时,其对两组的类别归纳表现均有显著预测作用;加入表达语言后,表达语言成为唯一显著预测因子,非语言智商的预测作用不再显著:典型发育组每增加1分表达语言得分,类别归纳得分增加0.69(n=22,P=0.028),自闭症组每增加1分表达语言得分,类别归纳得分增加0.73(n=20,P=0.026)。卡方检验显示,两组在扩展者类型的分布上无显著差异(Χ²(4)=5.25,P=0.263),结果如图2所示。
混合ANCOVA显示,试次类型对表现有显著主效应(F(1.87,67.22)=4.60,P=0.015),DH试次得分显著高于DS与HS试次;同时存在组×试次类型的交互作用(F(1.87,67.22)=3.67,P=0.033):典型发育组的DH与DS试次得分无显著差异,均高于HS试次;自闭症组的DH试次得分显著高于DS与HS试次,DS与HS试次得分无差异,结果如图3所示。
产品关联:文献未提及具体实验产品,领域常规使用R语言(tidyverse、ggplot2等包)进行数据统计与可视化。
3.4 纵向数据分析(研究问题3)
实验目的:探究自闭症与典型发育个体类别归纳能力的纵向发展变化,以及早期认知语言因素对能力提升幅度的预测作用。
方法细节:采用2×2混合方差分析(ANOVA),分析组(典型发育/自闭症)与测试时间(中期/结果期)的主效应及交互作用;采用卡方检验比较两组中得分提升的个体比例;通过组内线性回归分析,验证中期的非语言智商与接受语言水平对结果期类别归纳得分变化的预测作用。
结果解读:混合ANOVA显示,测试时间的主效应显著(F(1,31)=16.79,P<0.001),两组的类别归纳得分均从中期到结果期显著提升;组间无显著主效应,也无组×测试时间的交互作用(P=0.578),说明两组的能力提升幅度无差异,结果如图4所示。
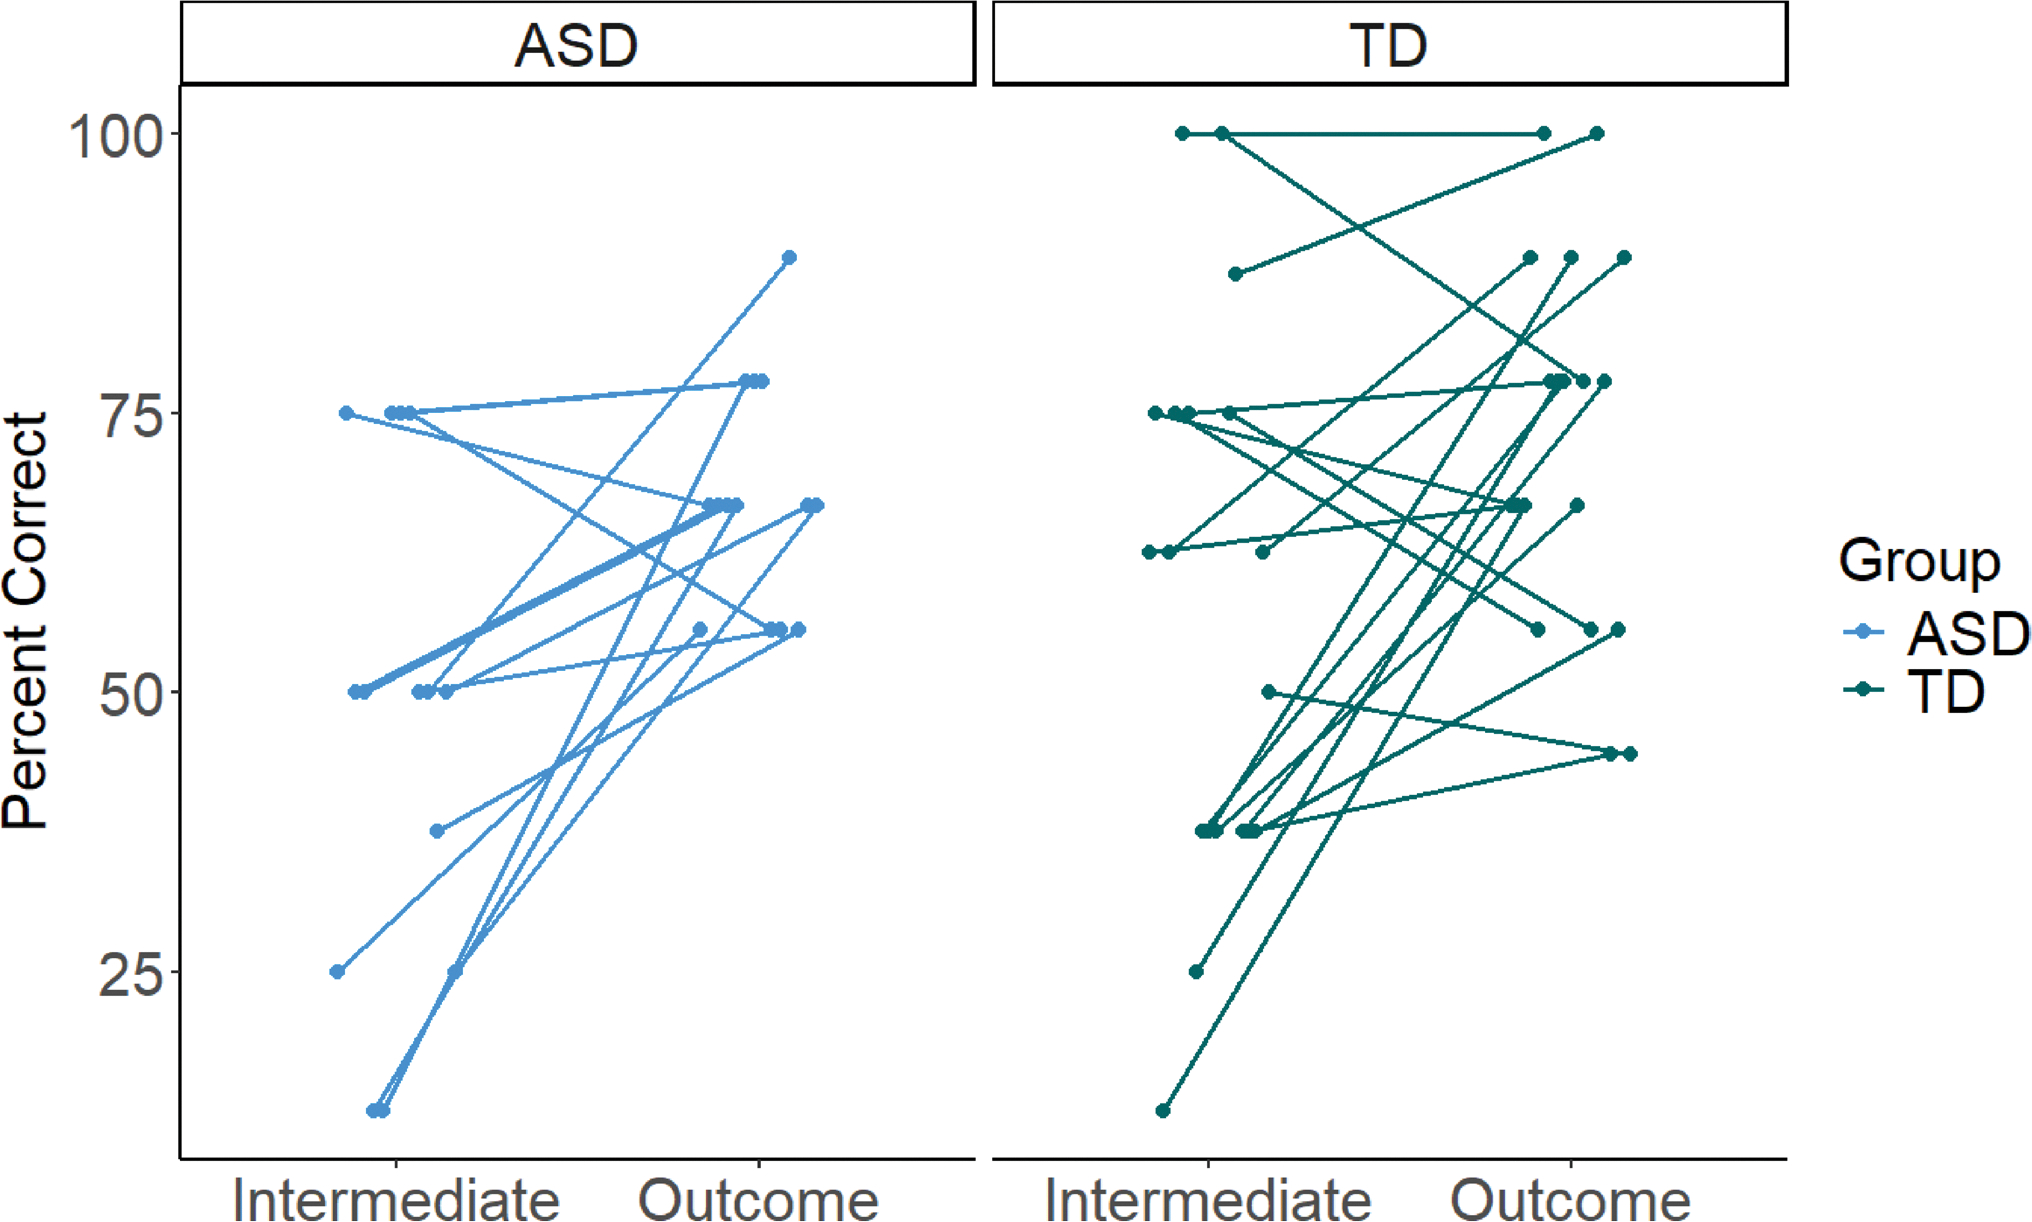
卡方检验显示,自闭症组85.71%(12/14)的个体得分提升,典型发育组68.42%(13/19)的个体得分提升,两组的提升比例无显著差异(Χ²(1)=1.31,P=0.252)。组内回归分析显示,中期的非语言智商与接受语言水平均不能预测结果期的类别归纳得分变化。
产品关联:文献未提及具体实验产品,领域常规使用纵向追踪研究设计、重复测量统计分析方法。
4. Biomarker研究及发现成果
本研究将“表达语言能力”作为自闭症与典型发育个体类别归纳能力的关键认知标志物,通过横断回归分析明确其预测作用,通过纵向追踪验证其与能力发展的关联,为理解自闭症认知发展的潜在机制及干预靶点提供了新的依据。
Biomarker定位与筛选逻辑
本研究中的核心认知标志物为“表达语言能力”,筛选逻辑基于现有研究中语言与类别归纳的关联,通过横断回归分析验证其在控制非语言认知后的独立预测作用,通过纵向追踪探索其与能力发展的长期关联,形成“理论假设→横断验证→纵向拓展”的完整逻辑链条。
研究过程详述
该标志物的来源为青少年时期的《临床语言基础评估-第5版(CELF-5)》总分,验证方法为组内分层线性回归分析:首先以非语言智商为预测因子,发现其能显著预测类别归纳表现;加入表达语言后,表达语言成为唯一显著预测因子,非语言智商的预测作用被完全掩盖。特异性方面,表达语言对自闭症组的预测系数(β=0.74,n=20,P=0.026)略高于典型发育组(β=0.52,n=22,P=0.028),说明表达语言对自闭症个体类别归纳能力的影响更为显著;敏感性方面,控制表达语言后,两组的类别归纳表现无显著差异,进一步证明表达语言是组间差异的核心来源。
核心成果提炼
该认知标志物的功能关联在于,它是自闭症与典型发育个体类别归纳能力的共同预测因子,且对自闭症个体的影响更为突出;创新性在于首次明确了表达语言在大龄自闭症个体类别归纳中的主导作用,证明控制语言水平后自闭症个体的类别归纳表现与典型发育个体无差异,推翻了之前认为自闭症个体类别归纳能力持续落后的结论。纵向研究成果显示,自闭症与典型发育个体的类别归纳能力均随年龄显著提升,提升幅度无组间差异,说明自闭症个体的类别归纳能力存在“追赶式发展”的可能。文献未提供该标志物的ROC曲线等敏感性特异性量化数据,基于回归系数可推测其对类别归纳表现的解释力较强(典型发育组模型R²=0.39,自闭症组模型R²=0.48)。