

1. 领域背景与文献
文献英文标题:Validation of the postoperative prognostication tool PREDICT version 2.2 and 3.0 using data from the National cancer center hospital in Japan;
发表期刊:文献未明确提供;影响因子:未公开;研究领域:肿瘤学-乳腺癌术后预后工具临床验证
全球范围内,乳腺癌是发病率最高的恶性肿瘤,也是癌症相关死亡的主要原因之一,预计到2040年新发病例将达300万,死亡病例将达100万。在日本,乳腺癌的发病率居所有癌症首位,死亡率位列第三,且发病率和死亡率呈持续上升趋势。随着乳腺癌治疗手段的多样化,个性化医疗需求日益迫切,术后预后评估工具在临床决策中的作用愈发关键,这类工具不仅能辅助临床医生评估不同治疗方案的潜在获益,还能帮助患者明确治疗路径,推动医患共同决策。
PREDICT是2010年由英国剑桥大学团队开发的免费在线术后乳腺癌预后工具,历经多次版本更新,逐步纳入HER2状态、Ki-67表达、孕激素受体(PR)状态等核心变量,2024年发布的3.0版本新增诊断年份、吸烟状态、PR状态等输入变量,并纳入放疗的治疗效应及非乳腺癌死亡风险,基于美国监测、流行病学与最终结果(SEER)数据库的验证显示其校准性能及长期生存预测准确性显著提升。近年来,PREDICT在亚洲人群中的验证研究逐渐开展,但结果存在地域差异:印度队列中2.2版本低估5年总生存(OS),尤其在年轻患者、高分级肿瘤等亚组中差异显著;马来西亚队列中2.2版本的5年OS预测与实际结果高度一致;中国队列中3.0版本的校准性能显著优于2.2版本,尤其在雌激素受体(ER)阴性患者中;日本此前仅完成了2.2版本的验证,尚未开展3.0版本的外部验证,也未在同一队列中直接对比两个版本的性能,无法明确两者在日本人群中的适用场景差异。因此,本研究旨在填补这一空白,通过日本国立癌症中心的大样本回顾性队列,验证两个版本的预后评估性能并对比差异,为临床预后工具的选择提供依据。
2. 文献综述解析
本研究综述部分按地域(西方、亚洲不同国家)及PREDICT版本维度,系统梳理了现有预后工具的研究进展及PREDICT的验证情况,明确了日本人群中两个版本对比研究的核心空白。
现有研究显示,PREDICT在英国、美国、加拿大等西方多个国家的验证中表现出良好的预后评估能力,版本更新逐步优化了模型的预测准确性:2.2版本整合了年龄、ER状态、HER2状态、Ki-67表达等临床病理变量及内分泌治疗、化疗、靶向治疗等治疗变量,可预测5年、10年、15年OS及辅助治疗的生存获益;3.0版本在2.2版本基础上新增诊断年份、吸烟状态、PR状态等变量,并纳入放疗的治疗效应及心脏剂量相关风险,基于美国SEER数据库的验证显示其校准性能及长期生存预测准确性较2.2版本提升。在亚洲人群中,不同国家的验证结果存在明显异质性:印度队列中2.2版本低估5年OS,尤其在<40岁患者、3级肿瘤、淋巴结阳性、三阴性乳腺癌亚组中差异显著;马来西亚队列中2.2版本的5年OS预测与实际结果一致,校准和区分性能良好;中国队列中3.0版本的校准性能显著优于2.2版本,尤其在ER阴性患者中;日本此前的研究显示2.2版本可可靠预测5年和10年OS,但在≥65岁、3级肿瘤、 Luminal A型肿瘤及仅接受内分泌治疗或未接受系统治疗的亚组中低估长期预后。
现有研究的局限性在于,日本缺乏3.0版本的外部验证,且尚未在同一队列中直接对比2.2和3.0版本的性能,无法明确两个版本在日本人群中的适用场景差异,也无法为临床选择更合适的预后工具提供直接依据。因此,本研究的创新点在于首次利用日本国立癌症中心的大样本回顾性队列,同时验证两个版本的校准和区分性能,明确两者在日本术后乳腺癌患者中的性能差异及适用场景,为临床预后评估工具的选择提供循证依据。
3. 研究思路总结与详细解析
本研究的核心目标是验证PREDICT 2.2和3.0版本在日本术后乳腺癌患者中的预后评估性能,对比两者的校准(预测值与实际结果的一致性)和区分(区分生存与死亡患者的能力)能力;核心科学问题是两个版本是否适用于日本人群,以及两者的性能差异对应的临床适用场景;技术路线为:回顾性队列筛选→模型输入数据处理与缺失值填充→利用R包计算预测生存概率→校准性能评估→区分性能评估→结果分析与结论,形成完整的研究闭环。
3.1 回顾性队列构建与患者特征分析
实验目的:构建符合PREDICT模型纳入标准的日本术后乳腺癌患者回顾性队列,明确队列的基线临床病理特征,为后续模型验证提供基础。
方法细节:筛选日本国立癌症中心2006-2016年接受手术的原发性乳腺癌患者,排除男性乳腺癌、双侧乳腺癌、IV期病变、非浸润性癌、接受新辅助治疗及年龄不在25-85岁范围内的患者,最终纳入2980例患者;按ER状态分层,收集患者的年龄、肿瘤分级、肿瘤大小、淋巴结状态、治疗方案等基线特征数据,统计中位随访时间、总人年数等随访信息。
结果解读:队列中ER阳性患者占82.7%(n=2464),ER阴性患者占17.3%(n=516);所有患者的中位诊断年龄为55岁,ER阳性患者中位诊断年龄为54岁,ER阴性患者为59岁;中位随访时间为7.0年,总人年数为21581年;Ki-67状态在44.6%的患者中未知,其余临床病理变量(ER状态、HER2状态、PR状态等)均完整。
产品关联:文献未提及具体实验产品,领域常规使用电子病历系统进行患者临床病理数据的提取与整理。
3.2 PREDICT模型输入数据处理与生存概率计算
实验目的:完成PREDICT 2.2和3.0版本的输入数据整理与缺失值填充,计算患者术后1-10年的预测生存概率。
方法细节:针对两个版本的输入变量差异,对缺失数据进行标准化填充:双膦酸盐使用情况统一设为“无”,Ki-67缺失设为“未知”,3.0版本新增的吸烟状态统一设为“无”,放疗平均心脏剂量按肿瘤侧别填充(右侧肿瘤为0Gy,左侧肿瘤为2Gy);使用对应版本的开源R包(2.2版本来自Winton Centre的GitHub仓库,3.0版本来自Peng实验室的GitHub仓库)编写分析脚本,计算每位患者术后1-10年的预测生存概率。
结果解读:成功完成所有患者的输入数据处理,获得两个版本的1-10年预测生存概率数据集,为后续校准和区分性能评估提供核心数据支撑。
产品关联:文献未提及具体实验产品,领域常规使用R语言及相关开源统计包进行临床预测模型的数据分析与计算。
3.3 模型校准性能评估
实验目的:评估PREDICT 2.2和3.0版本的校准性能,即预测生存概率与实际生存结果的一致性。
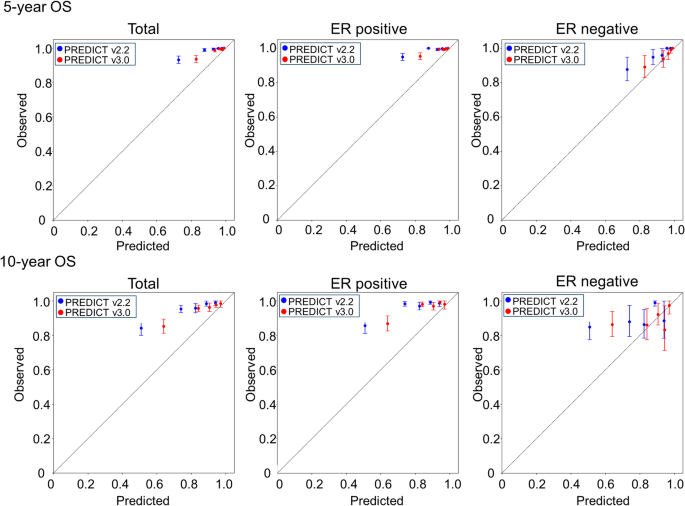
方法细节:采用Kaplan-Meier法计算观察到的5年和10年OS,将患者按预测OS分为五等分,绘制校准图对比观察值与预测值的差异;同时按ER状态分层,分析不同亚组中两个版本的校准性能差异。
结果解读:两个版本均存在低估生存概率的趋势,但3.0版本的预测值与实际值的一致性显著优于2.2版本:在ER阳性组,观察到的5年OS为98.8%,2.2版本预测为91.8%,3.0版本预测为95.5%;观察到的10年OS为96.0%,2.2版本预测为80.5%,3.0版本预测为87.9%;在总队列和ER阳性队列中,3.0版本的校准性能提升尤为明显,ER阴性队列中3.0版本的校准表现也优于2.2版本,与校准图的结果一致。
产品关联:文献未提及具体实验产品,领域常规使用R语言survival包等工具进行Kaplan-Meier生存分析与校准图绘制。
3.4 模型区分性能评估
实验目的:评估PREDICT 2.2和3.0版本的区分性能,即模型区分生存与死亡患者的能力。
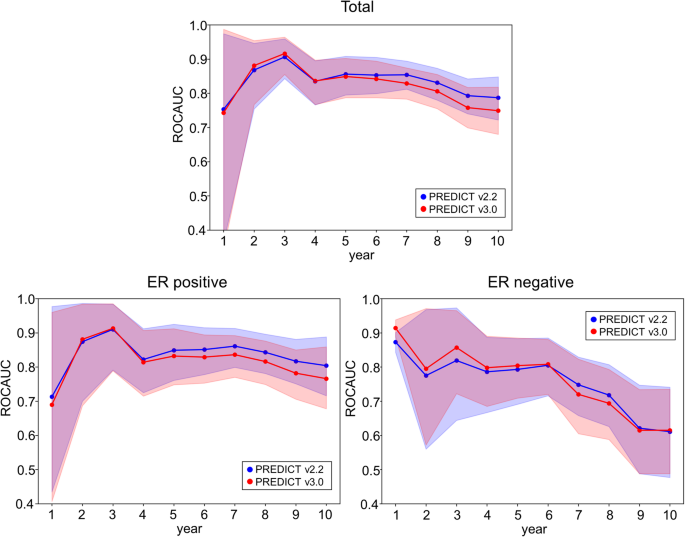
方法细节:采用时间依赖受试者工作特征(ROC)曲线分析,通过逆概率删失加权(IPCW)法计算曲线下面积(AUC),生成1000个bootstrap样本估计95%置信区间(CI),评估术后1-10年的区分性能;同时按ER状态分层,分析不同亚组中两个版本的区分性能差异。
结果解读:总队列和ER阳性队列中,两个版本在10年内均保持良好的区分性能,AUC普遍高于0.80;2.2版本在5年后的AUC略高于3.0版本;ER阴性队列中,两个版本的AUC在5年后逐渐下降,波动更大,区分性能较ER阳性组差。
产品关联:文献未提及具体实验产品,领域常规使用R语言timeROC包等工具进行时间依赖ROC曲线分析。
4. Biomarker研究及发现成果
本研究中PREDICT 2.2和3.0作为基于多变量的术后乳腺癌预后预测模型,其验证过程本质是对这类预后评估工具的性能评估,本研究明确了两个模型在日本人群中的适用性及性能差异,为临床预后工具的选择提供核心依据。
本研究的预后预测模型的验证逻辑为:基于西方人群开发的多变量预后模型,在日本术后乳腺癌患者的回顾性队列中进行外部验证,通过校准和区分性能评估其在东亚人群中的适用性。模型的输入变量来源为患者的临床病理数据(年龄、ER状态、HER2状态、肿瘤分级、淋巴结状态等)及治疗数据(内分泌治疗、化疗、靶向治疗、放疗等),验证方法包括Kaplan-Meier法计算实际生存概率、校准图评估预测值与实际值的一致性、时间依赖ROC曲线评估模型区分生存与死亡患者的能力。特异性与敏感性数据方面,总队列中两个版本的5年OS预测AUC均高于0.80(文献未明确提供具体数值,基于图表趋势推测),10年OS预测AUC在ER阳性组仍维持较高水平,ER阴性组因病例异质性较强,AUC有所下降。
核心成果:两个版本均能在日本术后乳腺癌患者中提供满意的预后评估,3.0版本的校准性能显著优于2.2版本,预测值与实际生存结果的一致性更高,更适合用于医患共同决策场景;2.2版本在5年后的区分性能略优于3.0版本,更适合用于患者的风险分层;5年OS的预测性能支持两个版本在日本人群中的推广性,但10年预测因删失病例较多(10年时删失病例达2316例,n=2980)需谨慎解读;本研究首次在同一日本队列中对比两个版本的性能,明确了各自的适用场景,为临床预后工具的选择提供了直接循证依据,同时也提示未来需开发针对日本人群的优化模型,进一步提升预后评估的准确性。