

1. 领域背景与文献
文献英文标题:A Novel Approach to Ovarian Cancer Diagnosis via CT Imaging: GPT-4o-Driven Automated Feature Recognition and Validation in Clinical Settings;
发表期刊:《Annals of Surgical Oncology》;影响因子:未公开;研究领域:妇科肿瘤学、医学影像人工智能
卵巢癌是全球女性第八大常见癌症,2022年占新发癌症病例的3.4%、癌症相关死亡的4.8%,是妇科肿瘤中死亡率最高的类型,其核心原因在于早期症状不典型且缺乏可靠的早期诊断生物标志物,55%的患者初诊时已处于转移性阶段,5年生存率仅31.4%;而当肿瘤局限于卵巢或输卵管(FIGO I期)时,5年生存率可超过90%,因此早期精准诊断是改善卵巢癌患者预后的关键。目前卵巢癌确诊的金标准是手术切除后的组织病理学检查,但该方法仅能在术后实施,术前亟需可靠的评估手段指导临床决策。盆腔计算机断层扫描(CT)是疑似卵巢癌患者术前评估的常规影像工具,其关键特征(囊壁与间隔状态、结节或乳头状突起、密度与强化分布、囊实性特征)是鉴别良恶性卵巢肿块的核心依据,但传统影像解读高度依赖医生经验,存在观察者间差异。领域共识:传统人工智能模型(如卷积神经网络)虽可辅助影像诊断,但存在“黑箱”效应、依赖大规模标注数据集、需要专业工程知识构建模型的局限,难以在基层医疗机构推广。视觉大语言模型如GPT-4o的出现为解决上述问题提供了新方向,本研究旨在评估其自动识别卵巢癌CT特征并辅助临床诊断的性能,填补了视觉大语言模型在妇科肿瘤影像诊断领域的研究空白。
2. 文献综述解析
作者将现有卵巢癌诊断相关研究分为三类:一是基于手术病理的确诊金标准研究,二是基于医学影像的人工解读研究,三是基于人工智能的影像辅助诊断研究,其中第三类进一步细分为传统机器学习/深度学习模型与新兴视觉大语言模型研究。
现有研究中,手术病理诊断是卵巢癌确诊的唯一金标准,但无法满足术前快速评估的需求;医学影像人工解读是术前评估的核心手段,但受医生经验影响大,诊断一致性不足;传统人工智能模型可通过提取影像特征提升诊断效率,但其输出缺乏可解释性,且依赖大规模精准标注的数据集,样本量不足时易出现过拟合,同时需要专业工程人员参与模型构建,技术门槛较高,难以在基层医疗机构普及。
本研究的创新价值在于首次将GPT-4o视觉大语言模型应用于卵巢癌CT诊断,通过10-shot少量样本训练即可掌握良恶性卵巢病变的CT特征差异,输出包含具体影像特征的可解释性诊断报告,无需专业神经网络构建知识,解决了传统AI模型的“黑箱”问题与技术门槛高的局限;同时验证了该模型对经验不足的妇科肿瘤医生的诊断辅助作用,为卵巢癌早期诊断提供了一种易推广、可解释的新工具,弥补了现有研究中AI模型临床可及性不足的缺陷。
3. 研究思路总结与详细解析
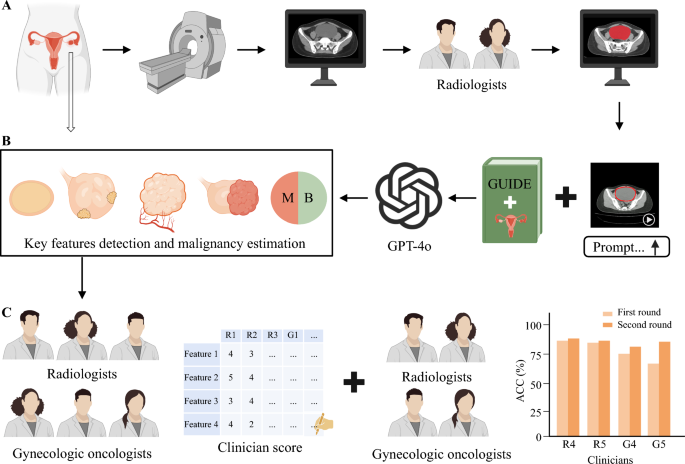
本研究的核心目标是评估GPT-4o基于盆腔CT图像自动识别早期卵巢癌高危特征并辅助临床诊断的性能,核心科学问题包括GPT-4o能否准确识别卵巢癌的4项关键CT特征、其诊断性能与临床专家的差异,以及能否提升不同经验层级医生的诊断准确性;研究采用“多中心队列构建→CT图像标准化预处理→GPT-4o少量样本训练→诊断性能与特征一致性评估→重测实验验证重复性与辅助价值→统计分析”的闭环技术路线,通过多中心临床样本与对照实验确保结果的可靠性。
3.1 研究设计与患者队列构建
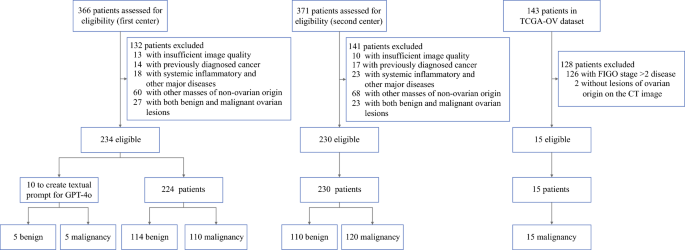
实验目的是建立标准化的临床研究队列,确保纳入样本符合早期卵巢癌与良性病变的诊断标准,为后续模型评估提供可靠数据基础。方法细节为从两家医疗机构纳入2018年7月至2024年6月期间,年龄≥18岁、拥有完整术前薄层盆腔CT图像、经病理确诊为FIGO I期卵巢癌或良性卵巢病变的患者,同时纳入The Cancer Imaging Archive(TCIA)数据库中TCGA-OV队列的早期卵巢癌患者;排除图像质量不佳、有既往癌症史、合并系统性炎症或其他重大疾病、存在非卵巢来源肿块或同时患有良恶性卵巢病变的患者。结果解读为最终纳入479例患者,其中82例(17.12%)为多原发灶,397例(82.88%)为单原发灶,平均病灶大小为9.23±5.32 cm(n=479);74例(15.45%)为平扫CT,405例(84.55%)为增强CT,共生成479个平均时长31.00秒的CT视频。产品关联:文献未提及具体实验产品,领域常规使用ITK-SNAP图像分割软件、Python视频处理工具、R统计分析软件。
3.2 CT图像预处理与GPT-4o模型训练
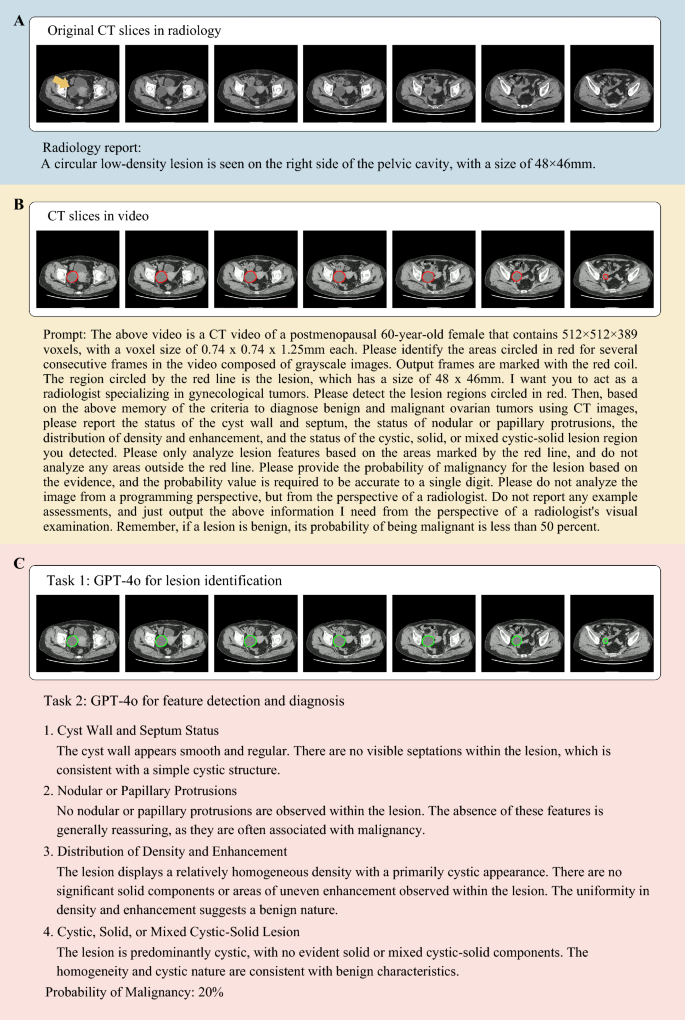
实验目的是为GPT-4o构建标准化的输入数据格式,并通过少量样本训练使其掌握卵巢癌良恶性病变的CT特征差异。方法细节为由两位拥有10年以上临床经验的妇科肿瘤医生和放射科医生共同阅片,确定病灶边界后,使用ITK-SNAP软件(3.6.0版)手动分割病灶;将CT切片按头足方向转换为视频,测试5、10、15、20帧/秒四种帧率后,确定5帧/秒为最优帧率(病灶识别准确率最高);在CT切片上用5像素宽度的红色标记病灶边界;选取10例患者(5例FIGO I期卵巢癌、5例良性病变)的CT视频、放射报告及病理结果对GPT-4o进行10-shot训练,同时提供基于临床指南的卵巢癌CT诊断特征标准。结果解读为GPT-4o可100%识别专家标注的479例患者的病灶区域,完成训练后可按照要求识别4项关键CT特征并输出良恶性诊断结论。产品关联:文献未提及具体实验产品,领域常规使用OpenAI GPT-4o模型、ITK-SNAP图像分割软件。
3.3 GPT-4o诊断性能与临床专家评估
实验目的是评估GPT-4o的诊断准确性,以及其识别的CT特征与临床专家判断的一致性,同时验证其输出的临床实用性。方法细节为让GPT-4o对所有纳入患者的CT视频进行分析,识别囊壁与间隔状态、结节或乳头状突起、密度与强化分布、囊实性特征4项关键CT特征,并给出良恶性诊断;由3位放射科医生(22年、8年、7年经验)和3位妇科肿瘤医生(16年、10年、3年经验)独立阅片诊断,同时对GPT-4o输出的特征描述进行5分制一致性评分,评估其输出的不适当内容、缺失内容及潜在危害风险。结果解读为GPT-4o整体诊断准确率为79.96%,在三家数据集分别为80.80%(第一中心,n=224)、79.14%(第二中心,n=230)、93.33%(TCGA-OV队列,n=15);与临床专家相比,其准确率略低于拥有7年以上经验的放射科医生(84.35%-87.83%),但与拥有10年经验的妇科肿瘤医生(77.23%)相当;4项CT特征的专家平均一致性评分为4.25/5,其中密度与强化分布的一致性最高(4.30±0.77,n=6),囊壁与间隔状态的一致性最低(4.22±0.75,n=6);专家对GPT-4o输出的临床实用性评估显示,不适当内容平均评分为2.38±0.73,缺失内容为2.75±0.56,潜在危害为2.59±0.72,整体风险较低。产品关联:文献未提及具体实验产品,领域常规使用临床指南作为诊断标准参考。
3.4 重测实验验证模型重复性与辅助诊断价值
实验目的是验证GPT-4o诊断结果的可重复性,以及其对不同经验层级临床医生诊断准确性的提升作用。方法细节分为两部分:一是从纳入患者中随机选取50例,间隔2周后重复输入GPT-4o,对比两次诊断结果的一致性,并由两位妇科肿瘤医生对特征描述的重复性进行0-100%评分;二是选取2位放射科医生(9年、11年经验)和2位妇科肿瘤医生(6年、2年经验),先在无GPT-4o辅助下独立诊断,间隔2周洗脱期后,结合GPT-4o的输出再次诊断,对比两次诊断的准确率与AUC差异。结果解读为GPT-4o诊断结果的重复性为90.00%(45/50),4项CT特征中密度与强化分布的重复性最高(79.98%),囊壁与间隔状态的重复性最低(71.62%);无GPT-4o辅助时,4位医生的诊断准确率分别为85.65%、83.91%、73.66%、67.86%,结合GPT-4o辅助后,准确率提升至87.83%、85.65%、78.13%、84.38%,其中两位经验不足的妇科肿瘤医生的诊断AUC从0.74、0.68提升至0.78、0.85,差异具有统计学显著性(P=0.003、P<0.001),而放射科医生的AUC提升无统计学显著性(P=0.23、P=0.52)。产品关联:文献未提及具体实验产品,领域常规使用临床诊断评估的标准流程。
3.5 统计分析
实验目的是通过标准化统计方法量化评估GPT-4o与临床专家的诊断性能差异,验证结果的统计学可靠性。方法细节为采用受试者工作特征曲线下面积(AUC)评估诊断准确性,使用DeLong检验比较GPT-4o与临床专家的AUC差异;计算诊断准确率、特异性、敏感性,采用95%置信区间(CI)表示结果;采用加权kappa系数评估临床专家对GPT-4o输出评分的一致性。结果解读为GPT-4o的诊断AUC为0.80,与3位放射科医生的AUC(0.84-0.88)相比差异具有统计学显著性(P<0.05),与3位妇科肿瘤医生的AUC(0.76-0.85)相比无统计学显著性(P>0.05);临床专家对GPT-4o特征描述评分的加权kappa系数显示,放射科医生的一致性为0.45-0.51(中等),妇科肿瘤医生的一致性为0.08-0.25(较差),整体一致性水平有待提升。产品关联:文献未提及具体实验产品,领域常规使用R软件(4.0.3版)进行统计分析。
4. Biomarker研究及发现成果解析
本研究涉及的Biomarker分为两类:一是卵巢癌的4项关键CT影像特征(囊壁与间隔状态、结节或乳头状突起、密度与强化分布、囊实性特征),二是GPT-4o作为数字化辅助诊断工具的诊断性能;筛选与验证逻辑为基于临床指南确定核心CT特征,通过GPT-4o自动识别,经临床专家一致性评估、多中心样本验证及重测实验验证其可靠性与辅助价值,形成“指南筛选→模型识别→专家验证→临床辅助”的完整逻辑链条。
Biomarker的来源为纳入患者的术前盆腔CT图像(平扫或增强),验证方法包括:一是由GPT-4o自动识别特征并输出诊断,与病理结果对比评估诊断准确性;二是由6位临床专家对GPT-4o识别的特征进行5分制一致性评分;三是通过重测实验验证特征识别的重复性。特异性与敏感性方面,GPT-4o的整体诊断准确率为79.96%(n=479),AUC=0.80(95% CI未明确提供,基于图表趋势推测),其中TCGA-OV队列的准确率最高(93.33%,n=15);4项CT特征的专家平均一致性评分为4.25/5(n=6)。
核心成果提炼:本研究首次验证了GPT-4o可自动识别卵巢癌的4项关键CT影像特征,其诊断性能与拥有10年临床经验的妇科肿瘤医生相当(准确率77.23% vs 79.96%,P>0.05);创新性在于将视觉大语言模型应用于卵巢癌CT诊断,无需专业神经网络构建知识,输出的特征描述具有可解释性,可显著提升经验不足的妇科肿瘤医生的诊断AUC至0.78-0.85(P<0.01);该Biomarker组合(CT特征+GPT-4o识别)的临床价值在于可作为术前辅助诊断工具,尤其在缺乏专业放射科医生的基层医疗机构,提升卵巢癌早期诊断的准确性,进而改善患者预后,为卵巢癌早期诊断的普及提供了新的可行路径。