

1. 领域背景与文献
文献英文标题:St. Gallen International Breast Cancer Consensus-Based Clinical Decision Validation: Concordance Assessment Between Deep Large Language Model Outputs and Global Expert Panel Recommendations;
发表期刊:(文献未明确提供);影响因子:(文献未明确提供);研究领域:乳腺癌临床决策、医学人工智能
领域共识:乳腺癌是全球女性最常见的恶性肿瘤之一,具有高度异质性,包含多种分子亚型且治疗方案复杂多样,严重威胁女性健康。随着新型治疗手段的不断迭代,乳腺癌各亚型的患者生存率得到显著提升,但临床医生需持续整合海量最新研究成果与共识指南,才能为患者制定个体化治疗策略。目前,美国临床肿瘤学会(ASCO)、欧洲肿瘤内科学会(ESMO)、美国国家综合癌症网络(NCCN)、圣加仑国际乳腺癌会议(SG-BCC)等国际组织定期发布循证临床实践指南,为乳腺癌诊疗提供专家指导,但临床医生在应用这些复杂且不断更新的共识时面临诸多挑战,尤其是在多学科肿瘤讨论或罕见病例管理中,需耗费大量时间梳理临床数据与指南信息。近年来,以大语言模型(LLM)为代表的人工智能技术在医疗领域展现出巨大应用潜力,可快速整合指南信息与临床数据,辅助多学科讨论,为医疗资源有限地区提供标准化临床参考,同时可作为教育工具提升医护人员培训效率与患者健康认知。但大语言模型的临床应用价值依赖于其能否一致且准确地复现专家共识,因此在常规临床应用前需严格评估其与既定临床标准的契合度。现有研究表明,新型高性价比大语言模型DeepSeek在其他医疗领域表现良好,但针对其在乳腺癌临床决策中与国际专家共识一致性的系统评估较为匮乏,且其两个版本(DeepSeek-V3、DeepSeek-R1)在乳腺癌临床决策中的适用性尚不明确,同时缺乏与主流大语言模型(Gemini 2.0 Pro、ChatGPT-4o)的多维度性能对比,这一研究空白促使本研究开展专项评估,为DeepSeek在乳腺癌临床决策中的应用提供科学依据。
2. 文献综述解析
本文献综述部分围绕大语言模型在医疗领域的应用现状及乳腺癌临床决策的实践挑战展开,作者以大语言模型的临床应用核心需求为分类维度,梳理了现有研究的成果与局限性,明确了本研究的创新方向与学术必要性。
现有研究显示,大语言模型可高效整合复杂临床数据与权威指南信息,快速生成标准化的诊疗参考建议,辅助多学科肿瘤讨论的筹备工作,为医疗资源匮乏地区提供可及性强的临床决策支持,同时可作为交互式教育工具提升医护人员的培训效率与患者的健康认知水平。但现有研究存在明显局限性:一是针对大语言模型在乳腺癌临床决策领域的专项评估较为匮乏,尤其是缺乏对新型模型DeepSeek的系统研究;二是未充分关注大语言模型回答的鲁棒性这一关键临床应用指标,而鲁棒性直接关系到模型输出的可靠性与稳定性,是临床应用的核心前提;三是现有研究未分层分析不同临床场景、证据水平下的模型性能差异,无法为模型的精准应用提供细分依据。本研究的创新价值在于,首次以圣加仑国际乳腺癌会议的专家共识为金标准,系统评估DeepSeek两个版本在乳腺癌临床决策中的一致性与鲁棒性,并与当前主流大语言模型(Gemini 2.0 Pro、ChatGPT-4o)进行多维度对比,同时分层分析了不同问题类型、临床主题、证据水平下的模型性能差异,填补了新型大语言模型在乳腺癌临床决策领域评估的研究空白,为其临床应用场景的选择与优化提供了关键依据。
3. 研究思路总结与详细解析
本研究的整体框架为“基准确立→标准化测试→多维度评估→分层验证→结论总结”的闭环逻辑,研究目标是明确DeepSeek模型在乳腺癌临床决策中与圣加仑专家共识的一致性及鲁棒性,对比其与主流大语言模型的性能差异;核心科学问题是DeepSeek能否准确复现国际专家的乳腺癌临床决策共识,其鲁棒性是否具备临床应用的核心优势;技术路线以139个圣加仑会议共识问题为测试集,对4款大语言模型进行标准化测试,通过一致性率、鲁棒性等量化指标评估性能,并开展多维度分层分析验证结果的可靠性与普适性。
3.1 研究问题集构建与专家共识基准确立
实验目的:构建具有临床代表性的标准化乳腺癌临床决策测试问题集,确立国际专家共识的基准参考,为大语言模型的性能评估提供统一、权威的对比标准。
方法细节:从第19届圣加仑国际乳腺癌会议的共识投票结果中筛选测试问题,排除大语言模型无法回答的既往临床实践选择类问题后,最终纳入139个具有明确选项的共识问题;同时基于会议专家小组的投票结果建立专家共识基准,以每个问题中得票率最高的选项作为模型输出的参考标准。
结果解读:纳入的139个问题覆盖乳腺癌诊断与治疗的9个核心临床领域,按问题类型分为二元问题(n=37,占26.62%)与非二元问题(n=102,占73.38%),全面反映了乳腺癌临床决策的核心场景,为大语言模型的多维度性能评估提供了科学的测试基础。
产品关联:文献未提及具体实验产品,领域常规使用国际权威会议的共识资料构建临床决策测试数据集。
3.2 大语言模型测试方案设计
实验目的:制定标准化的大语言模型测试流程,确保测试结果的客观性、可比性与可重复性,消除测试过程中的潜在偏倚。
方法细节:选取2024年3月15日前发布的4款代表性大语言模型,包括DeepSeek的两个版本(通用型DeepSeek-V3、优化复杂推理的DeepSeek-R1)、Gemini 2.0 Pro及ChatGPT-4o;通过模型官方应用程序接口(API)或公开在线平台进行测试,测试前限定模型仅使用2025年3月15日前的知识,并提供NCCN乳腺癌临床实践指南(2025第3版)与中国临床肿瘤学会(CSCO)乳腺癌诊疗指南(2024版)作为参考依据;将每个共识问题格式化为标准化指令,要求模型基于指定指南选择对应选项,每个问题独立测试5次,若未出现最频繁答案则追加第6次测试,每次测试启动新对话以消除记忆干扰,将多次测试中出现次数最多的答案定义为“最频繁答案”。
结果解读:通过标准化的测试流程与严格的偏倚控制措施,获得了4款大语言模型针对139个问题的稳定输出结果,初步对比显示DeepSeek-V3的一致性率与鲁棒性均优于DeepSeek-R1,因此被选为后续对比分析的核心模型。
产品关联:文献未提及具体实验产品,领域常规使用大语言模型官方API接口开展标准化性能测试。
3.3 评估指标定义与统计分析方法
实验目的:定义科学、全面的评估指标体系,采用规范的统计分析方法,确保大语言模型性能评估的准确性、可靠性与统计学严谨性。
方法细节:设定四项核心评估指标:一致性率(模型最频繁答案与专家得票最高选项的匹配比例,反映模型与专家共识的契合度)、鲁棒性(模型在多次测试中选择最频繁答案的比例,反映输出的稳定性与可靠性)、绝对比例差(针对二元问题,模型选择专家得票最高选项的比例与专家得票率的绝对差值,反映模型与专家投票比例的接近程度)、Pearson相关系数r(针对非二元问题,模型答案分布与专家投票分布的线性相关性,反映模型对专家投票趋势的复现能力);统计分析方面,针对非正态分布的计量资料(鲁棒性、绝对比例差、Pearson相关系数)以中位数及四分位距(IQR)表示,采用Kruskal–Wallis非参数检验进行多组比较,两两比较采用Dwass–Steel–Critchlow–Fligner(DSCF)方法;分类资料以频数及百分比表示,采用Pearson卡方检验,检验水准α=0.05,使用SPSS PASW Statistics 18、R软件(4.2.2版)及MSTATA软件完成统计分析。
结果解读:通过明确的评估指标与规范的统计方法,实现了对大语言模型性能的量化评估与科学对比,确保了结果的统计学严谨性与可重复性,为模型的临床应用价值判断提供了客观依据。
产品关联:文献未提及具体实验产品,领域常规使用SPSS、R等专业统计软件开展医学研究数据的统计分析。
3.4 模型性能对比与分层分析
实验目的:全面评估DeepSeek-V3与圣加仑专家共识的一致性及鲁棒性,对比其与主流大语言模型的性能差异,分析不同临床场景、证据水平下的模型表现,明确模型的优势与局限性。
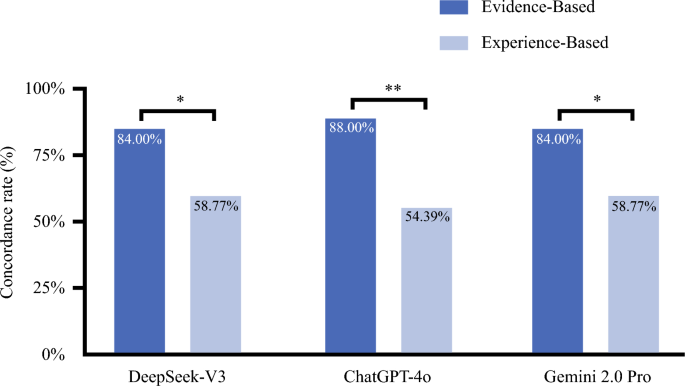
方法细节:首先对比DeepSeek-V3与专家共识的一致性,统计整体及分层(二元/非二元问题、不同临床主题)的一致性率与鲁棒性;然后横向对比DeepSeek-V3与Gemini 2.0 Pro、ChatGPT-4o的一致性与鲁棒性;进一步按临床主题、证据水平(基于专家投票率分为证据导向型问题≥80%、经验导向型问题<80%)开展分层分析,验证模型在不同场景下的性能稳定性。
结果解读:DeepSeek-V3与专家共识的整体一致性率为63.31%(n=139),平均鲁棒性为86.69%,其中78.42%的问题鲁棒性≥80%;二元问题的一致性率为67.57%(n=37),中位数绝对比例差为0.30,非二元问题的一致性率为61.76%(n=102),中位数Pearson相关系数r为0.82;在核心临床主题中,“基因检测”领域的一致性率最高(76.47%),“系统治疗:ER阳性、HER2阴性乳腺癌”领域最低(50.00%)。横向对比显示,三款模型的整体一致性率无显著差异(p=0.849),均处于60%-64%区间,但DeepSeek-V3的中位数鲁棒性为1.00(IQR 0.80,1.00),显著优于Gemini 2.0 Pro(p=0.005)与ChatGPT-4o(p<0.001),而Gemini 2.0 Pro与ChatGPT-4o的鲁棒性无显著差异(p=0.557)。分层分析显示,三款模型在证据导向型问题中的一致性率均显著高于经验导向型问题,DeepSeek-V3在证据导向型问题中的一致性率为84.00%(n=25,p=0.018),经验导向型问题中为58.77%(n=114);在部分临床主题如“导管原位癌”“ER阳性HER2阴性乳腺癌系统治疗”中,DeepSeek-V3的鲁棒性显著优于ChatGPT-4o。


产品关联:文献未提及具体实验产品,领域常规使用大语言模型官方API接口开展多场景性能测试与对比分析。
4. Biomarker研究及发现成果
本文献聚焦于大语言模型在乳腺癌临床决策中的性能评估,核心研究内容为对比大语言模型输出与国际专家共识的一致性及鲁棒性,未涉及生物标志物(Biomarker)的筛选、验证、功能研究及临床应用相关内容,因此本模块无对应研究成果可解析。