

1. 领域背景与文献
文献英文标题:Plasma proteomic signatures improve risk stratification and personalized screening for gastric cancer;
发表期刊:文献未明确提供;影响因子:文献未明确提供;研究领域:肿瘤学(胃癌早筛与风险分层)
胃癌是全球范围内负担最重的恶性肿瘤之一,位列前五大常见癌症,发展中国家的发病率尤其显著偏高。其发病危险因素涵盖幽门螺杆菌感染、烟草使用、酒精摄入、不良饮食习惯及遗传易感性等多个方面。尽管临床治疗技术不断进步,但多数胃癌患者确诊时已处于晚期阶段,治疗难度大且预后极差,因此强化胃癌的防控措施至关重要。
领域共识:内镜筛查与早诊早治已被证实能显著降低胃癌的发病率与死亡率,尤其在高危人群中效果明确,但该手段在资源有限地区的推广面临诸多挑战,且其在非高危人群中的筛查有效性仍需进一步评估。当前,循环蛋白作为反映病理状态的生物标志物,在癌症早筛、进展监测及预后评估中展现出良好潜力,蛋白质组学技术为筛选新型标志物提供了有力工具。然而,多数现有研究聚焦于胃癌的诊断性标志物,缺乏基于大样本纵向队列的风险预测验证,且现有风险预测模型多依赖临床因素或多基因风险评分,预测效能的提升空间有限,难以实现精准的人群风险分层。本研究正是针对这一研究空白,采用两阶段研究设计(病例对照发现+前瞻性队列验证),筛选与胃癌发病相关的血浆蛋白质组学特征,并整合临床、遗传因素构建优化的风险预测模型,旨在提升胃癌风险分层的精准度,为个性化筛查策略提供依据。
2. 文献综述解析
作者在综述部分以胃癌防控的临床需求为核心,从现有早筛手段的局限、循环蛋白标志物的研究进展、现有风险预测模型的不足三个维度,系统梳理了领域内的研究现状,明确了本研究的创新方向与学术价值。
现有研究的关键结论主要包括三个方面:一是内镜筛查在胃癌高危人群中能有效降低发病率与死亡率,但受资源限制难以在全人群推广,且非高危人群中的筛查效性价比待验证;二是循环蛋白标志物在胃癌诊断中展现出潜力,部分蛋白如MMP7、FABP5已被证实与胃癌发生发展相关,但多数研究为小样本病例对照设计,缺乏大样本纵向队列的风险预测验证;三是现有胃癌风险预测模型主要基于临床因素或多基因风险评分,临床模型的C-index约为0.73左右,加入多基因风险评分后仅能小幅提升预测效能,难以满足精准分层的需求。现有研究的技术方法优势在于,蛋白质组学技术能同时检测数千种蛋白,为筛选新型标志物提供了高通量手段;但局限性也较为明显,多数研究样本量较小、缺乏纵向验证,且未整合多组学数据构建风险模型,对人群风险分层的精准度不足。
本研究的创新价值在于,首次采用两阶段研究设计,结合质谱技术的无偏发现与UK Biobank大样本前瞻性队列的验证,筛选出与胃癌发病风险相关的血浆蛋白标志物,并将其与临床、遗传因素整合构建风险预测模型,实现了更精准的人群风险分层。与现有研究相比,本研究解决了现有风险模型未整合蛋白质组学数据、缺乏大样本纵向验证的问题,为胃癌的个性化早筛提供了新的技术范式。
3. 研究思路总结与详细解析
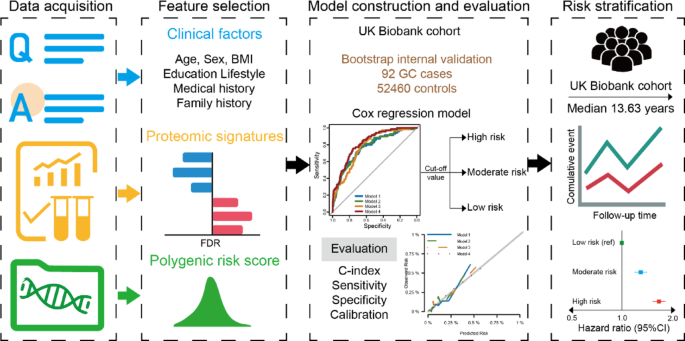
本研究的整体框架为“两阶段标志物筛选→多组学风险模型构建→风险分层效能验证”的闭环,研究目标是筛选与胃癌发病相关的血浆蛋白质组学特征,整合临床、遗传因素构建更优的胃癌风险预测模型,实现精准风险分层与个性化筛查;核心科学问题是血浆蛋白标志物能否提升胃癌风险预测效能,超越传统临床与遗传因素;技术路线为:首先通过病例对照研究的质谱分析发现差异表达蛋白,然后在大样本前瞻性队列中验证蛋白与胃癌风险的关联,接着筛选稳定的标志物并整合临床、遗传因素构建多个风险模型,最后验证模型的预测效能与风险分层能力。
3.1 研究队列建立与样本处理
实验目的:构建具有代表性的两阶段研究队列,获取合格的血浆样本用于后续蛋白质组学分析与验证。
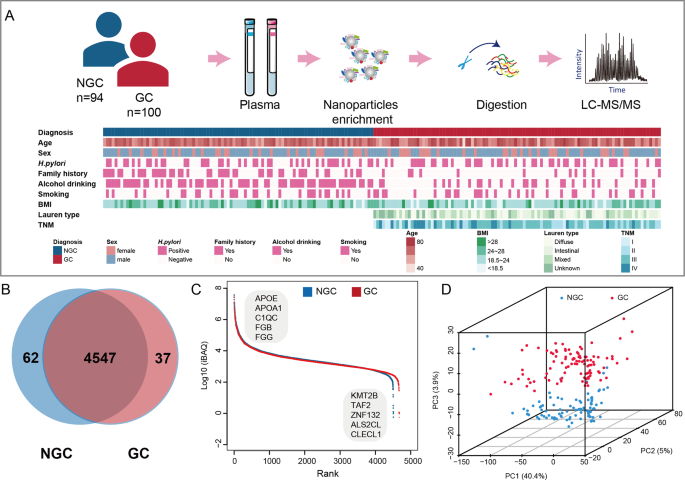
方法细节:发现阶段为医院-based病例对照研究,纳入2022年至2023年2月浙江肿瘤医院的194名参与者,其中100例为初治胃癌患者(未接受放化疗、靶向治疗等),94例为非癌对照(包含浅表性胃炎、慢性萎缩性胃炎、肠化生患者);所有参与者采集空腹5ml EDTA抗凝静脉血,1小时内4℃运输,1800g离心10分钟分离血浆,-80℃保存。验证阶段为UK Biobank队列,纳入52552名2006-2010年招募的参与者,通过医院数据、癌症登记库及死亡登记库确定胃癌病例,中位随访时间为13.63年,期间确诊92例胃癌。
结果解读:发现阶段队列的胃癌患者涵盖I-IV期(I期10例、II期22例、III期50例、IV期18例),对照组包含不同程度的胃黏膜病变,能较好地反映胃癌发生前的病理状态;验证队列样本量大、随访时间长,能有效评估血浆蛋白标志物对胃癌发病的长期预测价值,减少偏倚。
产品关联:文献未提及具体样本处理的辅助产品,领域常规使用EDTA抗凝采血管、低温离心机等设备。
3.2 血浆蛋白质组学检测与差异分析
实验目的:筛选胃癌患者与非癌对照之间的差异表达血浆蛋白,鉴定潜在的胃癌风险标志物。
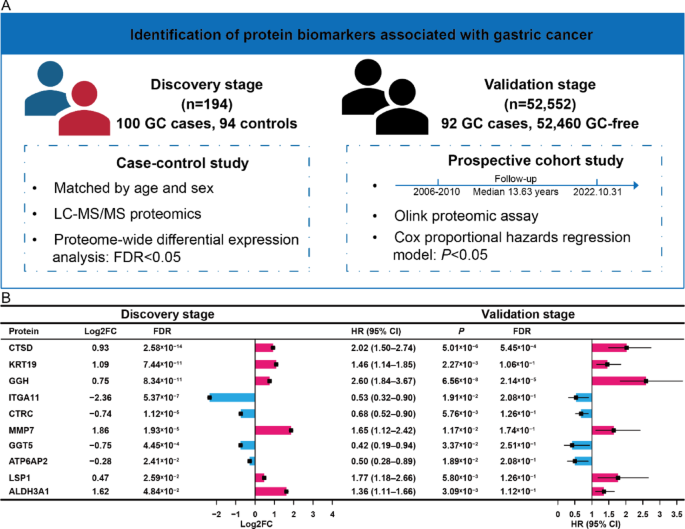
方法细节:发现阶段采用数据非依赖采集(DIA)质谱技术,样本经北京精准健科的血浆蛋白富集试剂盒(货号PH035)富集后,加入胰酶37℃过夜消化,消化产物经液相色谱分离(Thermo Fisher UHPLC 3000系统,C18色谱柱)后,通过Orbitrap Eclipse质谱仪进行DIA检测;原始数据用Spectronaut 17.4软件搜库,以FDR<0.05筛选差异表达蛋白。验证阶段采用Olink Explore 3072平台检测血浆蛋白,通过Cox比例风险回归分析蛋白与胃癌发病风险的关联,以名义显著性(P<0.05)且效应方向与发现阶段一致作为重复验证标准,进一步通过FDR校正筛选高置信度标志物。
结果解读:发现阶段共鉴定出4646种高可靠性血浆蛋白,其中4547种在胃癌与非癌组中均有检测到;主成分分析显示两组的血浆蛋白质组学特征存在明显差异。进一步差异分析发现2306种显著差异表达蛋白,其中881种上调、1425种下调(Log₂FC≠0,FDR<0.05)。验证阶段对326种可检测的差异蛋白进行分析,最终25种蛋白在名义显著性水平(P<0.05)上重复验证,其中20种与胃癌风险正相关(HR>1,P<0.05),5种负相关(HR<1,P<0.05);经FDR校正后,CTSD和GGH两种蛋白仍保持显著关联(FDR<0.05),为高置信度标志物。
产品关联:实验所用关键产品:北京精准健科的血浆蛋白富集试剂盒(货号PH035)、Thermo Fisher Scientific的UHPLC 3000液相色谱系统、Orbitrap Eclipse质谱仪、Biognosys的Spectronaut 17.4软件、Olink Explore 3072蛋白检测平台。
3.3 多基因风险评分(PRS)构建
实验目的:构建胃癌多基因风险评分,作为遗传因素纳入后续风险模型整合。
方法细节:基于UK Biobank的基因型数据,筛选112个全基因组显著关联的胃癌单核苷酸多态性(SNP,P<5×10⁻⁸),采用加权多基因风险评分计算方法,整合每个SNP的效应等位基因剂量与全基因组关联研究(GWAS)中得到的效应估计值。
结果解读:构建的PRS能反映个体的胃癌遗传易感性,后续模型分析显示,将PRS加入临床模型后,预测效能仅得到小幅提升(C-index从0.732升至0.738,P=0.084),提示遗传因素对胃癌风险预测的增量价值有限。
产品关联:文献未提及具体实验产品,领域常规使用Affymetrix的UK Biobank Axiom Array或UK BiLEVE Axiom Array进行基因分型,采用PLINK或PRSice软件计算多基因风险评分。
3.4 风险预测模型构建与验证
实验目的:整合临床、遗传、蛋白质组学因素,构建多个胃癌风险预测模型,评估不同模型的预测效能,筛选最优模型用于风险分层。
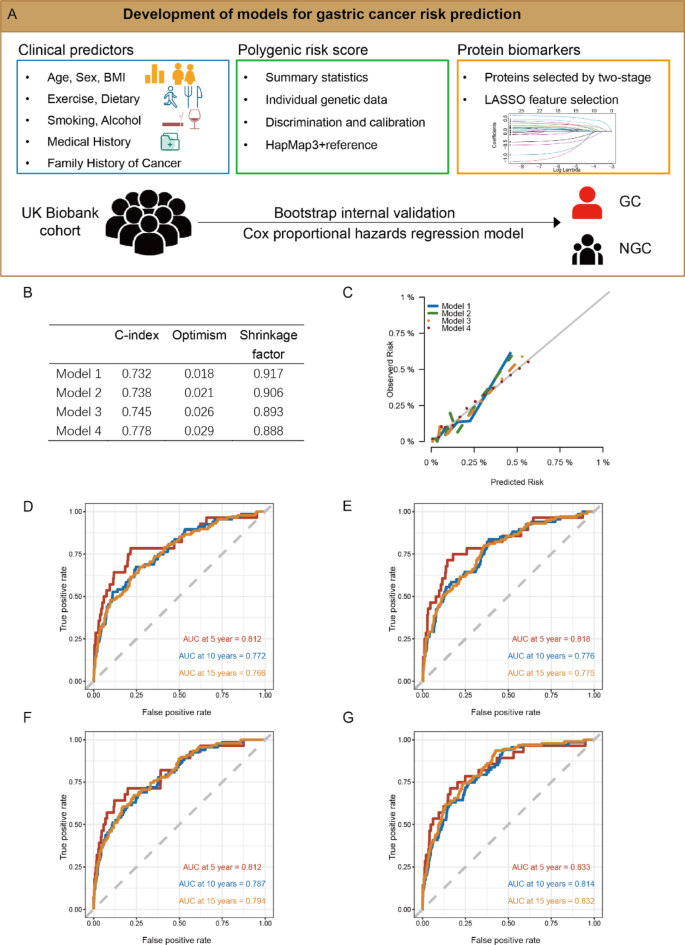
方法细节:首先从UK Biobank队列中提取临床特征,通过单变量Cox比例风险回归筛选潜在的胃癌风险相关因素,再经多变量Cox回归向后选择确定临床模型(Model1)的纳入变量(包括年龄、性别、教育程度、吸烟状态、体力活动、癌症家族史);然后加入多基因风险评分构建Model2;接着对验证后的25种蛋白标志物,采用LASSO惩罚Cox回归结合200次bootstrap稳定性选择,筛选稳定的预测因子,其中选择频率≥0.7的5种蛋白(CTSD、KRT19、CTRC、ALDH3A1、GGH)与临床因素整合构建主蛋白模型(Model3),选择频率≥0.4的10种蛋白与临床因素整合构建扩展蛋白模型(Model4)。采用1000次bootstrap重采样进行内部验证,计算乐观校正C-index、校准曲线、时间依赖ROC曲线评估模型效能。
结果解读:Model1的乐观校正C-index为0.732,Model2为0.738(P=0.084),提示加入PRS后预测效能提升不显著;Model3的乐观校正C-index为0.745(P=0.046),较Model1有统计学意义的提升;Model4的乐观校正C-index为0.778(P<0.001),预测效能最高,但因胃癌事件数有限,存在过拟合风险,作为探索性分析。Bootstrap估计的乐观值为0.018-0.029,收缩因子为0.89-0.92,提示模型过拟合程度在可接受范围内;校准曲线显示所有模型的预测风险与观察风险一致性良好;时间依赖ROC曲线显示,随着随访时间延长,蛋白模型的AUC均优于临床模型,提示蛋白标志物能提升长期风险预测的准确性。
产品关联:文献未提及具体实验产品,领域常规使用R软件(survival、glmnet包)进行Cox回归与LASSO分析,ggplot2、survminer包绘制校准曲线与ROC曲线。
3.5 胃癌风险分层与临床效用分析
实验目的:评估主蛋白模型(Model3)对人群的风险分层能力,验证其在临床实践中的应用价值。
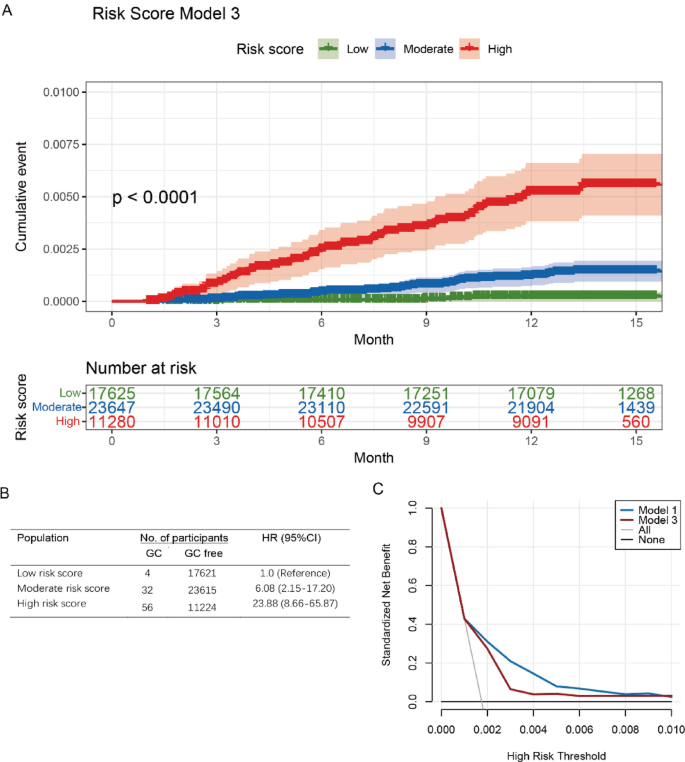
方法细节:基于Model3计算的风险评分,将UK Biobank验证队列的参与者分为低、中、高风险组,采用Kaplan-Meier法分析不同风险组的胃癌累积发病率,计算各风险组相对于低危组的风险比(HR)及95%置信区间(CI);采用决策曲线分析(DCA)评估模型的临床净获益,与临床模型(Model1)进行比较。
结果解读:三组的胃癌风险呈现显著梯度(log-rank P<0.0001),与低危组相比,中危组的HR为6.08(95%CI 2.15-17.20),高危组的HR为23.88(95%CI 8.66-65.87);15年累积发病率在低危组为0.02%,中危组为0.14%,高危组为0.56%(文献未明确提供样本量,基于图表趋势推测)。病例分布显示,60.9%的胃癌病例发生在高危组,仅4.4%发生在低危组,提示模型能有效将高风险人群集中识别。当风险评分作为连续变量分析时,每增加1个标准差的风险评分,胃癌发病风险提升1.09倍(95%CI 1.08-1.11,P<0.001),提示风险评分与胃癌风险存在稳定的剂量反应关系。决策曲线分析显示,在较宽的阈值概率范围内,主蛋白模型的临床净获益均高于临床模型,提示其在临床实践中能为胃癌筛查决策提供更有价值的信息。
产品关联:文献未提及具体实验产品,领域常规使用R软件(survminer包绘制生存曲线,rmda包进行决策曲线分析)。
4. Biomarker研究及发现成果解析
本研究通过两阶段筛选与验证,鉴定出25种与胃癌发病风险相关的血浆蛋白标志物,其中CTSD和GGH为经多重检验校正后的高置信度标志物;进一步通过稳定性选择筛选出5种核心蛋白构建主风险模型,实现了更精准的胃癌人群风险分层,为胃癌个性化筛查提供了新的生物标志物组合。
Biomarker定位:本研究涉及的Biomarker类型为血浆可溶性蛋白标志物,包括CTSD、GGH、KRT19、CTRC、ALDH3A1等25种;筛选与验证逻辑为“病例对照发现阶段(质谱差异分析,FDR<0.05)→前瞻性队列验证阶段(Cox回归,P<0.05且效应方向一致)→稳定性选择(LASSO+bootstrap,选择频率≥0.7/0.4)”,最终5种蛋白纳入主风险模型,10种纳入扩展模型。
研究过程详述:Biomarker来源为参与者的空腹血浆样本(发现阶段为医院病例对照,验证阶段为UK Biobank队列);验证方法为Cox比例风险回归分析,评估蛋白与胃癌长期发病风险的关联;特异性与敏感性方面,时间依赖ROC曲线显示主蛋白模型在15年随访时的AUC优于临床模型(文献未明确具体数值,基于图表趋势推测);核心数据显示,CTSD和GGH与胃癌风险显著正相关(HR>1,FDR<0.05),主蛋白模型能将人群分为低、中、高风险组,高危组的胃癌发病风险是低危组的23.88倍(95%CI 8.66-65.87,P<0.001),15年累积发病率达0.56%,远高于低危组的0.02%。
核心成果提炼:本研究发现的血浆蛋白标志物与胃癌发病风险存在显著关联,其中CTSD和GGH为高置信度标志物,其生物学功能与胃癌的发生发展密切相关:CTSD是溶酶体天冬氨酸蛋白酶,异常糖基化会影响其酶功能,与胃癌发病机制相关;GGH调节细胞内叶酸浓度,参与细胞增殖、DNA合成与修复,高表达提示胃癌患者预后不良。本研究的创新性在于,首次通过大样本前瞻性队列验证了血浆蛋白标志物对胃癌的风险预测价值,整合多组学数据构建的风险模型能有效实现人群风险分层,高危组集中了60.9%的胃癌病例,为个性化早筛提供了精准的靶点。研究结果显示,主蛋白模型的乐观校正C-index为0.745(P=0.046),较临床模型有统计学意义的提升,决策曲线分析也证实其具有更高的临床净获益。