

1. 领域背景与文献
文献英文标题:Determinants of Non-Receipt of Guideline-Concordant Treatment in Pancreatic Cancer: A Classification Tree Analysis;
发表期刊:文献未明确提供;影响因子:未公开;研究领域:肿瘤学(胰腺癌诊疗决策)
领域共识:胰腺导管腺癌(PDAC)是致死性极高的恶性肿瘤,预计将在本十年成为癌症相关死亡的第二大原因,当前5年总生存率仅为13%。美国国家综合癌症网络(NCCN)临床实践指南提供了基于证据的分期特异性治疗建议,指南一致治疗(GCT)与各疾病阶段的生存率改善相关,但仍有30%-50%的PDAC患者未接受GCT。当前研究热点集中于探索非GCT的影响因素,但现有研究多采用传统回归模型评估独立变量的关联,无法反映临床实践中诊疗障碍的共现模式及不同患者亚组的差异,这一研究空白限制了精准识别高风险患者及制定针对性干预策略的能力。本研究旨在通过分类树(CART)方法,分析初诊时多维度变量的分层关联,填补这一领域空白,为早期风险识别和干预提供临床可解释的框架。
2. 文献综述解析
本文综述部分首先梳理了PDAC诊疗中GCT的现状与价值,随后系统回顾了现有关于非GCT影响因素的研究,指出传统分析方法的局限性,进而引出分类树方法在揭示因素交互模式中的优势。
现有研究的关键结论集中于明确年龄、种族、合并症、社会经济地位等独立因素与非GCT的关联,部分研究验证了GCT与生存率的正相关关系;技术方法上,传统回归模型能量化单因素的独立效应,优势是分析框架成熟、结果易解读,但局限性在于无法捕捉多因素的共现与分层关系,难以反映临床实践中患者面临的多重诊疗障碍的交互作用,也无法识别具有相似风险特征的临床亚组。本文的创新价值在于首次采用分类树方法,聚焦初诊时可获取的多维度变量,构建分层模型以揭示不同社会经济背景下非GCT的差异模式,弥补了传统模型无法体现因素交互与亚组异质性的不足,为临床早期识别高风险患者提供了更贴合实际的分析视角。
3. 研究思路总结与详细解析
本研究采用多中心回顾性队列研究设计,以1040例PDAC患者为研究对象,通过分类树(CART)模型分析初诊时人口学、临床、社会经济及医疗利用领域的变量,识别与非GCT相关的分层模式,并通过剪枝优化和敏感性分析验证模型稳定性,最终明确不同社会经济背景下的关键影响因素路径。
3.1 研究队列构建与变量标准化定义
实验目的:建立标准化的PDAC患者队列,明确指南一致治疗(GCT)的判定标准及纳入分析的变量,确保研究数据的一致性和可靠性。
方法细节:回顾性纳入2018-2022年美国东南部两家学术三级中心的成年PDAC患者,采用《国际疾病分类第十版》(ICD-10)代码筛选病例,排除关键数据缺失的患者;通过手动病历回顾,基于NCCN指南结合疾病分期、可切除性、合并症、患者意愿等判定GCT状态;将候选变量分为人口学、临床、社会经济/医疗可及性、医疗利用四个领域,对连续变量进行临床意义的分组,缺失数据<5%未进行插补。
结果解读:最终纳入1040例患者,其中337例(32.4%)未接受GCT;未接受GCT的患者在年龄(≥80岁患者占56.1%,n=1040,P<0.001)、种族(黑人占43.6%,n=1040,P<0.001)、社会经济状态(区域剥夺指数(ADI)≥7的患者占52.2%,n=1040,P<0.001)、临床指标(东部肿瘤协作组(ECOG)评分≥2占49.4%,n=1040,P<0.0001)等维度与接受GCT的患者存在显著差异;非GCT的主要原因包括临床恶化(43.6%)、医疗系统与可及性障碍(23.1%)等。
产品关联:文献未提及具体实验产品,领域常规使用电子病历系统、统计学分析软件(如Python的pandas、scikit-learn库)进行数据整理与分析。
3.2 分类树模型构建与分层模式识别
实验目的:通过分类树(CART)模型分析变量间的分层关联,识别与非GCT相关的临床可解释亚组模式。
方法细节:将队列按80/20比例分为训练集和测试集,采用分层抽样保持结局分布一致;先构建未修剪分类树,以基尼杂质减少为分裂依据,设置最大树深度12、最小分裂样本量15、最小终端节点样本量10;通过5倍重复交叉验证进行成本复杂度剪枝,选择最优修剪树;基于基尼杂质减少评估变量重要性,在测试集验证模型性能。
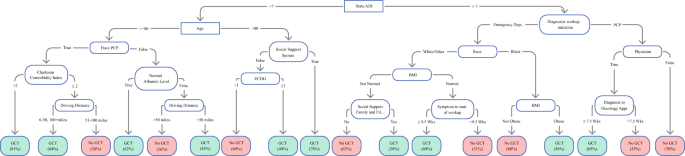
结果解读:未修剪分类树显示,区域剥夺指数(ADI)为初始分裂节点(阈值7):ADI<7的患者中,年龄≤80岁且有初级保健提供者(PCP)的患者GCT接受率更高(81%),无PCP的患者中白蛋白水平和就医距离进一步区分结局;ADI≥7的患者中,急诊(ED)启动诊疗的患者GCT接受率更低,后续按种族、体重指数(BMI)、社会支持进一步分层。
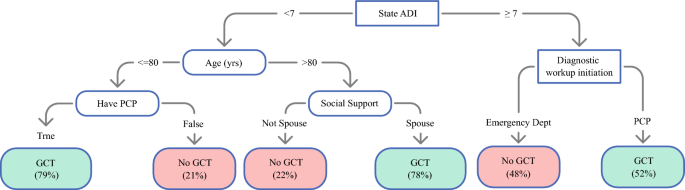
修剪后的最优树保留ADI为初始分裂节点,ADI≥7的患者按诊疗启动地点分裂(ED启动的非GCT率48%),ADI<7的患者按年龄分裂(≥80岁且无配偶支持的患者非GCT率更高)。
产品关联:文献未提及具体实验产品,领域常规使用Python的scikit-learn库进行分类树模型构建与分析。
3.3 敏感性分析与模型性能评估
实验目的:验证模型结构的稳定性,排除年龄作为主导分层变量的影响,并评估模型的判别能力。
方法细节:进行排除年龄的敏感性分析,重复CART建模流程;通过受试者工作特征曲线下面积(AUROC)、敏感性、特异性、准确性评估模型性能,确定Youden最优阈值。
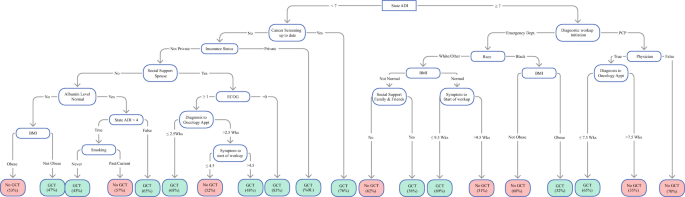
结果解读:排除年龄的敏感性分析中,ADI仍为初始分裂节点;ADI<7的患者按癌症筛查状态分裂,筛查及时的患者GCT接受率更高(76%),未及时筛查的患者按保险状态、社会支持、白蛋白进一步分层;ADI≥7的患者仍按诊疗启动地点分裂,ED启动的患者非GCT率62%-68%。
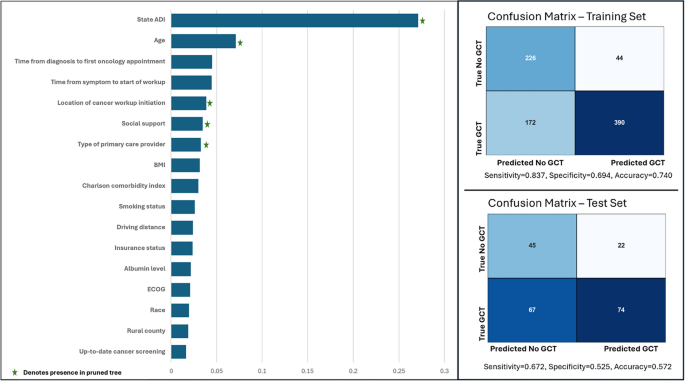
模型性能方面,训练集受试者工作特征曲线下面积(AUROC)为0.849,敏感性83.7%,特异性69.4%,准确性74.0%(Youden阈值0.333);测试集AUROC为0.662,敏感性67.2%,特异性52.5%,准确性57.2%(Youden阈值0.211),变量重要性显示ADI是最具影响力的因素。
产品关联:文献未提及具体实验产品,领域常规使用统计学分析软件进行模型性能评估。
4. Biomarker研究及发现成果解析
本文涉及的Biomarker为与胰腺癌患者未接受指南一致治疗(GCT)相关的临床、社会经济及医疗可及性预测因子,包括区域剥夺指数(ADI)、年龄、初级保健提供者(PCP)存在与否、诊疗启动地点等,通过“队列筛选→多维度变量纳入→分类树(CART)模型分层验证→敏感性分析”的完整逻辑链进行识别与验证。
研究过程中,这些预测因子的来源为患者初诊时的临床病历数据及社会经济统计数据;验证方法采用CART分类树分析,通过训练集建模、交叉验证剪枝、测试集验证及敏感性分析,确认因子的分层关联;特异性与敏感性数据方面,模型在训练集的受试者工作特征曲线下面积(AUROC)为0.849(95% CI文献未明确提供),测试集AUROC为0.662(95% CI文献未明确提供),Youden最优阈值下的敏感性和特异性分别为训练集83.7%、69.4%,测试集67.2%、52.5%。
核心成果提炼:这些预测因子的功能关联在于,ADI作为初始分层变量,可将患者分为高社会经济剥夺和低剥夺亚组,不同亚组中影响非GCT的关键路径不同:高剥夺亚组中,急诊启动诊疗是核心障碍;低剥夺亚组中,年龄、社会支持、临床状态是核心影响因素;创新性在于首次通过CART方法揭示了不同社会经济背景下非GCT的分层模式,为早期识别高风险患者提供了临床可解释的框架;统计学结果显示,ADI≥7的患者非GCT率为52.2%(n=1040,P<0.001),年龄≥80岁且无配偶支持的患者非GCT率显著升高(文献未明确具体数值,基于图表趋势推测)。