

新型开源模型借助进化信息设计具有治疗价值的结合蛋白,绘制未知蛋白质功能空间
作者:Fay Lin博士
2026年5月27日
注:图片来源:Christoph Burgsted/Science Photo Library/盖蒂图片社
由陈普莉西娅(Priscilla Chan)医学博士与马克·扎克伯格联合创立的非营利研究机构Biohub,今日公布了ESM蛋白质语言模型家族的最新更新,该版本拓展了结合蛋白设计与蛋白质功能图谱绘制能力,可应用于治疗性药物发现。本次更新距Biohub招募EvolutionaryScale团队仅过去7个月。
本次发布的系统包含ESMC(寒武纪进化尺度模型,Evolutionary Scale Modeling Cambrian)——这一语言模型的训练集涵盖来自各类生命形式的约28亿条序列,其中包括极端环境适应性生物的序列,以及人体内存在的2万余种蛋白质序列。ESMC编码的进化信息可通过设计引擎与预测模型ESMFold2转换为原子分辨率的蛋白质结构与相互作用信息。
Biohub科学负责人、前EvolutionaryScale首席科学家Alex Rives博士在本周于冷泉港实验室举办的“生物学中的人工智能”研讨会上公布了该研究成果。
这些模型旨在让生物学更具可编程性,从而变革药物发现的早期阶段。传统药物发现流程依赖耗时耗力的实验筛选来确定潜在候选药物,而基于计算机模拟(in silico)预测指导的理性蛋白质设计有望大幅缩短研发周期。
Rives在接受《GEN Edge》采访时表示:“我们正处于蛋白质生物学领域的一个激动人心的节点:精准的数字化表征让我们能够开展实验室条件下无法实现的大规模实验问题探索。”
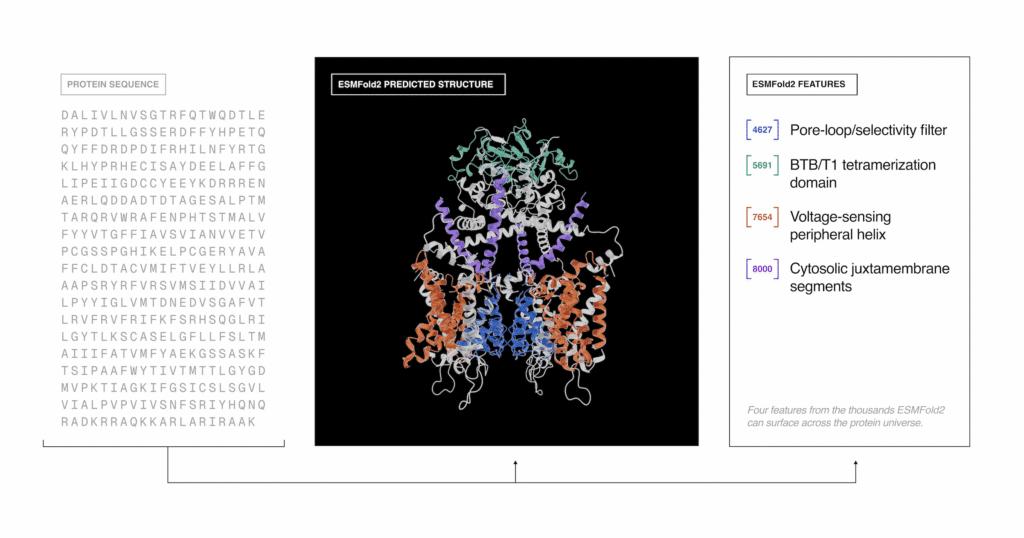
注:ESMC为蛋白质序列、结构与功能的建模提供基础;ESMFold2可预测蛋白质及生物分子复合物的结构。从模型表征中提取的特征捕捉了结构与功能的基本规律,构成了蛋白质生物学的组成语法。[图片来源:Biohub]
ESMFold2针对5个肿瘤与免疫学领域的疾病靶点设计了高亲和力蛋白结合物,包括与肿瘤生长相关的受体酪氨酸激酶(EGFR、PDGFRβ)、被癌细胞利用逃避免疫监视的免疫检查点分子(PD-L1、CTLA-4),以及免疫细胞信号调节因子CD45。
经实验室验证的设计中,紧凑型迷你结合物的命中率达36%~88%,抗体衍生格式结合物的命中率为15%~29%,同时表现出纳摩尔级结合亲和力、高特异性与良好的稳定性,符合临床应用的潜在要求。值得注意的是,PD-L1结合物在实验室检测中表现出治疗功能,可通过阻断与已获批检查点疗法相同的通路恢复T细胞信号传导。
ESMFold2无需依赖多序列比对(MSA,multiple sequence alignment)构建表征,即可捕捉预训练过程中编码的进化信息。该模型还采用了环形Transformer架构,可在推理阶段实现算力的灵活扩展,同时避免了训练过程受限于有限实验解析蛋白质结构导致的过拟合问题。
在基准测试中,ESMFold2的表现优于Chai Discovery开发的Chai-1、麻省理工学院开发的Boltz-1(其开发人员后续已成立一家公益企业),以及谷歌DeepMind开发的AlphaFold 3。
上述模型采用极其宽松的麻省理工学院(MIT)许可协议开放,可用于商业与非商业用途。相关研究成果以预印本形式发布,尚未经过同行评议。
全力押注AI生物学
去年11月,陈与扎克伯格承诺将“全力投入AI驱动的生物学研究”,宣布该机构的科研团队将整合为单一实体(即Biohub),二人也将把大部分慈善精力投入该平台。
同时,Rives与EvolutionaryScale的同事也受邀加入团队,通过解析数十亿年进化形成的氨基酸“语法”开展疾病相关研究。这一使命曾助力该初创公司在2024年成立时获得1.42亿美元的巨额种子轮融资,该轮融资由Nat Friedman、Daniel Gross与Lux Capital领投,亚马逊云科技(AWS)与英伟达风险投资部门NVentures参与投资。
Biohub通过构建分子、基因组、细胞与生命系统的数字化表征,持续推进虚拟生物学研究。本次发布的ESM新模型加入了Biohub不断扩充的生物学模型生态,其中包括本月早些时候发表于《科学》(Science)的TranscriptFormer模型。
该机构近期向虚拟生物学计划投入5亿美元,这一为期五年的项目旨在加速技术开发与多模态数据集构建,以建立生物学预测模型。此次投入的数月前,Biohub宣布与Arc研究所、Tahoe Therapeutics合作,构建全球最大的单细胞化学扰动数据集,为虚拟细胞模型提供数据支撑。
进化信息足矣
Biohub已将新ESM模型用于构建ESM图谱(ESM Atlas),该图谱利用ESMC的表征将68亿条序列、11亿个预测结构对应到蛋白质功能。生成该图谱原本需要“数十亿年的实验工作”,但通过计算推理仅耗时数周即可完成,目前ESM图谱已开源发布。
研究人员利用稀疏自编码器(SAE,sparse autoencoder,一种用于在大语言模型中识别可解释结构的技术)解析ESMC的表征后发现,尽管仅在序列数据上训练,该模型已自主学习到了层级化的组织规律,涵盖单个氨基酸的基础化学性质、局部结构相互作用,以及跨非同源蛋白的功能概念。
值得注意的是,尽管RNA引导的DNA核酸内切酶、真核Fanzor蛋白及其原核祖先TnpB的进化差异大、序列相似性低,ESM图谱的SAE特征簇仍将这三类分子归为一类,这些发现可为新型基因编辑工具的开发提供支持。
尽管该预印本的研究成果距离临床应用仍有距离,Rives重申了开放科学的价值——将这些工具交到直接从事转化研究的科研人员手中。
Biohub正与多个平台合作伙伴合作,包括AWS生物发现平台、Benchling、Phylo、Tamarind Bio、Modal、Tool Universe与SandboxAQ,以推动模型的广泛可及。
专业注释
- in silico:生命科学领域特指计算机模拟开展的虚拟实验
- 多序列比对(MSA):蛋白质/核酸序列同源性分析的常用技术
- 稀疏自编码器(SAE):可提取大模型可解释特征的人工智能算法