

1. 领域背景与文献
文献英文标题:Multidimensional 5-hydroxymethylcytosine features in cell-free DNA enable the detection, staging and subtyping of pancreatic ductal adenocarcinoma;
发表期刊:文献未明确提供;影响因子:文献未明确提供;研究领域:胰腺肿瘤学、液体活检、表观遗传学
胰腺导管腺癌(PDAC)是全球致死性最高的恶性肿瘤之一,2015-2021年患者5年相对生存率仅13.3%,其恶劣预后主要源于隐匿起病与晚期诊断,约79%患者确诊时已处于局部晚期或转移阶段,同时肿瘤生物学异质性也增加了临床管理难度。现有临床诊断手段存在显著局限:血清生物标志物糖类抗原19-9(CA19-9)敏感性为79%-81%、特异性为82%-90%,且5%-10%的Lewis抗原阴性个体无法产生该标志物;影像学对直径<2cm的早期肿瘤敏感性仅50%-70%,不适用于人群筛查。因此,亟需可同时实现PDAC检测、分期与分型的非侵入性生物标志物。
液体活检作为微创评估肿瘤相关信号的手段,游离DNA(cfDNA)已成为PDAC检测与监测的重要分析物。现有研究已探索cfDNA突变、甲基化、片段大小谱等特征,但单一特征仅能捕获疾病生物学的有限维度,突变检测受早期肿瘤含量低的限制,单一模态生物标志物无法全面反映肿瘤进展与侵袭的动态多层生物学过程。5-羟甲基胞嘧啶(5hmC)作为与活跃基因调控和组织特异性转录程序相关的表观标记,已在多种癌症中显示出cfDNA生物标志物的潜力,但多数研究仅聚焦于癌与对照的区分,尚未系统探索cfDNA 5hmC特征在PDAC分期与病理分型中的应用,也未系统整合覆盖度与片段组学层面的多维度5hmC特征。针对上述研究空白,本研究旨在通过整合多维度cfDNA 5hmC特征,建立可同时实现PDAC检测、分期与分型的非侵入性表观遗传学框架。
2. 文献综述解析
作者对领域内现有研究按cfDNA生物标志物的类型进行分类,涵盖突变、甲基化、片段组学、5hmC四大类,系统梳理了各类特征的应用现状与局限。现有研究的关键结论显示,cfDNA各特征均能在一定程度上区分PDAC与对照样本,其中5hmC因富集于基因体和调控区域、具有强组织特异性,可反映癌症相关表观重塑;技术优势方面,液体活检具有微创性,5hmC检测无需严苛的化学转化,适用于低输入量cfDNA样本;局限性则包括突变检测受肿瘤含量限制导致早期敏感性不足,单一模态特征无法全面捕获肿瘤进展的生物学过程,现有5hmC研究多集中于癌与对照的二元区分,未拓展至分期与分型,且未整合多维度5hmC信号。
通过对比现有研究的未解决问题,本研究的创新价值凸显:首次系统分析PDAC中cfDNA的多维度5hmC特征,同时覆盖覆盖度层面(基因、基因组窗口、共识峰、开放染色质区域)与片段组学层面(片段大小分布、末端基序、重复序列关联特征);首次将多维度5hmC特征应用于PDAC的分期与病理分型,而非仅癌与对照的区分;建立两级机器学习框架,整合多维度特征的互补信息,实现更全面的疾病状态评估,为PDAC的非侵入性诊断与分层提供了新的表观遗传学策略。
3. 研究思路总结与详细解析
本研究的整体框架为:以PDAC早期诊断难、分期与分型缺乏非侵入性手段为核心科学问题,提出“多维度cfDNA 5hmC特征可反映PDAC疾病状态、进展与异质性”的假设,通过队列招募、cfDNA测序、多维度特征提取、差异分析、机器学习模型构建与验证的闭环技术路线,最终实现PDAC的检测、分期与分型。
3.1 研究队列与样本处理
实验目的是建立合格的PDAC与对照队列,获取高质量cfDNA样本用于后续测序与分析。方法细节为:2024年1月至12月在北京协和医院招募274名成年参与者,包括204名接受手术切除的PDAC患者、52名病理确诊的良性胰腺肿瘤患者、18名健康对照;术前采集外周血,经两次离心分离血浆,使用Qiagen Circulating Nucleic Acid Kit提取cfDNA,采用5hmC-Seal方法构建文库,在Illumina NovaSeq 6000平台进行双端150bp测序。结果解读:所有样本均成功提取cfDNA并完成测序,测序数据经质量控制与比对后,可用于后续多维度特征的生成。实验所用关键产品:Qiagen的Circulating Nucleic Acid Kit、Illumina NovaSeq 6000测序平台。

3.2 多维度5hmC特征提取
实验目的是从测序数据中系统提取覆盖度与片段组学层面的7类5hmC特征,为后续分析提供基础数据矩阵。方法细节为:覆盖度层面包括基因水平特征(用featureCounts统计基因体区域的片段计数)、3kb固定基因组窗口特征、样本特异性5hmC富集峰经合并得到的共识峰特征、胰腺癌特异性开放染色质区域(OCR)特征;片段组学层面包括片段大小分布(FSD)特征(按20-100bp、100-220bp、220-800bp区间统计)、5"端4-mer末端基序特征(统计256种基序的频率)、重复序列关联特征(用ARTEMIS pipeline分析LINE、SINE等重复家族的k-mer信号);所有特征均经过稀疏性过滤与方差阈值筛选。结果解读:成功构建7类特征的样本-特征矩阵,各类特征覆盖不同的生物学维度,可用于后续差异分析与模型构建。文献未提及具体实验产品,领域常规使用bedtools、MACS2、pysam等生物信息学工具。
3.3 PDAC与对照的5hmC特征差异分析
实验目的是鉴定可区分PDAC与非PDAC样本的5hmC特征,并解析其生物学意义。方法细节为:采用重复子采样策略对每类特征进行差异分析,计数类特征用PyDESeq2分析,ARTEMIS特征用limma分析,末端基序用beta回归分析;通过组织来源反卷积分析cfDNA 5hmC信号的组织贡献;对差异特征进行功能富集分析(基因特征用clusterProfiler,区域特征用rGREAT)。结果解读:PDAC样本在7类特征中均存在广泛差异,覆盖度特征多数呈上调趋势,末端基序显示T起始基序富集、G起始基序耗竭,140-190bp片段丰度增加,LINE重复序列k-mer计数显著升高;组织来源分析显示PDAC的cfDNA 5hmC信号来自中枢神经系统、消化、肝脏等多组织,而非仅胰腺;功能富集显示不同特征类型捕获互补的生物学过程,基因水平特征覆盖最广泛的功能谱,OCR特征集中于免疫调控与前列腺素相关生物学过程。文献未提及具体实验产品,领域常规使用rGREAT、clusterProfiler等功能富集工具。

3.4 PDAC分期相关5hmC特征分析
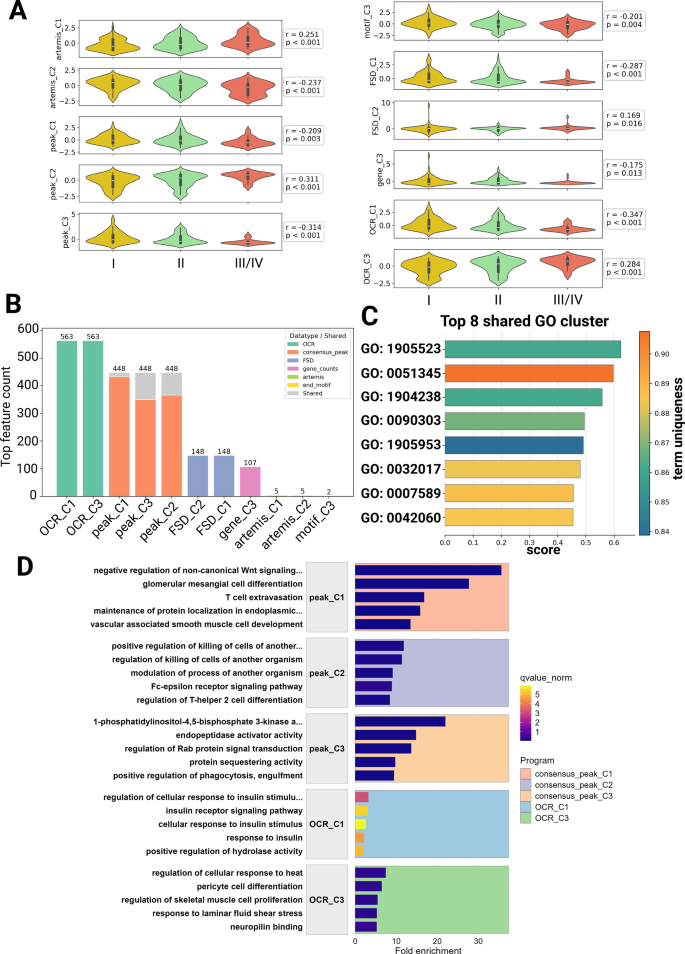
实验目的是探索5hmC特征随PDAC分期的动态变化,解析分期相关的生物学程序转变。方法细节为:在PDAC队列中,将III期与IV期合并为一组,用互信息筛选分期相关特征,采用非负矩阵分解(NMF)得到分期相关的潜在模块;对模块中高载荷特征进行功能富集分析,通过Spearman相关性验证模块与分期的关联。结果解读:NMF模块与病理分期显著相关,随分期升高的模块富集免疫细胞迁移、伤口愈合等免疫与基质相关功能,随分期降低的模块富集发育信号、代谢响应等早期生物学程序;提示PDAC进展过程中,5hmC调控的生物学程序从早期发育与代谢向晚期免疫与基质重塑逐步转变。文献未提及具体实验产品,领域常规使用NMF、Spearman相关分析工具。
3.5 PDAC病理亚型的5hmC特征分析
实验目的是基于淋巴结转移(LM)与血管侵犯(VI)的病理亚型,探索PDAC的5hmC特征异质性与进展顺序。方法细节为:将患者分为s00(LM-/VI-)、s01(LM-/VI+)、s10(LM+/VI-)、s11(LM+/VI+)四组,以s00为根、s11为终点用扩散伪时间(DPT)构建进展顺序;分析LM相关路径(s00→s10→s11)与VI相关路径(s00→s01→s11)的特异性特征与功能富集。结果解读:DPT分析显示亚型呈s00→s01/s10→s11的逐步进展顺序,s01与s10处于过渡状态;LM与VI相关路径的5hmC特征重叠度低,功能富集显示VI路径富集膜近端信号功能,LM路径富集发育重编程与细胞可塑性相关过程,提示双阳性侵袭状态可能通过部分不同的生物学路径形成。文献未提及具体实验产品,领域常规使用Scanpy进行DPT分析。

3.6 两级机器学习框架构建与验证
实验目的是建立整合多维度5hmC特征的模型,验证其在PDAC检测、分期与分型中的临床应用价值。方法细节为:构建两级机器学习框架,第一级针对每类特征单独训练模型(用FLAML选择最优分类器,通过嵌套交叉验证优化超参数),第二级用逻辑回归堆叠整合第一级模型的输出;分别构建PDAC检测(二元分类)、分期(三分类:I/II/III-IV)、分型(三分类:s00/s01-s10/s11)模型,通过嵌套交叉验证评估性能。结果解读:检测模型的ROC-AUC为0.952(n=274,基于嵌套交叉验证),验证准确率为0.9039;分期模型的macro-AUC为0.721(n=204,基于嵌套交叉验证),对III-IV期与I期的区分性能优于II期;分型模型的micro-AUC为0.831(n=204,基于嵌套交叉验证),对s00与s11的区分性能优于过渡状态;置换重要性分析显示,末端基序特征对检测贡献最大,OCR特征对分期贡献最大,基因与窗口特征对分型贡献最大。文献未提及具体实验产品,领域常规使用FLAML、Optuna等机器学习工具。

4. Biomarker研究及发现成果解析
Biomarker定位
本研究涉及的Biomarker为多维度cfDNA 5-羟甲基胞嘧啶(5hmC)特征,涵盖7类子特征:基因水平覆盖度、基因组窗口覆盖度、共识峰覆盖度、胰腺癌特异性开放染色质区域覆盖度、片段大小分布、4-mer末端基序、重复序列关联特征。其筛选与验证逻辑为:基于PDAC与对照队列的cfDNA测序数据,提取多维度5hmC特征;通过重复子采样差异分析筛选疾病相关特征;利用组织来源反卷积、功能富集解析特征的生物学意义;最终通过两级机器学习框架验证特征在检测、分期、分型中的临床价值,形成“队列测序-特征提取-差异筛选-功能解析-模型验证”的完整逻辑链条。
研究过程详述
该Biomarker的来源为PDAC患者与非PDAC对照的外周血血浆cfDNA。验证方法包括:差异分析(重复子采样策略降低类别不平衡影响)、组织来源反卷积(评估信号的组织贡献)、功能富集分析(解析特征的生物学功能)、嵌套交叉验证的机器学习模型(验证临床应用性能)。特异性与敏感性数据显示:PDAC检测模型的ROC-AUC为0.952,验证敏感性与特异性对应准确率为0.9039;分期模型的macro-AUC为0.721,对III-IV期的AUC为0.771、I期为0.717、II期为0.676;分型模型的micro-AUC为0.831,对s00的AUC为0.866、s11为0.917、过渡状态为0.670。
核心成果提炼
该多维度5hmC特征的功能关联包括:可反映PDAC的疾病状态(区分癌与对照)、进展阶段(分期相关的生物学程序转变)、病理异质性(淋巴结转移与血管侵犯的不同路径)。创新性在于首次在PDAC中系统整合覆盖度与片段组学层面的多维度5hmC特征,同时实现疾病的检测、分期与分型,突破了单一模态cfDNA生物标志物的局限。统计学结果显示:检测模型的平均验证准确率为0.9039(n=274,P值基于嵌套交叉验证的显著性检验,文献未明确提供具体P值);分期模型的平均准确率为0.5142(n=204,P值文献未明确提供);分型模型的平均准确率为0.6405(n=204,P值文献未明确提供)。该Biomarker为PDAC的非侵入性诊断与临床分层提供了新的表观遗传学工具,有望辅助高风险人群筛查、 indeterminate病变评估与术前风险分层。