

1. 应用领域与背景
文献英文标题:Translational buffering across diverse cellular contexts in humans and mice;发表期刊:Genome Biology;影响因子:未公开;研究领域:转录后调控与翻译缓冲
翻译缓冲是一种关键的转录后调控机制,通过调节核糖体对mRNA的占据率,抵消转录水平的波动,维持蛋白丰度稳态。早期研究主要集中在酵母中,证实了翻译缓冲在应对遗传变异、环境胁迫时对蛋白稳态的维持作用,但哺乳动物中翻译缓冲的研究仍处于零星报道阶段,核心问题包括:翻译缓冲在哺乳动物基因中的普遍性如何?跨物种保守性特征是什么?其分子决定因素、功能意义及潜在机制尚未明确。现有研究的局限性在于样本量小、缺乏跨物种系统分析,无法揭示翻译缓冲基因的共同特征和生理功能。本研究针对上述空白,利用RiboBase数据库中1515个匹配的核糖体图谱(Ribo-seq)与RNA-seq数据集,系统鉴定人和小鼠的翻译缓冲基因,解析其保守性、序列与细胞背景特征、功能意义及潜在机制,为哺乳动物翻译缓冲的研究提供了系统框架。
2. 文献综述解析
作者对现有翻译缓冲研究按物种(酵母、哺乳动物)和研究条件(遗传变异、环境胁迫)进行分类梳理,明确了领域内的研究现状与空白。现有研究中,酵母的研究通过核糖体图谱与RNA-seq联合分析,证实了翻译缓冲在抵消转录波动、维持蛋白稳态中的作用,技术方法的优势在于能够精准量化翻译效率与核糖体占据率,但研究范围局限于酵母,无法直接推广到哺乳动物。哺乳动物中的研究仅在特定条件(如雌激素受体α缺失)下发现部分基因存在翻译缓冲,缺乏对不同细胞和组织背景下翻译缓冲的系统分析,也未揭示翻译缓冲基因的保守性和共同特征。本研究的创新点在于:首次利用超过1500个哺乳动物样本的大规模数据,系统鉴定翻译缓冲基因;跨物种比较人和小鼠的翻译缓冲基因,揭示其保守性特征;结合序列分析、机器学习与功能验证,解析翻译缓冲的决定因素和功能意义;提出两种翻译缓冲的机制模型,为后续机制研究提供方向。
3. 研究思路总结与详细解析
本研究的整体框架为“计算鉴定-特征分析-功能验证-机制探究”,首先基于大规模多组学数据建立翻译缓冲基因的鉴定方法,然后分析其跨物种保守性和序列/细胞背景特征,接着验证翻译缓冲对蛋白丰度稳定性的影响,再探究其与基因剂量敏感性的关系,最后通过细胞实验验证提出两种机制模型。
3.1 翻译缓冲基因的系统鉴定
实验目的:从人和小鼠的大规模多组学数据中,系统鉴定具有翻译缓冲能力的基因。
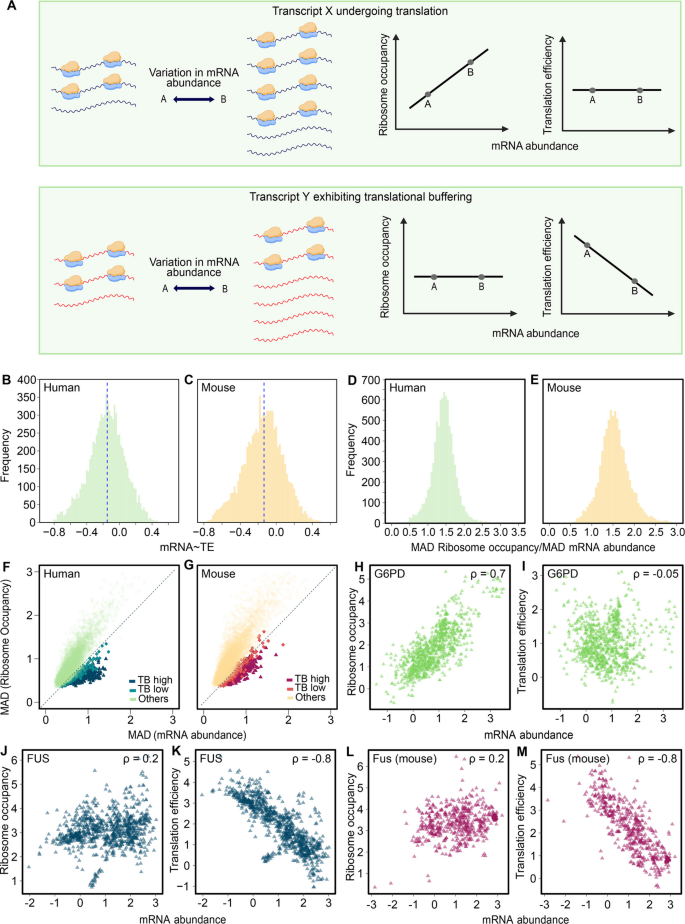
方法细节:利用RiboBase数据库中965个人类和550个小鼠的匹配核糖体图谱与RNA-seq数据集,采用组成回归模型计算翻译效率(TE),避免传统对数比值法的假相关;通过几何贝叶斯乘法插补处理缺失值,过滤mRNA与核糖体占据率呈非线性关系的样本;采用两个核心标准筛选翻译缓冲基因:一是mRNA丰度与TE的Spearman负相关(负相关性越强排名越高),二是核糖体占据率的中位数绝对偏差(MAD)与mRNA丰度MAD的比值(比值越低排名越高);综合两个标准的排名,将前250个基因定义为“TB high”,接下来250个为“TB low”,其余为“Others”。
结果解读:共鉴定出人类8433个基因、小鼠8135个基因的TE和核糖体占据率数据,其中TB high基因如人类FUS、小鼠Fus,表现出mRNA丰度变化时核糖体占据率保持稳定(Fig1 H-M);TB high基因的mRNA-TE呈显著负相关,核糖体占据率MAD与mRNA MAD的比值显著低于非缓冲基因(Fig1 D-G)。
产品关联:文献未提及具体实验产品,领域常规使用核糖体图谱文库构建试剂盒、RNA-seq文库构建试剂盒、生物信息学分析软件(如R、Python)等。
3.2 翻译缓冲的跨物种保守性与特征分析
实验目的:分析翻译缓冲基因的跨物种保守性,解析其序列特征与细胞背景的影响。
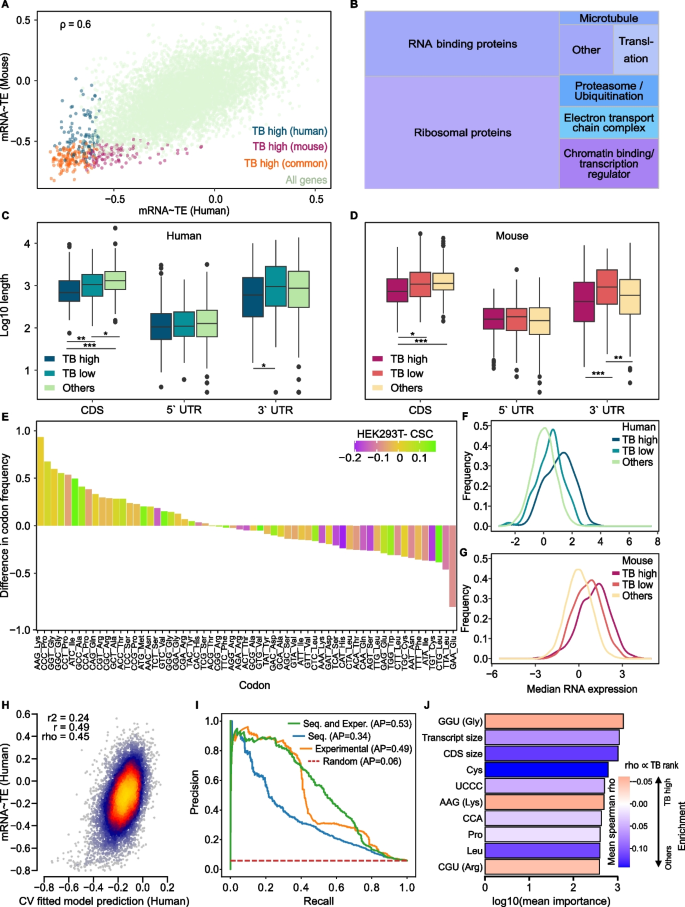
方法细节:比较人和小鼠同源基因的mRNA-TE相关性;分析TB high、TB low与Others基因的序列特征(CDS长度、UTR GC含量、密码子使用、密码子适应指数)、mRNA表达水平;采用轻梯度提升机(LGBM)模型,分别基于序列特征和实验特征预测翻译缓冲能力;分析RNA结合蛋白(RBP)表达与翻译缓冲基因TE的相关性。
结果解读:人和小鼠同源基因的mRNA-TE相关性为0.6(p<2.2×10⁻¹⁶),存在中等程度的保守性;126个基因在人和小鼠的TB high中共享,主要富集于核糖体蛋白、RNA结合蛋白、蛋白酶体复合物(Fig2 B);TB high基因的CDS长度更短(人类TB high vs Others,n=250 vs 495,p<1.0×10⁻³)、密码子适应指数更高、mRNA表达水平更高(Fig2 C-G);LGBM模型显示仅序列特征的预测r²为0.24,结合实验特征后性能提升,说明细胞背景对翻译缓冲的影响显著(Fig2 H-I);RBP的表达与翻译缓冲基因的TE存在显著相关性,提示反式作用因子参与翻译缓冲的调控。
产品关联:文献未提及具体实验产品,领域常规使用基因本体富集分析工具(如clusterProfiler)、机器学习软件(如LightGBM)等。
3.3 翻译缓冲对蛋白丰度稳定性的影响
实验目的:验证翻译缓冲是否能够降低蛋白丰度的变异,维持蛋白稳态。
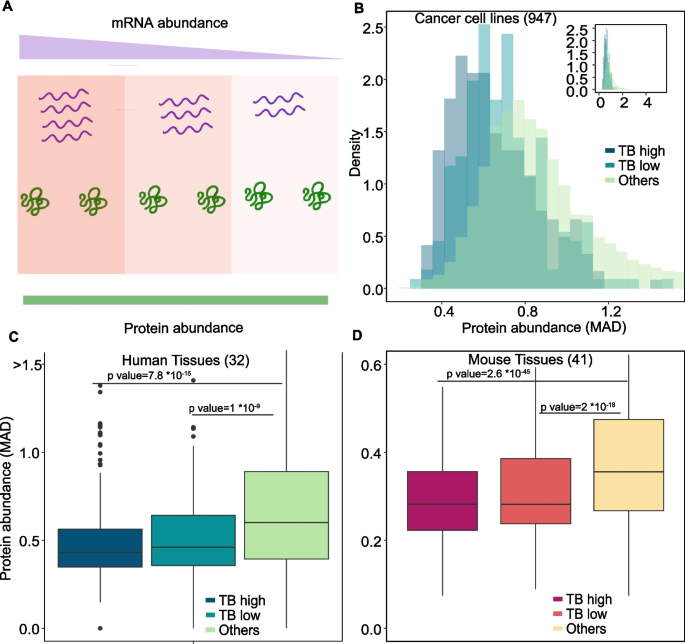
方法细节:利用人类949个癌细胞系、32个人类组织、41个小鼠组织的质谱数据,计算每个基因蛋白丰度的MAD;匹配TB组与非TB组的mRNA丰度MAD,比较两组的蛋白丰度MAD差异。
结果解读:TB high和TB low基因的蛋白丰度MAD显著低于Others组,在人类癌细胞系中,TB high vs Others的p值为5×10⁻³⁹(n=221 vs 7954),TB low vs Others为3×10⁻²³(n=202 vs 7954)(Fig3 B-D);即使匹配mRNA丰度MAD后,TB组的蛋白丰度MAD仍显著更低,说明翻译缓冲独立于mRNA丰度变异,直接降低蛋白丰度波动。
产品关联:文献未提及具体实验产品,领域常规使用液相色谱-质谱联用(LC-MS/MS)系统、蛋白组学分析软件等。
3.4 翻译缓冲基因的剂量敏感性分析
实验目的:探究翻译缓冲基因与基因剂量敏感性的关系,解析其功能意义。
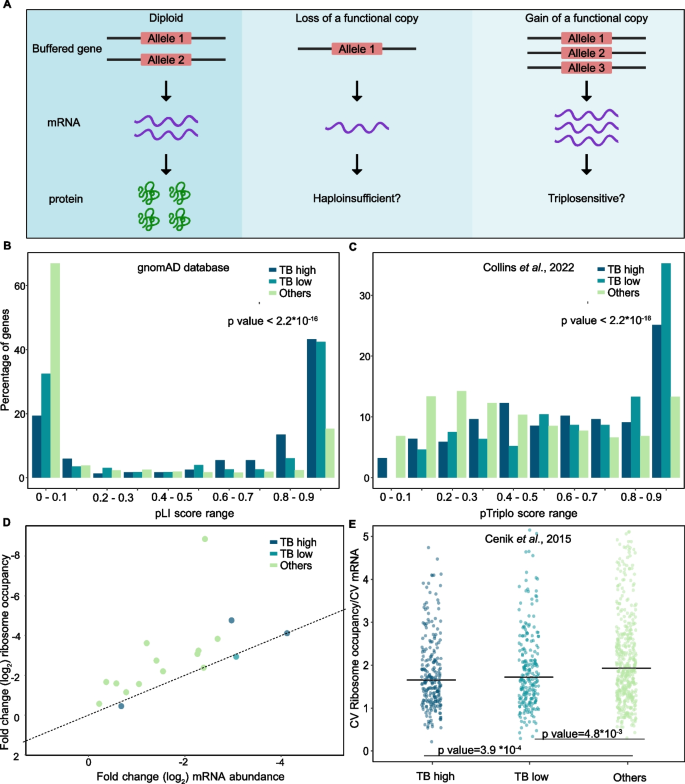
方法细节:利用gnomAD数据库的pLI评分(单倍剂量不足概率)、Collins等的pHaplo和pTriplo评分(单倍/三倍体敏感性),分析TB组与非TB组的剂量敏感性差异;分析siRNA/CRISPR knockdown实验中,TB基因的mRNA与核糖体占据率的变化;利用淋巴母细胞系的自然变异数据,分析生理范围内mRNA波动时的翻译缓冲效应。
结果解读:TB high基因的pLI评分中位数为0.86(n=238),显著高于非TB组的0.0018(n=18728,p<2.2×10⁻¹⁶),pHaplo和pTriplo评分也显著更高,说明翻译缓冲基因更可能是剂量敏感基因(Fig4 B-C);siRNA/CRISPR knockdown导致的mRNA大幅降低(约50%)无法被翻译缓冲抵消,核糖体占据率随mRNA成比例降低(Fig4 D);而在生理范围内的mRNA波动中,TB high基因的核糖体占据率变异显著低于非TB组(人类TB high vs Others,p=3.9×10⁻⁴,n=235 vs 457),说明翻译缓冲主要应对生理范围内的转录波动。
产品关联:文献未提及具体实验产品,领域常规使用CRISPR/Cas9系统、siRNA试剂、细胞系培养试剂等。
3.5 翻译缓冲的机制探究
实验目的:探究翻译缓冲的潜在分子机制,提出并验证模型。
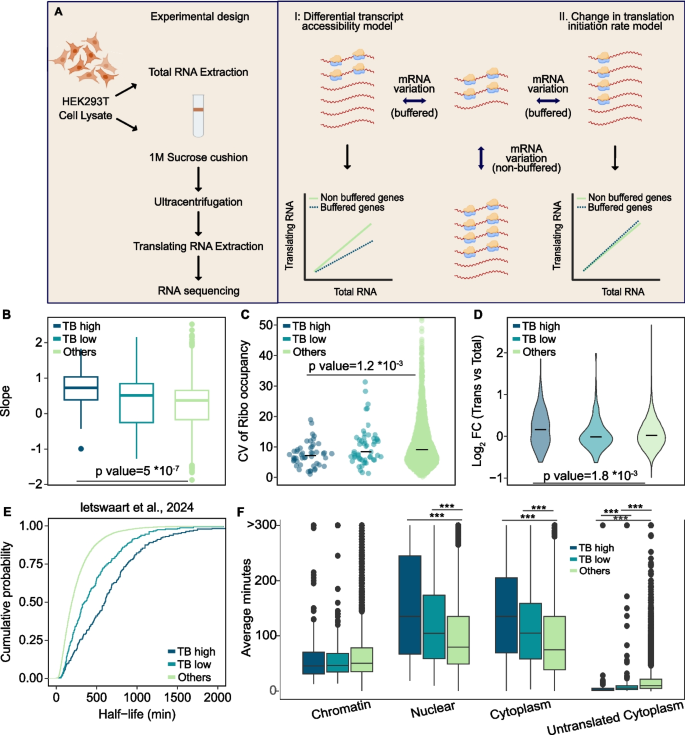
方法细节:在HEK293T细胞中分离总RNA和翻译RNA,进行测序分析,计算总RNA与翻译RNA的线性回归斜率,分析翻译缓冲基因的转录本可及性;检测核糖体占据率的变异系数(CV);利用TimeLap-seq数据,分析mRNA在不同亚细胞结构中的半衰期。
结果解读:TB high基因的总RNA与翻译RNA的斜率显著高于非TB组(n=48 vs 2157,p=5×10⁻⁷),说明其转录本更易进入翻译池(Fig5 B);同时TB high基因的核糖体占据率CV更低(n=48 vs 2153,p=1.2×10⁻³),提示翻译起始速率随mRNA丰度变化而调节,支持“差异转录本可及性模型”和“翻译起始速率模型”;TB high基因的mRNA半衰期更长(中位数625 min,n=249),显著高于非TB组的195 min(n=17670,p=2×10⁻⁶⁰),在细胞质中停留时间更久,更快结合多聚核糖体(Fig5 E-F),说明转录本的亚细胞动力学参与翻译缓冲。
产品关联:实验所用关键产品:ATCC的HEK293T细胞系、GIBCO的DMEM培养基、GeminiBio的胎牛血清、Zymo Research的RNA提取试剂盒、NEB的文库构建试剂盒、Illumina的NovaSeqX Plus测序平台等。
4. Biomarker研究及发现成果解析
本研究中的Biomarker为具有翻译缓冲功能的基因,属于功能型Biomarker,其筛选逻辑为“大规模多组学数据计算鉴定-跨物种验证-功能验证”,核心成果是揭示了翻译缓冲基因的保守性、特征及功能意义,为转录后调控与蛋白稳态的研究提供了新的靶点。
Biomarker定位:本研究鉴定的翻译缓冲基因属于转录后调控功能型Biomarker,筛选逻辑为:基于人和小鼠的大规模核糖体图谱与RNA-seq数据,通过mRNA-TE负相关和核糖体占据率/MAD比值两个标准筛选得到TB high、TB low基因;随后通过跨物种同源基因比较、蛋白组学验证、剂量敏感性分析、细胞实验验证进行多层面验证,形成完整的“筛选-验证”链条。
研究过程详述:Biomarker的来源为人和小鼠的细胞系、组织样本的转录组与翻译组数据;验证方法包括:跨物种同源基因比较(人和小鼠共享126个TB high基因,Fisher精确检验OR=83.4,p<2.2×10⁻¹⁶)、蛋白组学数据验证(蛋白丰度变异显著降低)、数据库验证(剂量敏感性评分显著更高)、细胞实验验证(转录本可及性和亚细胞半衰期分析);特异性方面,TB high基因富集于核糖体、RNA结合、蛋白酶体等核心功能复合物,具有短CDS、高密码子适应指数、高mRNA表达水平等独特序列特征;敏感性方面,在生理范围内的mRNA波动中,TB high基因的核糖体占据率变异显著低于非TB组(人类TB high vs Others,p=3.9×10⁻⁴)。
核心成果提炼:翻译缓冲基因的功能关联为维持蛋白稳态,降低蛋白丰度变异,作为剂量敏感基因的转录后保护机制;创新性在于首次系统鉴定哺乳动物的翻译缓冲基因,揭示其跨物种保守性和共同特征,提出两种机制模型;关键统计学结果包括:人和小鼠同源基因的mRNA-TE相关性为0.6(p<2.2×10⁻¹⁶),TB high基因的蛋白丰度MAD在人类癌细胞系中比非TB组低(p=5×10⁻³⁹),TB high基因的pLI评分中位数为0.86(显著高于非TB组的0.0018,p<2.2×10⁻¹⁶)。