

1. 领域背景与文献
文献英文标题:scArchon: a comprehensive benchmarking platform for single-cell perturbation response prediction tools;
发表期刊:文献未明确提供;影响因子:文献未明确提供;研究领域:单细胞转录组学、机器学习在生命科学中的应用
单细胞转录组学技术自2010年以来逐步成熟,为解析细胞异质性提供了关键手段;2015年起,机器学习方法开始广泛应用于单细胞数据分析,其中细胞对药物、感染等扰动的响应预测成为个性化医疗领域的研究热点。当前领域内已开发多种机器学习工具用于单细胞扰动响应预测,但存在核心问题:现有工具的基准测试不系统,不同研究采用的数据集、指标和实验设计不一致,导致工具性能对比缺乏公平性和可重复性;部分工具仅关注统计指标,忽略生物学相关性评估,无法验证预测结果的生物学合理性;跨物种扰动预测的能力尚未得到充分验证,成为领域内未解决的关键挑战。
领域内缺乏全面、可重复的基准测试框架,无法系统比较不同工具在统计准确性和生物学相关性方面的性能,也无法为研究者选择合适工具提供可靠依据。本文的研究初衷是开发scArchon平台,构建标准化的基准测试流程,系统评估9种主流单细胞扰动预测工具的性能,揭示工具在不同场景下的优势与局限性,为领域提供统一的性能评估标准,推动单细胞扰动预测技术的发展与应用。
2. 文献综述解析
作者对领域内现有研究的分类维度为工具的机器学习架构类型,包括变分自编码器(variational autoencoder, VAE)类、最优传输(optimal transport, OT)类、生成对抗网络(generative adversarial network, GAN)类等,同时从基准测试的全面性、评估指标的多样性、生物学相关性的重视程度三个方面评述现有研究的局限性。
现有研究的关键结论是机器学习工具能够在一定程度上预测单细胞对扰动的转录组响应,但不同工具的性能差异显著,部分工具的泛化能力不足;技术方法优势方面,变分自编码器类工具如scGen、trVAE具备高效的降维和特征提取能力,最优传输类工具如scPRAM、scVIDR能够精准捕捉细胞分布的映射关系,生成对抗网络类工具如scPreGAN擅长生成符合分布的细胞状态;局限性包括现有基准测试研究覆盖的工具和数据集有限,多采用单一统计指标进行评估,缺乏对生物学相关性的系统验证,部分工具的性能甚至不如简单的线性模型,且存在“生物学幻觉”现象,即生成看似合理但不符合真实生物学信号的预测结果。
现有研究未解决的核心问题是缺乏统一的基准测试框架,无法公平比较不同工具的综合性能,尤其是生物学相关性方面的评估缺失。本研究的创新点在于首次构建了涵盖统计、生物学多维度指标的全面基准测试平台scArchon,系统比较了9种主流工具在6个不同复杂度数据集上的性能,揭示了工具在不同指标下的性能差异,尤其是统计指标与生物学指标排名的低相关性,强调了生物学评估的必要性,填补了领域内缺乏标准化基准测试框架的空白,为工具的选择和优化提供了科学依据。
3. 研究思路总结与详细解析
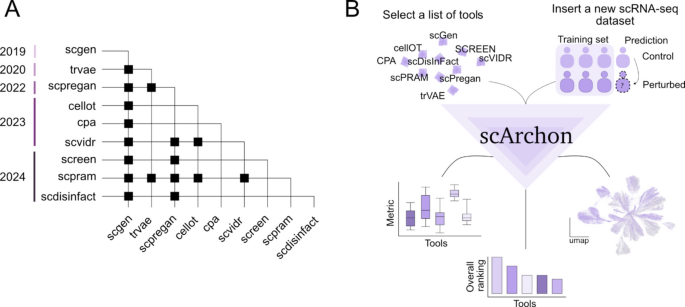
本研究的整体框架为:以分布外预测为核心任务,选择9种代表性机器学习工具和6个多样化数据集,通过留一法交叉验证构建标准化基准测试流程,从降维可视化、统计准确性、生物学相关性三个维度综合评估工具性能,系统分析工具在不同场景下的优势与局限性,并验证scArchon平台的鲁棒性和可扩展性。研究目标是开发并验证scArchon作为单细胞扰动响应预测工具的权威基准测试平台,核心科学问题是如何公平、全面地评估工具的综合性能,尤其是平衡统计准确性与生物学相关性,技术路线形成“任务定义→工具与数据集选择→标准化测试→多维度评估→性能分析→平台验证”的完整闭环。
3.1 基准测试实验设计与数据集选择
实验目的是建立统一的实验流程,确保所有工具在相同任务和条件下进行公平比较,消除原有研究中实验设计不一致带来的偏差。方法细节:作者选择了9种主流单细胞扰动响应预测工具,涵盖变分自编码器、最优传输、生成对抗网络及解耦架构等多种机器学习类型;同时选取6个公开数据集,包括人类外周血单个核细胞干扰素处理、小鼠肠道上皮细胞寄生虫感染、跨物种脂多糖刺激、胶质母细胞瘤药物处理等,覆盖不同细胞类型、扰动类型和物种,确保测试场景的多样性。实验采用留一法交叉验证的分布外预测任务,即训练时排除一个协变量(如细胞类型、患者、物种),将其作为测试集,验证模型对未见过的群体的泛化能力。结果解读:通过统一的实验设计,所有工具在相同的任务设置和数据集上进行测试,避免了原有研究中因实验条件不同导致的性能对比偏差;不同数据集的复杂度差异为评估工具的鲁棒性提供了场景,例如胶质母细胞瘤数据集的患者异质性更高,能够测试工具在复杂临床场景下的性能。产品关联:文献未提及具体实验产品,领域常规使用单细胞转录组分析工具(如Scanpy、Seurat)、机器学习框架(如PyTorch、TensorFlow)及容器化部署工具(如Docker、Singularity)。
3.2 多维度性能评估方法建立
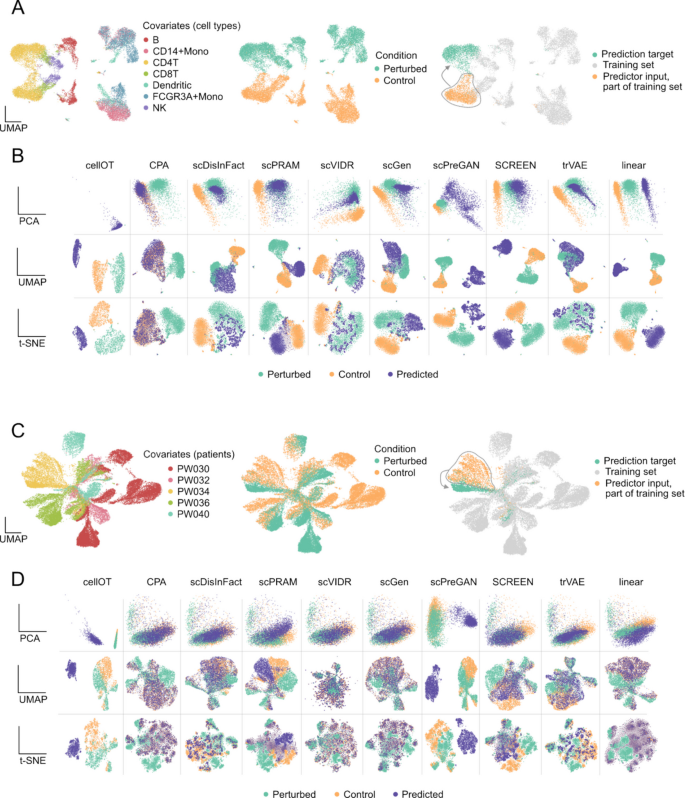
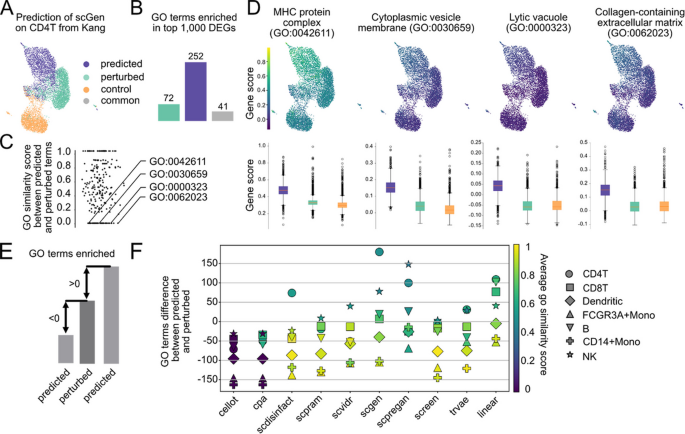
实验目的是全面评估工具的性能,不仅关注统计准确性,还验证预测结果的生物学相关性,避免单一指标带来的评估偏差。方法细节:作者采用三类评估方法,一是降维可视化,包括主成分分析(principal component analysis, PCA)、均匀流形近似与投影(uniform manifold approximation and projection, UMAP)、t分布邻域嵌入(t-distributed stochastic neighbor embedding, t-SNE),用于直观比较预测细胞与真实扰动细胞的分布重叠;二是统计指标,包括均方误差(mean squared error, MSE)、Wasserstein距离、t检验得分、决定系数(R²)等,量化预测结果与真实结果的统计一致性;三是生物学指标,包括差异表达基因(differentially expressed genes, DEGs)重叠度、基因集富集分析(gene set enrichment analysis, GSEA)、语义相似性分析,验证预测结果的生物学合理性。结果解读:降维可视化显示不同方法对结果的解读存在差异,例如scPRAM在主成分分析中表现出良好的重叠,但在均匀流形近似与投影中与真实扰动细胞分离,说明单一降维方法无法全面反映工具性能;统计指标揭示部分工具(如CellOT、CPA)的性能不如线性模型,而trVAE、scGen等工具表现稳定;生物学指标发现部分工具(如scGen、scPreGAN)存在“生物学幻觉”,生成的基因集富集项与真实扰动的语义相似性为0,且相关基因的表达与真实扰动存在显著差异(Mann–Whitney U检验,P<0.01)。产品关联:文献未提及具体实验产品,领域常规使用基因集富集分析工具(如GSEApy)、语义相似性分析工具(如GOSemSim)及统计分析软件(如R、Python)。
3.3 工具性能系统分析与综合排名
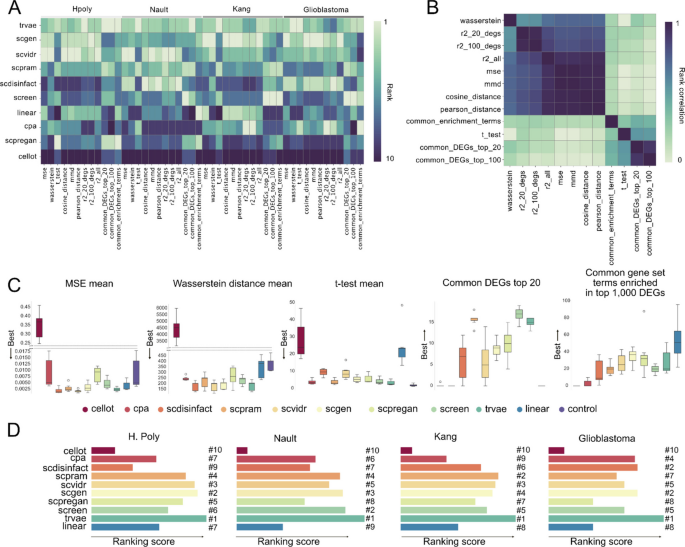
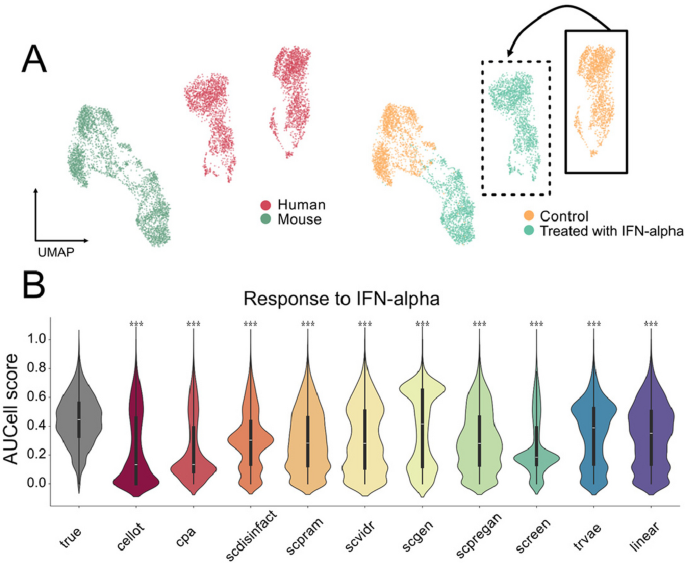
实验目的是系统比较不同工具在多个数据集和指标下的性能,确定工具的适用场景和综合排名,为研究者提供选择依据。方法细节:作者对每个数据集的每个预测fold计算评估指标,然后对工具进行排名;为避免指标相关性带来的偏差,选择5个低相关的指标(前2000高可变基因的R²、Wasserstein距离、t检验得分、前20差异表达基因重叠度、基因集富集重叠度)进行综合排名,将排名转换为0-1的分数,分数越高表示性能越好。结果解读:综合排名显示trVAE的整体性能最优,scGen、scPRAM、scVIDR表现稳定,在不同数据集上均排名靠前;部分工具(如CellOT、CPA)的性能在多个场景下不如线性模型;跨物种扰动预测任务中,所有工具的性能均不理想,预测的干扰素响应通路活性与真实结果存在显著差异(Kolmogorov–Smirnov检验,P<0.001),说明跨物种扰动预测仍是领域内的重大挑战;统计指标与生物学指标的排名相关性较低(<0.5),凸显了同时评估统计准确性和生物学相关性的重要性。产品关联:文献未提及具体实验产品,领域常规使用数据可视化工具(如Matplotlib、Seaborn)及统计分析库(如Pandas、NumPy)。
3.4 工具鲁棒性与平台可扩展性验证
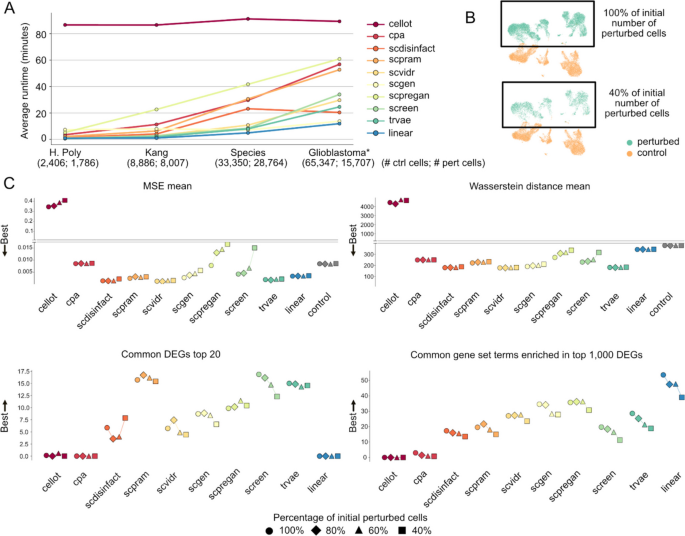
实验目的是测试工具的计算效率和鲁棒性,以及scArchon平台的可扩展性和易用性,确保平台能够适应不同规模的数据集和新工具的加入。方法细节:作者进行了两类消融实验,一是逐步减少扰动细胞的数量(至80%、60%、40%),测试工具在数据量减少时的性能变化;二是逐步减少基因数量(至15000、7000高可变基因),测试工具对输入基因集大小的敏感性;同时测试工具的运行时间,评估计算效率;验证scArchon的容器化架构,确保工具在不同环境下的可重复性。结果解读:大部分工具的运行时间随数据集大小线性增加,CellOT的运行时间恒定且最长;消融实验显示大部分工具在数据量减少时性能稳定,但生物学指标(如基因集富集重叠度)有所下降;scArchon的容器化架构解决了工具间的环境兼容性问题,支持添加新工具和数据集,具备良好的可扩展性。产品关联:文献未提及具体实验产品,领域常规使用容器化平台(如Docker、Singularity)及性能测试工具(如time命令)。
4. Biomarker研究及发现成果解析
本文中的Biomarker指用于评估单细胞扰动预测工具生物学相关性的关键指标,包括差异表达基因、基因本体(Gene Ontology, GO)术语、癌症特征基因集等,通过与真实扰动下的金标准进行对比,验证预测结果的生物学合理性。
Biomarker定位:本文的Biomarker类型为性能评估类生物学指标,筛选逻辑为:以真实扰动下的差异表达基因和基因集富集项作为金标准,计算预测结果与金标准的重叠度和语义相似性,评估工具捕捉真实生物学信号的能力;验证逻辑为:通过差异基因分析、基因集富集分析、语义相似性分析,从基因水平和通路水平验证预测结果的生物学相关性。
研究过程详述:Biomarker的来源为6个数据集的真实扰动和预测扰动的单细胞转录组数据,验证方法包括:采用t检验识别差异表达基因,计算预测与真实差异表达基因的重叠度;采用GSEApy进行基因集富集分析,计算预测与真实富集项的重叠度;采用GOSemSim计算预测与真实基因本体术语的语义相似性;特异性与敏感性数据方面,在Kang数据集,线性模型的基因本体术语重叠度为54个(文献未明确提供样本量,基于图表趋势推测),scGen为35个,部分工具预测的基因本体术语与真实术语的语义相似性为0,且相关基因的表达在预测与真实扰动间存在显著差异(Mann–Whitney U检验,P<0.01);跨物种实验中,所有工具预测的干扰素响应通路AUCell分数与真实结果存在显著差异(Kolmogorov–Smirnov检验,P<0.001)。
核心成果提炼:该Biomarker评估体系的功能关联为能够有效区分工具的生物学性能,识别存在“生物学幻觉”的工具;创新性在于首次系统建立了单细胞扰动预测工具的生物学相关性评估框架,揭示了统计指标与生物学指标的低相关性,强调了生物学评估的必要性;统计学结果包括:在Kang数据集,scGen预测的基因本体术语数量为252个,而真实扰动仅为72个(文献未明确提供样本量,基于图表趋势推测);跨物种实验中,所有工具的AUCell分数分布与真实结果存在显著差异(P<0.001)。