

1. 领域背景与文献
文献英文标题:Genome-wide association studies of missing metabolite measures from two population-based studies;
发表期刊:文献未明确提供;影响因子:未公开;研究领域:代谢组学、基因组学、群体遗传学
代谢组学作为连接基因组与表型的核心桥梁,已成为生命科学领域的研究热点,近年高通量检测技术的突破实现了单次样本中数千种代谢物的同步分析,广泛应用于心血管疾病、代谢性疾病、神经退行性疾病等领域的机制研究与生物标志物开发。但该领域仍面临关键挑战:代谢组数据中普遍存在的缺失值生物学意义尚未明确,现有研究通常将其归因于随机误差、技术缺陷或浓度低于检测限,进而采用删除或插补的方式处理,却忽略了遗传变异可能导致代谢物真实缺失的可能性。先天性代谢缺陷(IEM)的研究已证实,罕见遗传变异可通过破坏代谢通路导致特定代谢物无法合成或分解,但常见遗传变异与代谢物缺失的关联尚未被系统探究,这一空白可能导致现有代谢组分析的生物学解释出现偏倚。本研究旨在验证常见遗传变异与代谢物缺失存在关联的假设,通过全基因组关联分析揭示其潜在生物学机制,为代谢组数据的合理分析与解读提供新的遗传视角。
2. 文献综述解析
本文献综述围绕代谢组缺失值的成因及遗传因素的潜在作用展开,作者将现有研究分为三类:一是代谢组缺失值的常规处理策略研究,二是罕见遗传变异导致代谢疾病的研究,三是常见遗传变异与代谢物水平关联的全基因组关联分析研究。
现有研究中,代谢组缺失值多被视为技术问题,处理方式以删除或插补为主,这类方法的优势是简化分析流程、降低计算复杂度,但局限性在于可能丢失由遗传因素驱动的关键生物学信息,导致研究结果出现偏倚。罕见遗传变异相关研究已明确IEM可通过破坏代谢通路导致代谢物缺失,这类研究的优势是直接揭示了遗传变异对代谢物存在性的调控作用,但局限性在于聚焦罕见突变,未覆盖常见遗传变异对人群中普遍存在的代谢物缺失的影响。常见遗传变异与代谢物水平的全基因组关联分析研究已鉴定大量代谢数量性状位点(mQTL),但所有研究均以代谢物浓度为表型,未关注代谢物缺失这一特殊表型,无法解释缺失值背后的遗传机制。通过对比现有研究的未解决问题,本研究的创新点在于首次将代谢物缺失作为独立表型开展全基因组关联分析,系统探究常见遗传变异与代谢物缺失的关联,填补了代谢组学与基因组学交叉领域的研究空白,为代谢组数据的解读提供了新的遗传维度。
3. 研究思路总结与详细解析
本研究的核心目标是验证常见遗传变异与代谢物缺失存在关联的假设,核心科学问题是遗传变异如何通过调控代谢通路导致代谢物缺失,技术路线遵循“假设提出→两项独立人群全基因组关联分析验证→跨研究meta分析整合→功能注释与候选基因鉴定→因果关联验证”的闭环逻辑。
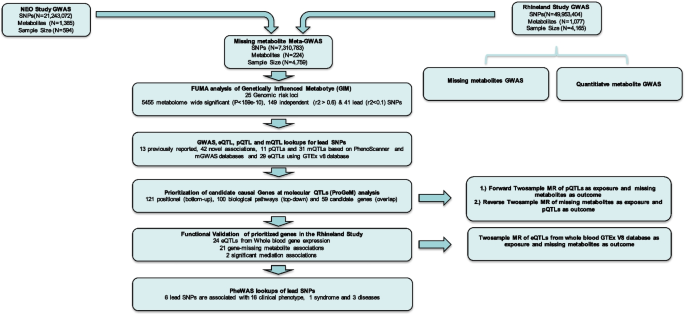
3.1 研究人群与样本选择
实验目的是筛选具有完整遗传与代谢组数据的同质人群,排除混杂因素以确保研究结果的可靠性。方法上,纳入荷兰肥胖流行病学研究(NEO)的594名45-65岁、BMI≥27kg/m²的欧洲血统参与者,以及德国莱茵兰研究(Rhineland Study)的4165名30岁以上欧洲血统参与者,排除非欧洲血统、遗传质量控制不合格、无法提供知情同意的样本,同时收集参与者的年龄、性别、空腹状态、糖尿病病史等临床信息。结果显示,两项人群的年龄、性别分布具有可比性,NEO研究采用血清样本,Rhineland研究采用血浆样本,后续分析均调整了年龄、性别、空腹状态、人群遗传结构等混杂因素。产品关联:文献未提及具体样本采集与保存产品,领域常规使用EDTA抗凝管、PAXgene RNA管等进行血液样本的采集与稳定化保存。
3.2 代谢组与基因组数据处理
实验目的是标准化代谢组与基因组数据,确定纳入分析的缺失代谢物范围,为后续关联分析提供可靠数据基础。代谢组数据处理方面,采用Metabolon HD4非靶向平台,结合反向相超高效液相色谱-串联质谱(RP-UPLC-MS/MS)、亲水相互作用液相色谱-串联质谱(HILIC-UPLC-MS/MS)技术检测代谢物,筛选缺失率在10%-90%之间的代谢物,排除缺失率过低(大概率为技术误差)或过高(依赖特定外源性暴露)的代谢物,最终NEO研究纳入341种代谢物,Rhineland研究纳入425种代谢物,两项研究重叠代谢物共224种。基因组数据处理方面,NEO研究采用Illumina HumanCoreExome-24 BeadChip进行基因分型,Rhineland研究采用Illumina Omni-2.5 exome array进行基因分型,经过样本质量控制、基因型impute(参考Haplotype Reference Consortium或1000 Genomes数据库)后,保留插补质量>0.3、次要等位基因频率(MAF)>0.01的SNP用于后续分析。结果显示,NEO研究纳入21243072个SNP,Rhineland研究纳入49953404个SNP,为全基因组关联分析提供了覆盖全面的遗传数据。产品关联:代谢组检测使用Metabolon HD4平台;基因分型使用Illumina HumanCoreExome-24 BeadChip、Illumina Omni-2.5 exome array;基因组分析常规使用PLINK、EIGENSTRAT、IMPUTE等软件进行质量控制与插补。
3.3 缺失代谢物全基因组关联分析
实验目的是鉴定与代谢物缺失表型相关的遗传变异。方法上,NEO研究使用SNPTEST v2软件进行logistic回归分析,Rhineland研究使用REGENIE v2.2软件进行Firth logistic回归分析,均调整年龄、性别、空腹状态、人群遗传主成分等混杂因素,代谢组学显著性阈值经多重检验校正后为p<1.58×10⁻¹⁰(NEO)和p<1.59×10⁻¹⁰(Rhineland),同时开展定量代谢物全基因组关联分析作为敏感性分析,对比缺失表型与浓度表型的遗传关联差异。结果显示,NEO研究鉴定到537个SNP与6种代谢物缺失关联,Rhineland研究鉴定到2615个SNP与32种代谢物缺失关联;敏感性分析显示17种代谢物的缺失关联SNP未在定量全基因组关联分析中出现,提示这些关联是缺失表型特有的,无法通过代谢物浓度的遗传研究解释。产品关联:全基因组关联分析使用SNPTEST v2、REGENIE v2.2软件,领域常规使用此类工具开展复杂表型的全基因组关联分析。
3.4 跨研究meta分析与遗传位点聚类
实验目的是整合两项人群的全基因组关联分析结果,提高统计效力,鉴定独立的遗传位点。方法上,对重叠的224种代谢物采用固定效应模型进行meta分析,使用METAL软件实现,显著性阈值为p<1.59×10⁻¹⁰,通过Functional Mapping and Annotation(FUMA)平台进行连锁不平衡(LD)聚类(r²<0.1)得到独立的lead SNPs。结果显示,meta分析鉴定到3260个SNP与33种代谢物缺失关联,聚类得到41个独立lead SNPs,对应55个SNP-代谢物缺失关联,其中42个为未被报道的新关联;这些关联集中在类固醇、氨基酸、脂肪酸、胆汁酸代谢通路及外源性物质代谢,跨人群的效应方向高度一致(Pearson相关R²=0.92),提示结果具有可靠性。
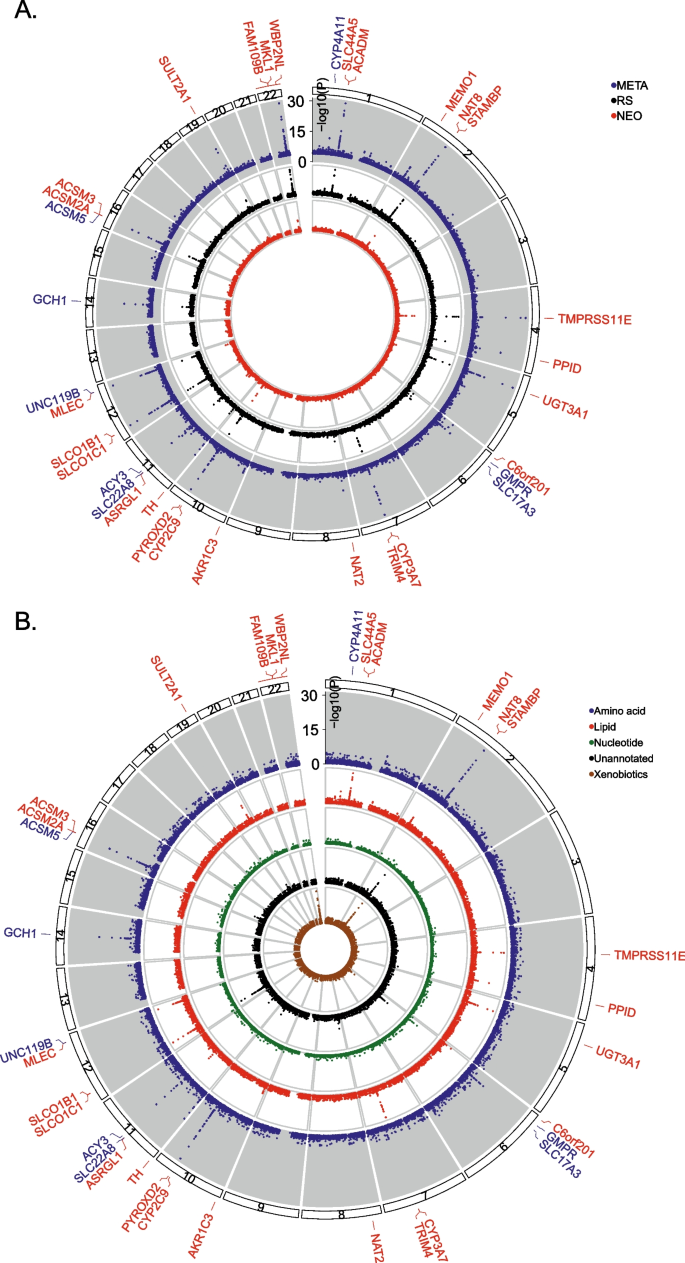
3.5 候选基因鉴定与功能验证
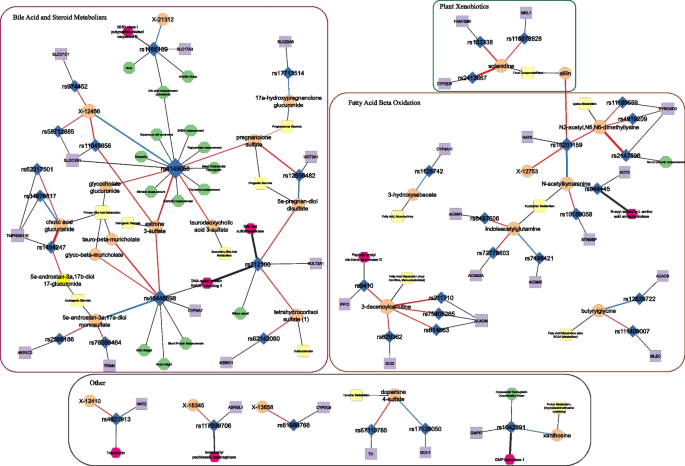
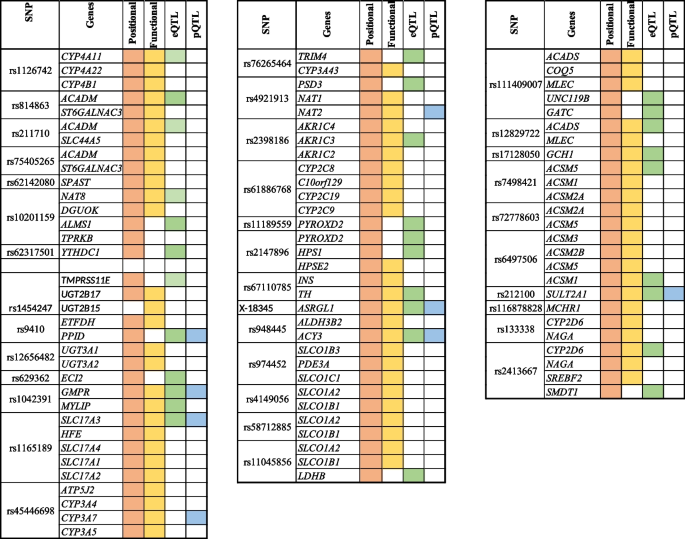
实验目的是解析lead SNPs对应的候选基因及潜在调控机制,验证遗传变异与代谢物缺失的生物学关联。方法上,使用“Prioritization of candidate causal Genes at Molecular QTLs”(ProGeM)框架,通过位置邻近性与生物学相关性两种方法鉴定候选基因;结合Genotype-Tissue Expression(GTEx)数据库分析表达数量性状位点(eQTL),通过Phenoscanner数据库分析蛋白数量性状位点(pQTL);同时在Rhineland研究的2575名参与者中开展基因表达、SNP与代谢物缺失的中介分析,探究基因表达的介导作用。结果显示,41个lead SNPs对应25个基因组风险位点,通过ProGeM鉴定到59个候选基因;eQTL分析鉴定到29个关联,例如rs2413667是CYP2D6(外源性物质代谢关键酶)在脂肪组织的eQTL;pQTL分析鉴定到5个lead SNPs与7种蛋白关联;中介分析显示HPS1基因部分介导rs2147896与N2-acetyl,N6,N6-dimethyllysine缺失的关联(介导效应2.8%,FDR校正p=0.04)。
3.6 孟德尔随机化与疾病关联分析
实验目的是验证遗传变异、基因表达与代谢物缺失的因果关联,以及代谢物缺失与疾病的潜在关联。方法上,采用两样本孟德尔随机化(MR)分析eQTL与pQTL对代谢物缺失的因果效应,同时以N2-acetyl,N6,N6-dimethyllysine缺失为暴露,2型糖尿病为结局开展MR分析,评估代谢物缺失与疾病的潜在因果关系。结果显示,eQTL MR鉴定到ACADM与3-decenoylcarnitine缺失、CYP2D6与茄啶缺失的因果关联;pQTL MR鉴定到RAD51D与5alpha-androstan-3alpha,17alpha-diol monosulfate缺失的因果关联;代谢物缺失与2型糖尿病的MR分析显示,N2-acetyl,N6,N6-dimethyllysine非缺失与2型糖尿病风险降低相关(IVW β=-0.03,p=0.04)。产品关联:孟德尔随机化分析使用Two Sample Mendelian Randomization R包、Radial MR R包,领域常规使用此类工具开展遗传与表型的因果关联推断。
4. Biomarker研究及发现成果
本研究鉴定的Biomarker为与代谢物缺失关联的41个独立lead SNPs,这些SNP通过两项人群全基因组关联分析、meta分析及多维度功能验证筛选得到,涉及28种代谢物的55个遗传关联,其中42个为未被报道的新关联。
该Biomarker的筛选逻辑为:首先在两项独立人群中开展代谢物缺失表型的全基因组关联分析,筛选达到代谢组学显著性的SNP;随后通过跨研究meta分析整合结果,提高统计效力并减少人群特异性偏倚;再通过连锁不平衡聚类得到独立的lead SNPs,避免关联信号的冗余;最后结合功能注释、eQTL、pQTL、中介分析及孟德尔随机化验证其生物学功能与因果关联。研究过程中,样本为NEO研究(n=594)和Rhineland研究(n=4165)的欧洲血统人群,代谢组采用非靶向液相色谱-串联质谱技术检测,基因组经分型、插补后开展全基因组关联分析,meta分析采用固定效应模型,功能验证结合公共数据库与人群转录组数据。特异性与敏感性方面,这些lead SNPs的关联均达到代谢组学显著性(p<1.59×10⁻¹⁰),跨人群的效应方向高度一致(Pearson相关R²=0.92),提示结果具有良好的可靠性与重复性。
核心成果方面,这些Biomarker主要富集在β-氧化、胆汁酸、类固醇、外源性物质代谢通路,例如rs4149056(位于SLCO1B1基因区域)与5种代谢物缺失关联,涉及类固醇与胆汁酸代谢通路;rs2413667(位于CYP2D6基因的eQTL区域)与茄啶缺失关联,推测:该SNP可作为药物代谢能力的潜在标志物,用于识别药物代谢异常人群。部分Biomarker还与疾病存在关联,例如rs4149056与鳞状细胞癌关联,N2-acetyl,N6,N6-dimethyllysine缺失与2型糖尿病风险升高相关(IVW β=-0.03,p=0.04)。这些发现不仅揭示了代谢物缺失的遗传调控机制,还为代谢组数据的精准解读、疾病风险预测及个性化医疗提供了新的Biomarker资源。