

1. 领域背景与文献
文献英文标题:Comparing machine learning methods predicting transcriptome from epigenome with applications to association studies;
发表期刊:未公开;影响因子:未公开;研究领域:表观基因组学、计算生物学、疾病关联研究
表观基因组调控是细胞转录和发育的核心机制,ChIP-seq技术的发展使得全基因组组蛋白修饰检测成为常规手段,其中H3K27ac作为活性调控区域的标记,被广泛应用于组蛋白乙酰化全基因组关联研究(HAWAS)以解析疾病相关的调控元件。当前研究热点集中于利用机器学习模型构建表观基因组与转录组的关联,从而实现从表观组数据预测基因表达,并挖掘疾病相关的调控机制。然而,现有研究存在两大核心问题:一是缺乏对基因特异性机器学习方法的系统比较,不同方法在预测性能、可解释性和泛化能力上的差异尚不明确;二是如何将这些预测模型有效应用于疾病关联研究,实现从表观组数据直接识别疾病相关基因和调控区域的方法仍需完善。
针对上述研究空白,本研究旨在系统比较五种基因特异性机器学习方法在表观基因组(H3K27ac)预测转录组任务中的性能,解析影响模型性能的基因特征,验证模型的生物学有效性,并提出基于最优模型的HAWAS新方法,为疾病关联研究提供高效的计算工具。
2. 文献综述解析
作者对领域内现有研究的分类维度为模型是否具有基因特异性,将其分为基因无关模型和基因特异性模型两类。
现有研究中,基因无关模型将所有基因视为等价训练实例,利用单个样本中大量基因的表观组和转录组数据训练模型,其优势在于无需大量生物学样本,能快速学习表观组与转录组的全局关联;但局限性是无法捕捉基因特异性的调控结构,如顺式调控元件(CRE)的精确位置和调控强度。基因特异性模型则为每个基因单独训练模型,利用多样本的表观组和转录组数据,其优势在于能捕捉不同组织、细胞类型或个体间的基因调控差异,特别适合疾病队列研究;但局限性是需要大规模数据集支撑,计算成本高,且此前多依赖简单线性模型,对非线性调控关系的捕捉能力不足。
通过对比现有研究的未解决问题,本研究的创新价值凸显:首次在包含965个样本、51种细胞类型的大规模IHEC EpiATLAS数据集上,系统比较五种基因特异性机器学习方法(CRE-RF、CRE-MLP、Binned-RF、Binned-CNN、STITCHIT)的预测性能;创新性地采用in silico perturbation方法解析模型的调控区域识别能力,并结合CRISPRi和eQTL数据验证模型的生物学有效性;提出基于机器学习模型的两步HAWAS方法,实现从表观组数据直接识别疾病相关基因和调控区域,弥补了传统HAWAS方法在基因关联准确性上的不足。
3. 研究思路总结与详细解析
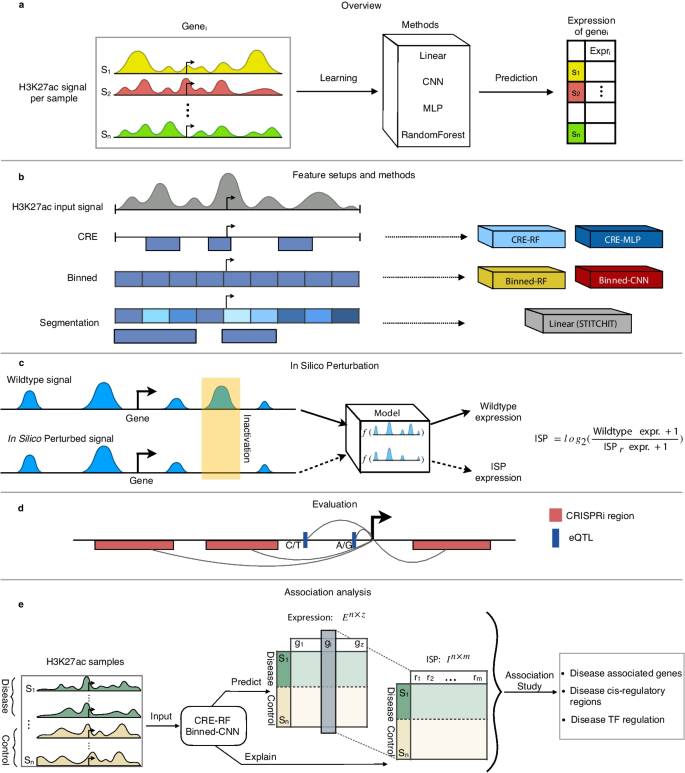
本研究的整体框架为:以大规模表观组-转录组数据集为基础,构建三种特征输入策略,训练并优化五种基因特异性机器学习模型;通过性能评估、基因特征关联分析和外部验证,筛选出最优模型;最终将最优模型应用于慢性淋巴细胞白血病(CLL)和结肠腺癌的HAWAS研究,识别疾病相关基因、调控区域及关键转录因子(TF)。核心科学问题聚焦于如何构建准确、可解释的基因特异性表观组-转录组预测模型,以及如何将这些模型转化为疾病关联研究的实用工具。技术路线遵循“数据准备→模型训练→性能解析→验证优化→疾病应用”的闭环逻辑。
3.1 数据集与特征设置
实验目的:构建标准化的训练测试数据集,定义不同的特征输入策略以适配各类机器学习模型,为后续模型比较奠定基础。
方法细节:使用IHEC EpiATLAS数据库中965个同时包含H3K27ac ChIP-seq和RNA-seq数据的人类样本(覆盖51种细胞类型/组织);通过过滤保留28180个表达变异≥2且90%样本非零表达的基因;定义三种特征策略:CRE策略采用ENCODE数据库的候选顺式调控元件(基因TSS周围1MB窗口),binned策略将基因TSS周围1MB窗口划分为100bp非重叠bins,segmentation策略由STITCHIT算法自动将binned信号合并为调控片段;所有数据进行log2转换和标准化处理,避免信息泄露。
结果解读:三种特征策略提供了不同维度的调控信息,CRE策略利用已知生物学注释减少噪声,binned策略提供无偏的空间基因组信号,segmentation策略由算法自适应识别调控单元;不同特征策略的输入维度差异显著,CRE策略平均每个基因对应约200个特征,binned策略对应10000个特征。
产品关联:文献未提及具体实验产品,领域常规使用ChIP-seq文库构建试剂盒、RNA-seq测序服务,以及Python/R的生物信息学分析库(如pybedtools、DESeq2)。
3.2 机器学习模型训练与优化
实验目的:训练五种基因特异性机器学习模型,并针对每个基因进行参数优化,确保模型性能的可靠性和可比性。
方法细节:五种模型包括:CRE-RF(基于CRE特征的随机森林模型)、CRE-MLP(基于CRE特征的多层感知机,含单/双隐藏层及注意力机制变体)、Binned-RF(基于binned特征的随机森林)、Binned-CNN(基于binned特征的卷积神经网络,含收缩/扩展核拓扑及warm start初始化)、STITCHIT(分段特征+弹性网回归);采用80:20随机样本划分训练测试集,对每个基因单独进行参数调优,如CRE-MLP的学习率、 dropout率,Binned-CNN的卷积核大小、步长等。
结果解读:CRE-RF和Binned-CNN表现最优,其中CRE-RF的高相关模型(Pearson相关系数≥0.7)占比41%,失败模型仅1%;Binned-CNN的高相关模型占比40%,两者的均方误差(MSE)分别为3.8和3.85;CRE-MLP的误差最高(中位数MSE 4.19),STITCHIT因内部表达离散化过滤导致11547个基因无法生成模型;注意力机制对CRE-MLP的性能提升有限,且训练时间增加约30%。
产品关联:文献未提及具体实验产品,领域常规使用Python的scikit-learn、Keras库,R的randomForest、keras包实现模型训练。

3.3 模型性能与基因特征关联分析
实验目的:解析影响模型预测性能的基因内在特征,揭示不同方法的适用场景。
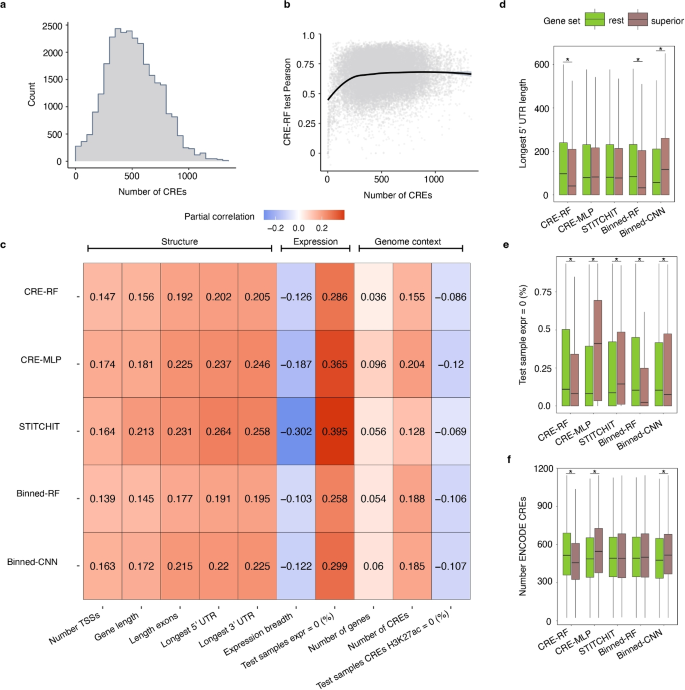
方法细节:将模型性能分为高(相关系数≥0.7)、中(≥0.3)、低(<0.3)三类;从基因结构(TSS数量、基因长度、5’/3’UTR长度等)、表达模式(表达广度、测试样本中零表达比例)、基因组上下文(周围基因数量、CRE数量等)三个维度,通过偏相关分析排除混杂因素,评估各特征与模型性能的关联;比较不同方法最优基因的特征分布差异。
结果解读:所有模型中,测试样本零表达比例与性能呈正相关(偏相关系数0.2-0.3),表达广度与性能呈负相关(偏相关系数-0.15至-0.25);基因结构特征中,5’UTR长度与性能正相关,蛋白编码基因的预测准确性显著高于非编码RNA和假基因(P<0.001,n=28180);基因组上下文特征对性能的影响较弱,CRE数量仅在≤300时与性能正相关;Binned-CNN在5’UTR较长的基因上表现更优,CRE-MLP在零表达样本比例高、CRE数量多的基因上性能更突出。
产品关联:文献未提及具体实验产品,领域常规使用R的psych包进行偏相关分析,ggplot2进行可视化。
3.4 模型解释与外部生物学验证
实验目的:解析模型识别的调控区域的生物学意义,验证模型的预测结果与实验数据的一致性。
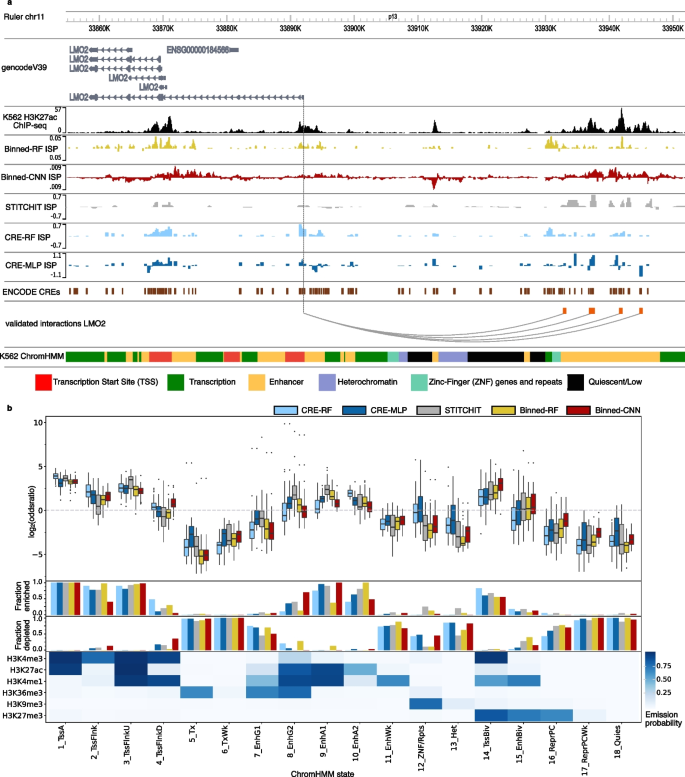
方法细节:采用in silico perturbation方法,将单个调控区域的H3K27ac信号设为零,计算模型预测表达与野生型表达的log2比值(ISP),评估该区域对基因表达的调控作用;将高ISP区域与ChromHMM注释的染色质状态进行富集分析;利用K562细胞的CRISPRi验证数据构建精确召回(PR)曲线,评估模型识别真实CRE-基因相互作用的能力;利用GTEx的eQTL数据,通过基因集富集分析(GSEA)评估模型对eQTL支持的调控相互作用的富集程度。
结果解读:高ISP区域与ChromHMM注释的活性TSS和增强子状态显著富集(log2 odds ratio≥2,P<0.001),与沉默染色质状态显著负相关;CRISPRi验证中,CRE-RF的精确召回曲线下面积(AUPRC)最高(0.38,n=1099),STITCHIT次之(0.35);eQTL验证中,binned特征模型的富集得分更高,Binned-RF在82.5%的样本中富集得分最优。
产品关联:文献未提及具体实验产品,领域常规使用WashU Browser进行基因组可视化,pybedtools处理基因组坐标,GSEApy进行富集分析。
3.5 模型在未见过的细胞类型中的泛化能力评估
实验目的:评估模型在未见过的细胞类型中的预测性能,验证模型的泛化能力。
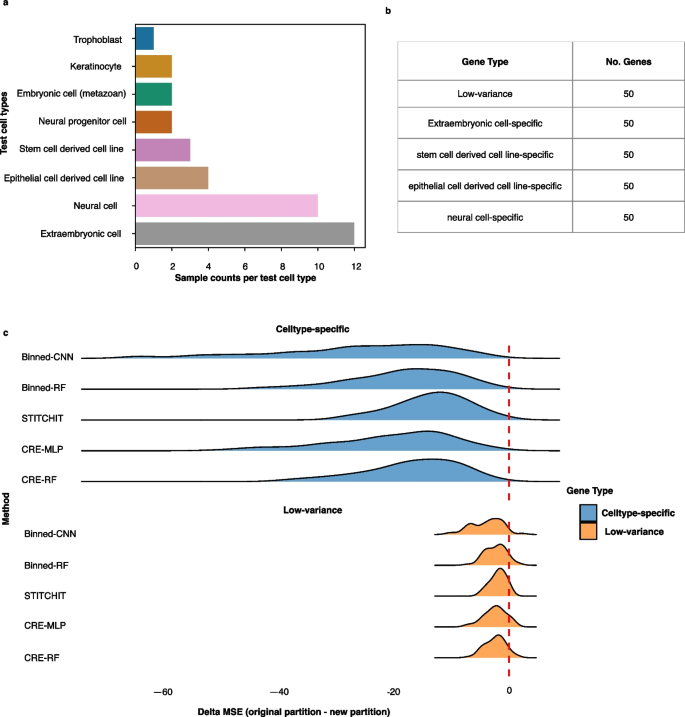
方法细节:基于细胞类型表达谱的PCA距离,选择8种与训练集细胞类型差异最大的细胞类型作为测试集(共36个样本),训练集排除这些细胞类型;筛选246个基因,包括4种测试细胞类型各50个特异性基因和50个低变异基因(表达稳定性高);在该细胞类型特异性划分下重新训练模型并评估性能。
结果解读:所有模型在未见过的细胞类型中MSE均显著升高,其中细胞类型特异性基因的MSE平均增加20%-30%(n=200,P<0.01),低变异基因的MSE仅增加5%-10%;说明模型的预测性能部分依赖训练集中的细胞类型,但仍能捕捉低变异基因的稳定调控模式。
产品关联:文献未提及具体实验产品,领域常规使用Python的scikit-learn进行PCA分析,pandas进行数据处理。
3.6 基于模型的HAWAS方法在疾病中的应用
实验目的:将最优模型应用于疾病关联研究,验证模型在真实疾病数据中的实用性,识别疾病相关基因、调控区域及关键TF。
方法细节:提出两步HAWAS方法:第一步利用CRE-RF和Binned-CNN模型预测健康与疾病样本的基因表达,通过DESeq2识别差异表达基因(HAWAS-gene);第二步对差异基因计算ISP值,通过t-test和FDR校正识别差异调控区域(HAWAS-region);对CLL样本(10健康,12患者)和结肠腺癌样本(8健康,4患者)进行分析,结合DisGeNET数据库验证疾病基因,通过PASTAA进行TF motif富集,利用Survival Genie2进行生存分析。
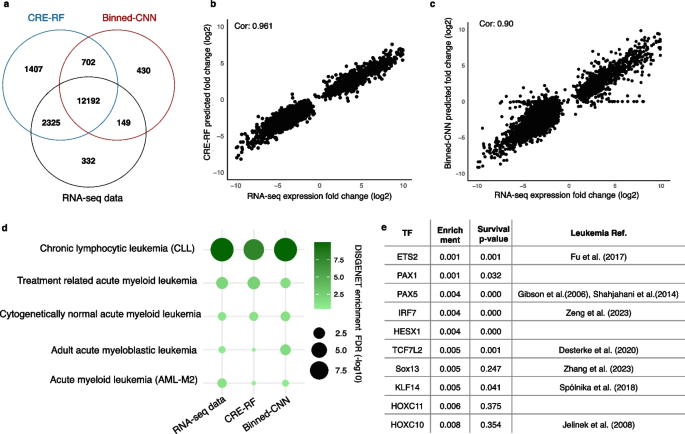
结果解读:CLL中,CRE-RF识别16626个差异基因,与RNA-seq结果的重叠率达97%(n=14998,P<0.001),预测表达与真实表达的Pearson相关系数为0.96;Binned-CNN识别13473个差异基因,相关系数为0.90;HAWAS-region识别49920个显著调控区域,TF motif富集得到30个与白血病相关的TF,其中7个TF的生存分析显示与患者预后显著相关(log-rank test P≤0.05);结肠腺癌中,CRE-RF识别5604个差异基因,与RNA-seq相关系数0.94,得到2个与结肠癌相关的TF。
产品关联:文献未提及具体实验产品,领域常规使用DESeq2进行差异分析,PASTAA进行TF motif富集,Survival Genie2进行生存分析。
4. Biomarker研究及发现成果解析
Biomarker定位
本研究中识别的Biomarker包括疾病相关基因、调控区域及关键转录因子,其筛选与验证逻辑为:通过机器学习模型从表观组数据预测基因表达→差异分析得到疾病相关基因(HAWAS-gene)→in silico perturbation分析得到疾病相关调控区域(HAWAS-region)→TF motif富集得到关键调控TF→结合公共数据库(DisGeNET)和生存分析验证Biomarker的疾病相关性。
研究过程详述
Biomarker的来源为CLL和结肠腺癌患者的H3K27ac ChIP-seq样本;验证方法包括:与同一患者的RNA-seq差异基因重叠验证、DisGeNET数据库疾病基因富集验证、TF生存分析预后验证;特异性与敏感性方面,CRE-RF预测的CLL差异基因与RNA-seq结果的重叠率达97%(n=14998,P<0.001),TF生存分析中7个TF的log-rank test P≤0.05,显示出良好的疾病相关性。
核心成果提炼
本研究首次提出基于机器学习模型的HAWAS新方法,成功识别CLL和结肠腺癌的疾病相关基因、调控区域及关键TF;其中CRE-RF模型在疾病应用中性能最优,其预测的疾病基因与实验数据高度一致;识别的RUNX1、GATA3等TF不仅与白血病发病机制相关,还与患者预后显著相关(log-rank test P≤0.05);该方法无需转录组数据即可从表观组数据直接识别疾病Biomarker,为疾病早期诊断和机制研究提供了高效的新工具,具有重要的临床转化潜力。