1. 领域背景与文献
文献英文标题:The hidden sources of spurious fusion transcripts in plants;
发表期刊:Genome Biology;影响因子:17.9(2024年);研究领域:植物转录组学、融合转录本研究
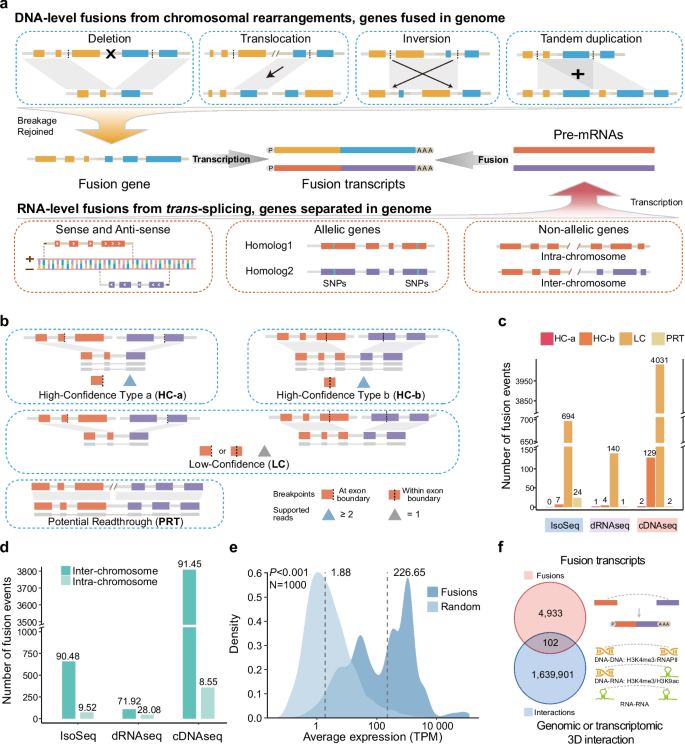
融合转录本(又称嵌合RNA)最初在肿瘤领域被发现,其形成与肿瘤发生密切相关,随后在植物中通过短读长RNA测序技术也被大量报道。植物融合转录本的形成机制分为DNA水平和RNA水平两类,DNA水平融合源于基因组结构重排(如倒位、易位)导致的基因物理连接,RNA水平融合则是基因在基因组中保持独立但转录本通过反式剪接、通读转录等过程连接。然而当前植物融合转录本研究存在诸多未解决的核心问题:不同物种及同一物种不同研究中报道的融合转录本数量差异悬殊,从拟南芥的201到82969个不等;大量融合事件涉及相邻基因,可能源于基因注释错误;验证策略多依赖聚合酶链式反应(PCR)但缺乏关键对照,无法区分真实融合与技术假阳性;DNA与RNA水平的融合常未明确区分,导致领域内概念混淆。此外,植物基因组具有高度可塑性,多倍化、转座子活动及结构多样性驱动种内变异,第三代长读长RNA测序技术为评估植物融合转录本的真实性提供了技术支撑,但针对假阳性融合转录本来源的系统评估仍处于空白状态。
针对上述领域痛点,本研究整合多测序平台、多物种及多水稻基因型的转录组数据,系统解析植物中假阳性融合转录本的隐藏来源,建立可靠的融合转录本验证框架,为准确鉴定植物中真实的融合转录本提供方法学依据,对推动植物转录组学的严谨研究具有重要学术价值。
2. 文献综述解析
作者对领域内现有研究的分类维度主要围绕技术局限性、研究结果矛盾点及验证缺陷展开,将现有研究分为短读长测序驱动的初步报道阶段与长读长测序支撑的验证探索阶段。
现有研究的关键结论认为植物中存在大量融合转录本,涵盖DNA与RNA水平的多种形成机制,部分研究推测融合转录本参与植物的基因调控或进化过程。现有研究的技术方法优势在于短读长测序的高通量特性,能够快速检测大量潜在融合事件;但局限性也十分显著:短读长测序依赖PCR扩增,易引入技术假阳性;验证实验缺乏对等摩尔cDNA混合物等关键对照,无法排除模板切换等 artifacts;多数研究未系统区分DNA与RNA水平的融合,导致概念混淆;基因注释错误与参考基因组选择偏差被长期忽视,进一步放大了假阳性结果的比例。
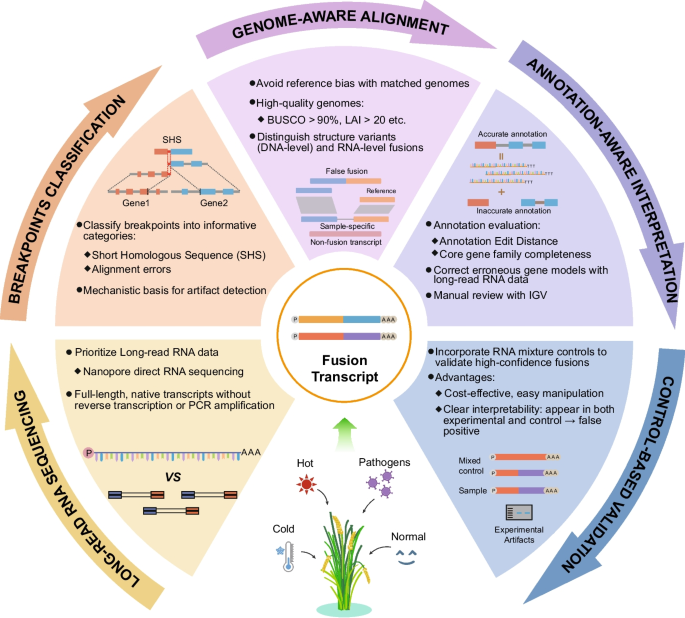
通过对比现有研究的未解决问题,本研究的创新点凸显为三个层面:一是首次系统解析植物中假阳性融合转录本的多维度来源,包括短同源序列介导的模板切换、比对错误、基因注释偏差及参考基因组选择差异;二是建立了涵盖测序平台选择、断点分类、基因组感知比对、注释感知解读及对照实验验证的全流程验证框架;三是通过体内外实验直接证实短同源序列介导的反转录模板切换是PCR-based方法中假阳性的核心机制,为领域内融合转录本的验证提供了金标准实验范式。
3. 研究思路总结与详细解析
本研究的整体目标是系统鉴定并解析植物中假阳性融合转录本的来源,建立可靠的融合转录本鉴定与验证体系;核心科学问题聚焦于植物中大量报道的融合转录本是否为真实生物学事件、假阳性的主要形成机制是什么、如何建立严谨的验证方法;技术路线遵循“数据生成与整合→融合转录本鉴定与分类→假阳性来源解析→验证框架建立”的闭环逻辑。
3.1 多平台转录组数据生成与融合转录本鉴定
实验目的:获取高质量、多维度的转录组数据,系统鉴定不同测序平台下的植物融合转录本,评估其可重复性与真实性。
方法细节:以水稻品种明恢63(MH63)和珍汕97(ZS97)为研究材料,采集抽穗后7天的旗叶样本,提取总RNA后分别构建PacBio IsoSeq、Nanopore直接RNA测序(dRNAseq)、Nanopore PCR扩增cDNA测序(cDNAseq)文库并测序;同时整合公共数据库中的短读长RNAseq数据、其他水稻品种(日本晴)及拟南芥的dRNAseq数据。使用定制的JAFFAL与LongGF流程鉴定融合转录本,根据支持读长数将其分为高置信度(HC,≥2条读长)、低置信度(LC,1条读长),并进一步根据断点位置将HC分为exon边界型(HC-a)与exon内部型(HC-b),相邻基因融合归类为潜在通读(PRT)。
结果解读:不同平台鉴定的融合转录本数量差异显著,IsoSeq鉴定725个、dRNAseq鉴定146个、cDNAseq鉴定4164个,但跨平台及生物学重复间的重叠极低,dRNAseq重复中仅1/146个融合可重复,cDNAseq重复中仅19/4164个融合可重复,说明大部分融合事件为技术假阳性;染色体来源分析显示融合转录本无明显位置偏差;与核三维空间相互作用数据集的重叠仅占少数(102个),表明核空间邻近性并非融合形成的主导机制;扩展至日本晴水稻及拟南芥后,同样观察到融合转录本的可重复性极低(0%-2.42%),进一步验证了假阳性的普遍性。
产品关联:文献未提及具体实验产品,领域常规使用的试剂包括TRIzol™ Reagent(Invitrogen)、DNase I(NEB)、测序文库构建试剂盒等,测序平台包括PacBio Sequel、Nanopore PromethION等。
3.2 短同源序列介导的假阳性融合转录本机制解析
实验目的:明确短同源序列(SHS)是否为假阳性融合的主要来源,并验证其形成机制为反转录过程中的模板切换。
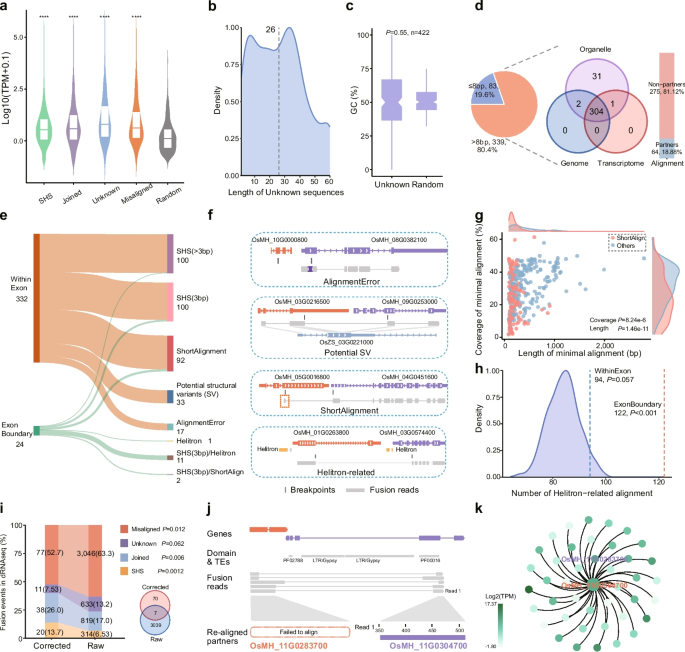
方法细节:将融合断点分为SHS型(断点处存在短同源序列)、Joined型(直接连接)、Unknown型(含非伙伴基因序列)及Misaligned型(比对失败)四类;选取含12bp SHS的MH63-SHS1融合事件进行体外验证:设计含SHS与不含SHS的引物对扩增融合伙伴基因,将扩增产物等摩尔混合后作为模板进行PCR,分别使用禽成髓细胞瘤病毒(AMV)与莫洛尼鼠白血病病毒(M-MLV)反转录酶进行反转录;体内验证则将两个伙伴基因分别融合N端GFP与C端mCherry标签,转化水稻原生质体后通过荧光激活细胞分选(FACS)获取不同转化群体,检测融合信号。
结果解读:SHS介导的事件占所有融合转录本的75.43%,在PCR-based方法中比例更高(IsoSeq为75.45%、cDNAseq为77.59%),且91.65%的SHS长度≥4bp;体外实验显示,仅含SHS的模板组能扩增出融合产物,使用M-MLV反转录酶时融合信号完全消失,证实SHS依赖的融合源于反转录模板切换而非真实生物学事件;体内实验中,即使在单独转化的细胞混合物中使用AMV反转录酶也能检测到融合信号,进一步证明此类融合信号是检测过程中的技术 artifacts,与真实融合事件无关。
产品关联:实验所用关键产品:AMV反转录酶(NEB)、M-MLV反转录酶(Invitrogen)、BD FACS Aria II SORP流式细胞仪、Trans2K Plus DNA Marker(TransGen Biotech, BM111)、KOD One™ PCR Master Mix(Sigma-Aldrich)。

3.3 非SHS介导的假阳性融合转录本机制解析
实验目的:解析非SHS介导的假阳性融合转录本的复杂来源,包括比对错误、转座子关联事件及注释偏差等。
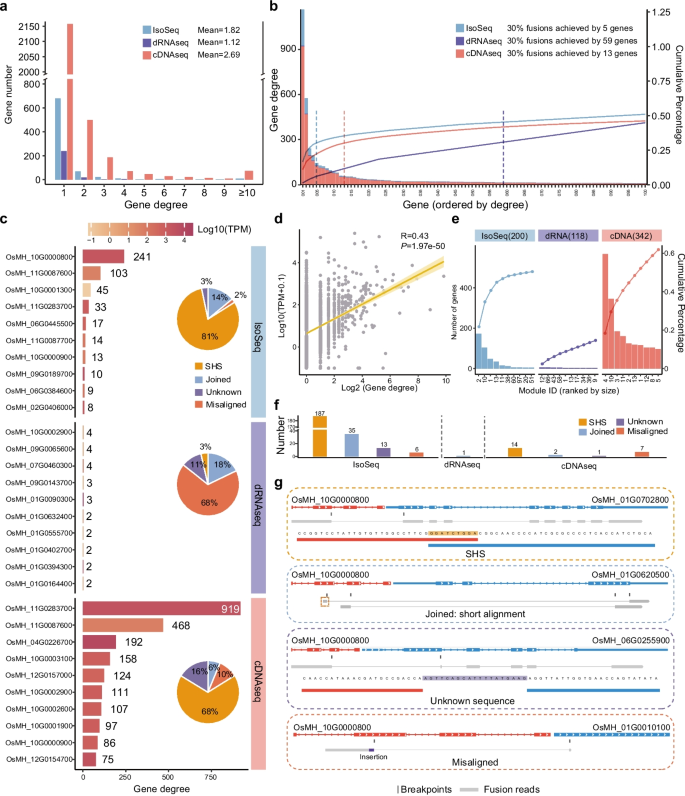
方法细节:系统分析Unknown、Joined、Misaligned三类断点的特征,对Joined型融合进行手动注释,分为比对错误、潜在结构变异、Helitron转座子关联及短比对 artifacts;对Misaligned型融合进行碱基纠错后重新比对,评估比对质量;构建融合网络,分析高连接度基因的拓扑特征与序列特征。
结果解读:Unknown型融合的伙伴基因表达量最高(中位数6.12,P<0.0001),断点处平均含26bp连接序列,可比对到基因组或转录组区域,推测源于RNA样本制备过程中的片段连接;Joined型融合中55%经重新分析后发现含SHS,其余为比对错误、Helitron转座子驱动的结构变异或短比对 artifacts,且exon边界型融合的断点附近Helitron转座子富集程度显著高于exon内部型(置换检验P<0.001);Misaligned型融合的比对质量显著低于其他类型,部分基因反复参与多个融合事件,形成融合网络中的“hub”节点;融合网络呈现非随机拓扑结构,1.11%的基因连接度≥10,这些基因通常具有高表达量、高GC含量等特征,可作为假阳性的可靠标记。
产品关联:文献未提及具体实验产品,领域常规使用的生物信息学工具包括BLAST、Mummer、BLAT、igraph、Gephi、IGV等。
3.4 基因注释与参考基因组对融合检测的影响分析
实验目的:明确基因注释错误与参考基因组选择偏差是否为假阳性融合转录本的重要来源。
方法细节:使用Arriba流程从短读长RNAseq数据中鉴定相邻基因融合,通过PCR验证是否为注释错误;比较多个注释集(MH63原始、手动 curated、MSU7.0、IRGSP1.0)的基因模型差异;将ZS97的dRNAseq数据分别比对到MH63与ZS97参考基因组,分析假阳性比例。
结果解读:74%的相邻基因融合实际是注释错误导致的单个转录本,PCR验证证实此类融合事件的伙伴基因属于同一基因座;不同注释集之间存在大量基因拆分与融合差异,80.90%的融合差异可被长读长数据支持为注释 artifacts;参考基因组选择偏差导致大量假阳性,ZS97数据比对到MH63参考基因组时,82.47%的融合事件是结构变异导致的比对错误,重新比对到ZS97参考基因组后,所有HC-a型融合均被解析为 artifacts。
产品关联:文献未提及具体实验产品,领域常规使用的注释工具包括AGAT、RepeatMasker、HELIANO等。
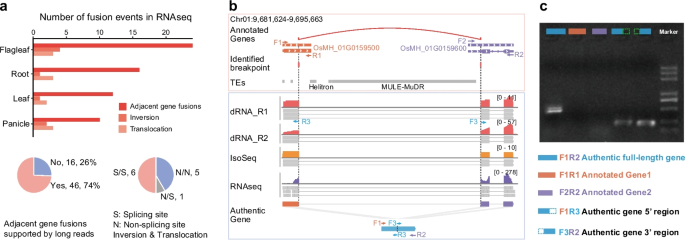
3.5 杂交系统中融合转录本的真实性验证
实验目的:在杂交系统中区分真实的生物学融合与技术 artifacts,进一步验证假阳性融合的普遍性。
方法细节:使用水稻杂交组合MH63×ZS97及其杂交种SY63,分析等位与非等位融合转录本;比较杂交种与亲本RNA混合物中的融合事件,将其分为模板切换 artifacts、杂交种单重复 artifacts、仅对照存在的 artifacts及需手动审查的事件;通过SNP特异性PCR验证等位融合候选事件。
结果解读:杂交种中检测到的大量等位与非等位融合转录本,跨组织及测序平台的重叠极少;22.46%的非等位融合与36.59%的等位融合属于模板切换 artifacts(在亲本混合物中也能检测到);手动审查的事件均为测序错误或比对 artifacts,未验证到真实的融合事件;等位融合的伙伴基因表达量(TPM 34.62 vs 0.28)、基因长度(2033bp vs 1081bp)及外显子数(6 vs 3)均显著高于随机基因,但无生物学可解释的组织特异性GO功能,进一步证实其假阳性属性。
产品关联:文献未提及具体实验产品,领域常规使用的SNP分析工具包括SAMtools、BEDTools、Salmon等。
4. Biomarker研究及发现成果解析
本研究中涉及的Biomarker主要为假阳性融合转录本的识别标记,包括融合网络中的高连接度“hub”基因、SHS介导的融合事件特征、注释依赖型融合事件特征及参考基因组偏差型融合事件特征,这些标记可用于快速筛选并排除植物转录组中的假阳性融合事件。
假阳性融合转录本的识别标记分为四类:一是融合网络中连接度≥10的“hub”基因,筛选逻辑为通过融合网络拓扑分析鉴定,验证逻辑为分析其表达量、GC含量及参与的融合事件类型;二是SHS介导的融合事件,筛选逻辑为断点处存在≥4bp的短同源序列,验证逻辑为体外PCR对照实验与体内原生质体实验;三是相邻基因融合事件,筛选逻辑为伙伴基因在基因组上相邻,验证逻辑为PCR扩增与长读长数据比对;四是跨平台及生物学重复无重叠的融合事件,筛选逻辑为多数据集的重叠分析,验证逻辑为重复实验验证。
“hub”基因的来源为全基因组融合网络分析,验证方法为转录组表达量分析、GC含量统计及融合事件类型注释,其特异性表现为仅参与假阳性融合事件,敏感性为可覆盖1.11%的融合伙伴基因;SHS介导的融合事件的来源为断点分类分析,验证方法为含/不含SHS的模板PCR实验,其特异性表现为仅在PCR-based方法中高比例存在(75%以上),敏感性为可覆盖75.43%的假阳性融合事件;相邻基因融合事件的来源为短读长RNAseq数据的相邻基因融合检测,验证方法为PCR扩增,其特异性表现为74%的事件为注释 artifacts;参考基因组偏差型融合事件的来源为跨参考基因组比对分析,验证方法为重新比对到基因型匹配的参考基因组,其特异性表现为82.47%的事件为结构变异导致的比对错误。
本研究发现的假阳性融合转录本识别标记具有重要的应用价值,其中“hub”基因可作为快速识别假阳性融合的生物标记,其参与的融合事件无需进一步验证即可判定为 artifacts;SHS介导的融合事件标记可用于指导实验设计,优先选择无PCR扩增的长读长直接RNA测序以降低假阳性;注释依赖型与参考基因组偏差型标记可用于优化融合检测流程,减少注释与参考基因组带来的假阳性。本研究的创新性在于首次系统定义了植物中假阳性融合转录本的多维度Biomarker,为植物融合转录本的严谨研究提供了可操作的筛选标准,相关数据显示“hub”基因的连接度与表达量呈中度相关(R=0.43),SHS介导的融合事件在PCR-based方法中的比例显著高于无PCR方法(P<0.001),所有数据均经过严格的统计学检验(如置换检验、Wilcoxon检验等)。