

1. 领域背景与文献
文献英文标题:A curated genome-scale nucleotide diversity panel of non-human primates;
发表期刊:Genome Biology;影响因子:未公开;研究领域:灵长类进化基因组学与比较基因组学。
领域共识:灵长目是系统发育和生态多样性最丰富的真兽哺乳动物类群之一,非人灵长类基因组研究不仅对解析人类起源与物种形成过程至关重要,也为保护生物学研究提供核心支撑。随着新一代基因组测序技术的发展,目前已有数千个非人灵长类个体的全基因组序列被公布,覆盖了绝大多数灵长类属,为大规模跨物种比较分析提供了数据基础。
尽管现有基因组资源的数量不断增长,灵长类跨物种比较研究仍存在明显的局限性,核心问题是不同来源数据的处理流程缺乏统一标准,尤其是现有研究大多忽略了性连锁区域的倍性特征,未开展倍性感知的变异检测,导致性连锁区域的变异结果存在系统误差,严重限制了现有数据集在大规模比较基因组分析中的应用。在此背景下,本研究针对现有公共资源的核心缺陷,构建标准化的全基因组尺度非人灵长类核苷酸多样性面板,对推动灵长类演化、性染色体进化等领域研究具有重要的基础学术价值。
2. 文献综述解析
现有非人灵长类基因组资源构建研究可分为类群规模化从头测序和公共数据整合整合两类,两类研究均积累了大量的遗传变异数据,但普遍存在处理流程不统一、性染色体区域处理不规范的问题。
现有研究已经完成了多个灵长类类群的规模化全基因组测序,产出了数千个个体的基因组数据,近年来还陆续发布了多个端粒到端粒水平的高质量灵长类基因组组装,为灵长类基因组研究提供了基础框架。但不同研究采用的变异检测流程、过滤标准存在明显差异,增加了跨研究整合分析的难度,更关键的是,现有大多数研究都忽略了性连锁区域的倍性特征,没有针对样本性别调整变异检测的倍性参数,导致性染色体区域的变异检测结果存在系统偏差,这些局限性大大降低了现有公共数据的利用效率,限制了性染色体进化等方向的研究开展。
与现有研究相比,本研究的创新价值十分明确,首先本研究首次在大规模灵长类基因组数据整合中采用了倍性感知的变异检测流程,通过完善样本性别注释,校正了性连锁区域的变异检测结果,解决了现有研究的核心缺陷;其次,本研究整合了目前全球最大规模的非人灵长类样本,共覆盖269个物种71个属,样本量远超现有已发表的整合数据集;此外,本研究同步生成了49个灵长类参考基因组的多基因组比对结果,为跨物种比较分析提供了直接可用的基础资源,填补了领域内标准化大规模多样性资源的空白,为后续相关研究提供了重要支撑。
3. 研究思路总结与详细解析
本研究的研究目标是构建覆盖大规模非人灵长类样本的标准化全基因组核苷酸多样性面板,核心科学问题是解决现有公共数据处理不统一、性连锁区域变异检测不准确的问题,整体技术路线遵循“公共数据收集→参考基因组预处理→读长比对与性别校正→倍性感知变异检测→质量控制过滤→多维度多样性验证”的闭环逻辑,完成了资源构建与可靠性验证。
3.1 原始数据获取与预处理
实验目的:收集符合研究需求的非人灵长类全基因组短读长测序数据与参考基因组,为后续分析提供合格的基础输入。
方法细节:从NCBI序列读长库(SRA)检索并下载非人灵长类全基因组短读长测序数据,手动注释元数据,优先保留野生捕获个体或群体多样性面板来源的样本,排除生物医学研究来源的样本;共获得3240个个体,覆盖269个物种、71个属;从NCBI和DNA Zoo公共库获取47个非人灵长类参考基因组,补充人类端粒到端粒参考基因组和树鼩外类群基因组;对参考基因组进行过滤,仅保留长度不小于1000碱基对的重叠群,对大猿和合趾猴基因组的Y连锁假常染色质区域进行掩膜,构建索引和序列字典。
结果解读:最终获得覆盖所有灵长类主要类群的样本集和高质量参考基因组集合,满足后续分析的基础需求;文献未明确提供该环节的统计学显著性数据,基于研究设计推测预处理结果合格。
文献未提及具体实验产品,领域常规使用生物信息学分析软件与公共基因组数据库完成该环节。
3.2 读长比对与样本性别鉴定
实验目的:完成短读长比对,完善样本性别注释,为倍性感知变异检测提供准确基础信息。
方法细节:将未比对BAM文件分块,标记接头序列后使用bwa mem工具完成比对,合并分块结果,标记重复序列并对BAM文件排序;通过多基因组比对结果识别参考基因组中的X染色体来源重叠群,基于X染色体重叠群的归一化覆盖度,结合最近邻分类器完成不同覆盖度样本的性别鉴定。
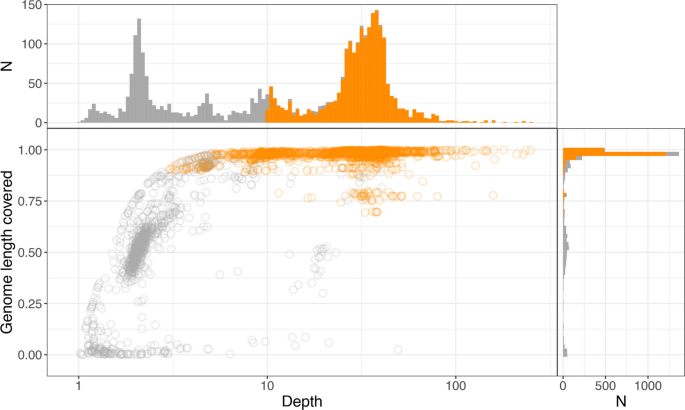
结果解读:本研究将原有数据集中性别未知的样本数量从1384个减少至5个(5个个体均为眼镜猴),最终数据集中包含1756个雌性个体和1479个雄性个体;全基因组平均读长覆盖深度为22.31倍,常染色体为22.57倍,X染色体为17.53倍;全基因组平均参考基因组覆盖比例为83%,常染色体为84%,X染色体连锁重叠群为81%;常染色体和X染色体部分平均覆盖深度不低于10倍的样本占比分别为63%(n=2027)和59%(n=1902);3164个样本的基因组平均比对质量高于40,3166个样本的比对读长占比高于50%,低质量样本主要来自特殊DNA来源(如尿液、粪便、单根毛发)或样本标注错误。图1展示了常染色体测序深度和覆盖比例的样本分布,结果显示大部分合格样本满足后续分析的覆盖度要求。
文献未提及具体实验产品,领域常规使用生物信息学分析软件完成该环节。
3.3 多基因组比对构建
实验目的:生成跨物种多基因组比对结果,为跨物种比较分析和X染色体注释提供基础。
方法细节:使用Progressive Cactus工具对49个参考基因组(47个非人灵长类、1个人类、1个树鼩外类群)进行多基因组比对,其中包含8个端粒到端粒无间隙参考基因组;将比对结果转换为MAF格式后,计算各参考基因组与人类基因组的比对比例和序列分歧度。
结果解读:非人灵长类基因组与人类基因组的可比对比例随系统发育距离增加而降低,序列分歧度随系统发育距离增加而升高,符合演化生物学预期;值得注意的是,人类X染色体与非人灵长类X染色体的分歧度低于常染色体序列的分歧度;本研究还基于同源比对结果,为23个缺乏X染色体注释的参考基因组注释了X染色体来源重叠群,纠正了红疣猴基因组中错误的X染色体注释。图2展示了各参考基因组与人类基因组的比对覆盖度和分歧度,结果验证了上述结论。
文献未提及具体实验产品,领域常规使用生物信息学分析软件完成该环节。
3.4 变异检测与质量过滤
实验目的:基于倍性感知策略完成全基因组变异检测,过滤得到高质量可靠的基因型数据集。
方法细节:分2兆碱基区间并行处理,使用GATK HaplotypeCaller进行变异检测,根据个体性别和区域类型(常染色体、性染色体)设置对应倍性参数,生成每个位点的gVCF文件;按物种合并gVCF后进行联合基因分型,构建物种特异性的可调用性掩膜,过滤低质量变异和不合格基因型,保留符合质量标准的变异用于后续分析。
结果解读:最终经过严格质量控制后,共有1427个个体(覆盖255个物种、71个属)纳入后续核苷酸多样性分析,筛选标准为常染色体比对深度不低于20倍,基因型缺失比例小于1%(文献未明确提供P值,基于过滤标准推测结果可靠)。
文献未提及具体实验产品,领域常规使用生物信息学分析软件完成该环节。
3.5 核苷酸多样性分析与验证
实验目的:分析非人灵长类基因组核苷酸多样性的分布特征,验证构建数据集的生物学可靠性。
方法细节:计算常染色体和X染色体的个体杂合度,基于筛选后的变异开展主成分分析分析群体结构,比较不同比对特性区域的核苷酸多样性差异。
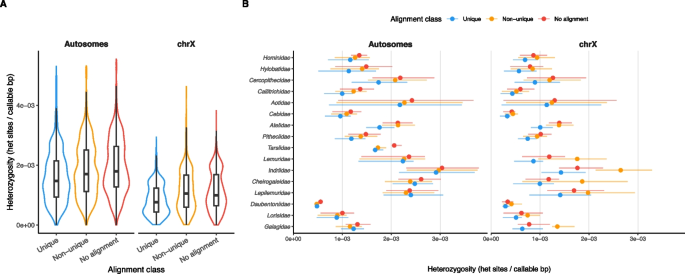
结果解读:不同灵长类类群的常染色体杂合度存在较大差异,新世界猴的杂合度中位数为1.5×10⁻³,眼镜猴的中位数为2.8×10⁻³;X染色体杂合度中位数从类人猿的3.5×10⁻⁴到原猴亚目的8.15×10⁻⁴不等;大多数样本的X染色体与常染色体杂合度比值低于0.75,说明大多数灵长类物种的X染色体多样性相比常染色体受到更强的人为或选择削减。图3展示了不同灵长类科的多样性分布特征,结果清晰呈现了类群间的多样性差异。
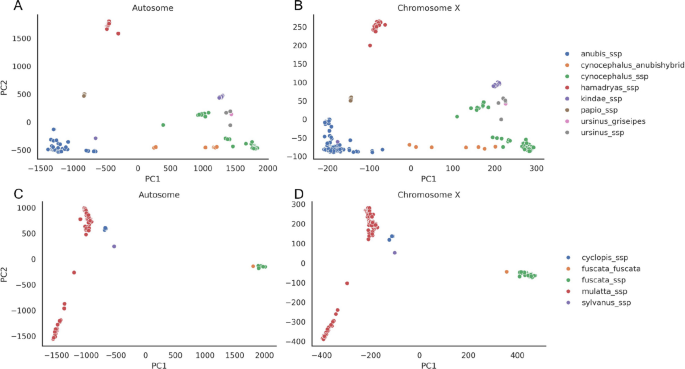
对狒狒和猕猴的主成分分析显示,基于常染色体和X染色体变异得到的聚类模式一致,能够准确区分不同物种和不同地理起源的群体,还成功识别出了已知的杂交个体和物种标注错误样本,验证了数据集的可靠性。图4展示了主成分分析的聚类结果。
在常染色体中,唯一比对到人类基因组的区域平均杂合度最低,为1.6×10⁻³,非唯一比对区域为1.85×10⁻³,无同源区域为1.95×10⁻³,符合保守区域进化速率更慢的预期;X染色体中,唯一比对区域杂合度最低为8.32×10⁻⁴,多比对区域杂合度为1.15×10⁻³,略高于无同源区域的1.13×10⁻³,推测该结果可能与X染色体重复区域独特的进化动力学有关。图5展示了不同区域类型的杂合度分布,结果支持上述结论。
文献未提及具体实验产品,领域常规使用生物信息学分析软件完成该环节。
4. Biomarker研究及发现成果
本研究核心内容为非人灵长类基因组核苷酸多样性公共资源的构建与可靠性验证,未开展针对特定疾病、表型或保护应用的生物标志物筛选与验证研究,无直接相关的Biomarker研究成果产出。
本研究构建的大规模标准化核苷酸多样性面板,可为后续灵长类进化生物学、保护遗传学、分子生态学研究提供高质量基础数据,能够支撑后续研究筛选物种特异性遗传标记、种间杂交分子标记、适应性进化相关生物标志物,同时本研究校正后的性连锁区域变异数据,也为性染色体进化相关的功能变异和生物标志物研究提供了可靠的数据基础,具有重要的后续研究支撑价值。