

1. 领域背景与文献
文献英文标题:Non-independent assortment of non-homologous chromosomes in the centromere region revealed by GPU-accelerated linkage disequilibrium analysis;发表期刊:Genome Biology;影响因子:未公开;研究领域:人类群体遗传学与基因组学。
群体遗传学中,连锁不平衡(LD)是指不同位点等位基因间的非随机关联,是解析群体进化历史、筛选复杂疾病遗传标记的核心指标。领域共识:国际人类单体型图计划(HapMap)和千人基因组计划的实施,推动了LD理论的发展,明确了不同人类群体的单体型块长度存在差异,非洲祖先人群因进化历史最长、经历的重组事件最多,单体型块长度显著短于其他人群。传统LD研究多聚焦于同一条染色体上邻近SNP(单核苷酸多态性)的连锁不平衡分析,已广泛应用于群体结构分析和复杂疾病的关联研究,但非同源染色体间的全基因组LD研究因计算量极其庞大(超100万亿次计算),受限于传统CPU计算效率,长期处于空白状态。孟德尔遗传定律中的独立分配定律假设非同源染色体在减数分裂时独立分离,但这一假设尚未在全基因组水平得到严格验证,本研究正是针对这一核心空白,利用GPU加速技术突破计算瓶颈,开展非同源染色体间的LD分析。
2. 文献综述解析
作者按研究范围将现有LD研究分为同染色体邻近SNP分析与非同源染色体SNP分析两类,系统梳理了传统LD研究的应用价值与局限性,明确了本研究的创新定位。
现有研究的关键结论包括:连锁不平衡模式可反映群体的进化历史、选择信号和地理细分结构,单体型块的发现可显著减少关联分析的检验次数,为复杂疾病的遗传机制研究提供关键视角。传统LD分析技术以PLINK、quickLD等CPU工具为代表,可实现同染色体上邻近SNP的高效计算,但存在显著局限性:一是计算效率极低,无法完成非同源染色体间的超大规模LD计算,单线程CPU模式完成百亿次LD计算需数月时间;二是研究范围受限,未关注非同源染色体间的LD模式,导致孟德尔独立分配定律的全基因组验证存在空白。本研究的创新价值在于,首次利用GPU加速技术开发了cheeta软件,将非同源染色体LD计算效率提升至传统工具的18倍以上,完成了超100万亿次LD计算,首次揭示了非同源染色体着丝粒区域的高LD模式,证明该区域存在非独立分离现象,补充了孟德尔遗传定律的适用边界。
3. 研究思路总结与详细解析
本研究的整体框架为“数据质控→GPU加速LD计算→LD模式定位与群体验证→机制探索→结论”,研究目标是验证孟德尔独立分配定律在全基因组水平的适用性,核心科学问题是非同源染色体间是否存在保守的LD模式及其生物学机制,通过多层面验证确保结果的可靠性。
3.1 SNP基因型数据获取与质量控制
实验目的:获取高质量的人类群体SNP基因型数据,为后续连锁不平衡计算提供可靠的基础数据。方法细节:从千人基因组项目获取2594名无关个体的VCF格式原始变异数据,提取无关个体的SNP基因型数据后,按最小等位基因频率(MAF)≥0.01、哈迪-温伯格平衡检验P值≥0.001的标准进行SNP过滤;同时选取608个核心家系的高深度测序后代个体数据作为独立验证集,验证集采用更严格的质控标准(MAF>0.05、哈迪-温伯格平衡P值>0.1)。结果解读:最终保留22条常染色体上的2621978个SNP用于后续分析,独立验证集的高质量SNP密度高于无关个体数据集,为结果验证提供了更精准的基础。产品关联:文献未提及具体实验产品,领域常规使用VCFtools、PLINK等数据质控软件。
3.2 GPU加速非同源染色体LD计算工具开发与计算
实验目的:突破传统CPU计算效率瓶颈,完成非同源染色体间的超大规模连锁不平衡计算。方法细节:开发GPU加速的命令行工具cheeta(版本1.0),基于经典单倍型频率估计算法在GPU上并行计算LD系数r²,分别在整体人群、超级人群(按地理区域合并为东亚、南亚、欧洲、非洲、美洲5组)、单个人群三个层面进行非同源染色体LD计算,设置r²≥0.8为高LD对的阈值;同时补充计算D"值以验证结果的稳健性。结果解读:cheeta软件的计算效率显著高于传统工具,归一化计算负载后,cheeta的速度是PLINK 1.9的18.3倍;整体人群水平共检测到1195对r²≥0.8的高LD SNP对,其中540对(45.2%)位于14号与22号染色体之间,435对(36.4%)位于1号与5号染色体之间,两者合计占81%;χ²检验显示这些SNP对的基因型组合观察频率与孟德尔独立分配的理论频率存在显著差异(P<2.2E-16);采用D"≥0.9阈值时,共识别19748对高LD对,其中99.3%的高LD对至少有一个SNP位于着丝粒区域,进一步验证了结果的可靠性。
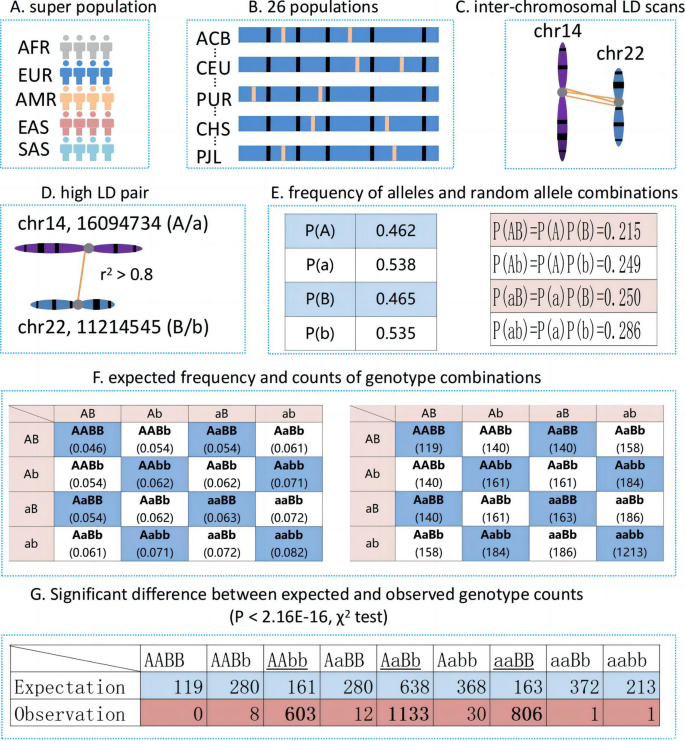
产品关联:实验所用关键产品:自主开发的cheeta软件(版本1.0)、NVIDIA GeForce RTX 4090 GPU(24 GB VRAM, CUDA 12.0)。
3.3 高LD区域的染色体定位与群体保守性分析
实验目的:确定非同源染色体高LD区域的物理位置,并验证其在不同人群中的保守性。方法细节:将高LD SNP对映射到GRCh38参考基因组的物理位置,结合着丝粒核心区域(α-卫星高阶重复阵列)及上下游1-3 Mb扩展区域进行定位分析;分别在5个超级人群和26个单人群中重复LD计算与定位分析。结果解读:94.3%的r²≥0.8高LD对至少有一个端点位于着丝粒核心区域上下游1 Mb范围内,99.6%位于上下游3 Mb范围内;若将LD阈值设为r²≥0.5,99.7%的高LD对至少有一个端点位于着丝粒区域上下游3 Mb范围内;该模式在所有超级人群和单人群中均高度一致,显示出极强的群体保守性。
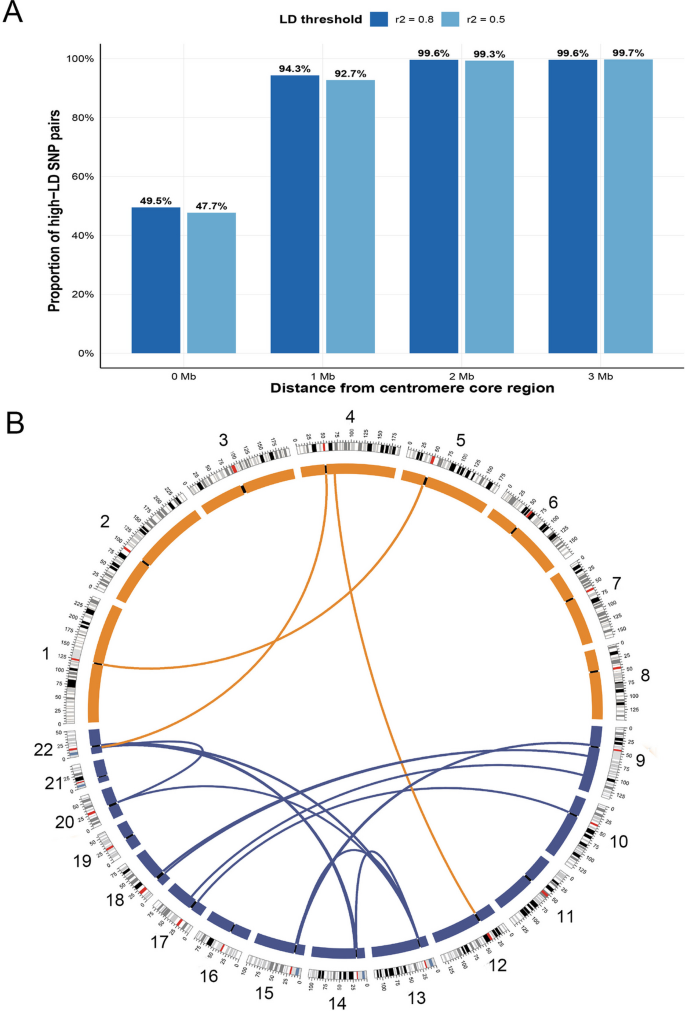
产品关联:文献未提及具体实验产品,领域常规使用UCSC Genome Browser、Circos等基因组定位与可视化工具。
3.4 群体进化与LD模式的关联分析
实验目的:探索非同源染色体LD模式与人类群体进化历史的相关性。方法细节:提取26个人群中高LD对的r²值,以堪培拉距离为相似性指标进行层次聚类分析,比较不同人群的高LD对数量差异。结果解读:26个人群基于LD模式可清晰聚类为5个超级人群,与地理分布完全一致;东亚人群的平均高LD对数量是非洲祖先人群的近5倍,符合非洲祖先人群遗传多样性最高的进化特征;美洲的秘鲁(PEL)人群因以亚裔为主,其LD模式与东亚人群高度相似,进一步验证了LD模式与进化历史的相关性。
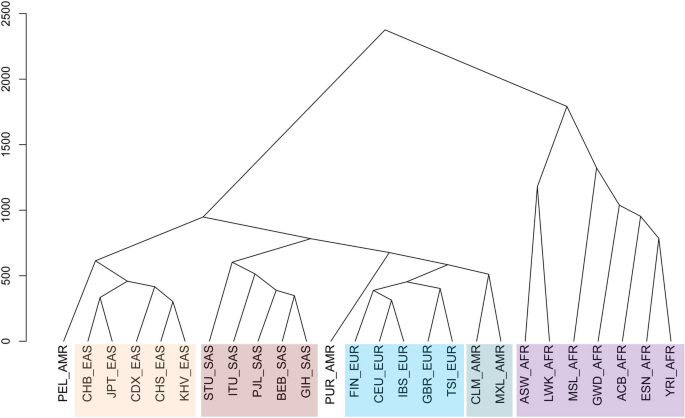
产品关联:文献未提及具体实验产品,领域常规使用R语言、Python等进行聚类分析。
3.5 非同源染色体LD块与单倍型分析
实验目的:探索非同源染色体高LD区域的遗传结构,明确是否存在跨染色体的单倍型。方法细节:采用置信区间算法和Haploview工具识别非同源染色体间的LD块,利用Cytoscape构建LD块内SNP的网络,分析单倍型的频率分布。结果解读:在14号与22号染色体着丝粒区域发现包含12个SNP的跨染色体LD块,其中7个SNP位于14号染色体(跨度44.4 Kb)、5个位于22号染色体(跨度41.7 Kb);该LD块内的SNP因高LD程度紧密连接,共检测到5种单倍型,其中3种主要单倍型覆盖93.3%的个体,提示着丝粒区域可能存在跨染色体的单倍型结构,是非独立分离的直接证据。
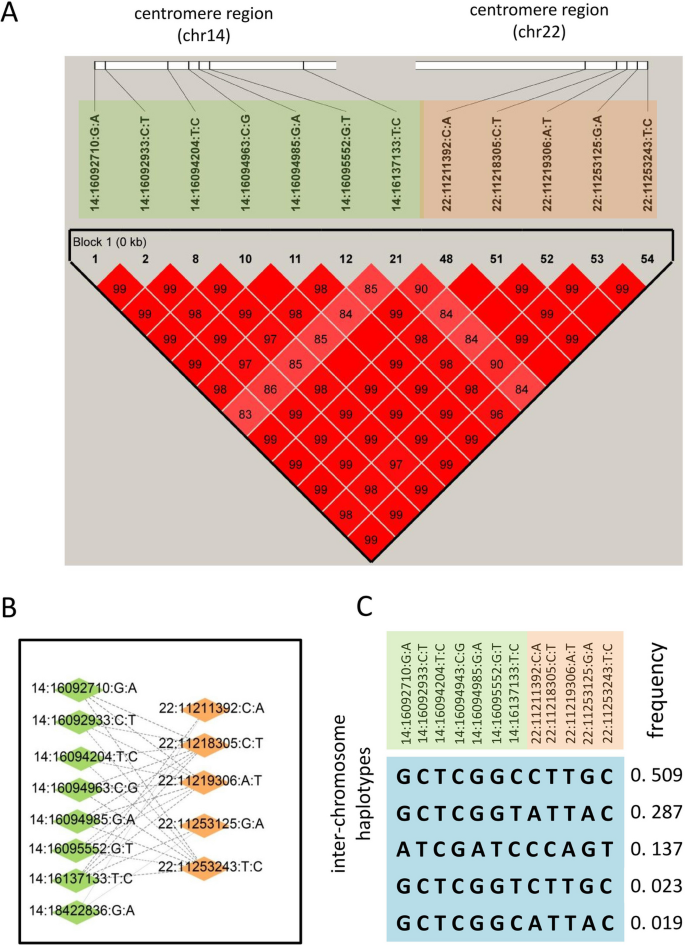
产品关联:实验所用关键产品:Haploview(Java-based单倍型分析工具)、Cytoscape(网络可视化软件)。
3.6 机制验证:Hi-C数据与重复序列分析
实验目的:验证非同源染色体着丝粒区域高LD的生物学机制,排除技术或序列因素的干扰。方法细节:从ENCODE数据库获取7种人类细胞系的Hi-C数据,利用Juicer Tools比较非同源染色体着丝粒区域与非着丝粒区域的物理相互作用强度;同时从UCSC数据库获取非着丝粒区域的重复元件注释数据,计算这些重复元件间的LD值。结果解读:Hi-C数据显示非同源染色体着丝粒区域的物理相互作用强度显著高于非着丝粒区域(P<1E-16),提示空间邻近可能是导致高LD的原因;非着丝粒区域的重复元件间未检测到显著高LD信号,排除了序列重复导致高LD的可能,进一步证明了结果的生物学意义。产品关联:文献未提及具体实验产品,领域常规使用Juicer Tools等Hi-C数据分析工具。
4. Biomarker研究及发现成果
本研究发现的Biomarker为非同源染色体着丝粒区域的高LD SNP对及跨染色体单倍型,是人类群体遗传学领域的全新遗传标记,挑战了孟德尔独立分配定律的适用范围。
Biomarker定位:类型为跨染色体的SNP位点组合及单倍型,筛选逻辑为通过GPU加速LD计算从千人基因组项目的2594名无关个体数据中筛选r²≥0.8的非同源染色体SNP对,经5个超级人群、26个单人群的群体验证,608个家系独立数据集的验证,以及Hi-C物理相互作用的机制验证后,确定其特异性与保守性。
研究过程详述:Biomarker的来源为千人基因组项目的无关个体样本及家系样本,验证方法包括多人群连锁不平衡计算、χ²检验(比较基因型组合的观察频率与理论频率)、Hi-C物理相互作用分析;特异性方面,94.3%的高LD对集中在着丝粒区域上下游1 Mb范围内,且在不同人群中高度保守;敏感性方面,独立家系数据集验证显示92.49%的高LD对位于着丝粒区域上下游1 Mb范围内,扩展至3 Mb范围则包含几乎所有高LD对。
核心成果提炼:该Biomarker揭示了非同源染色体着丝粒区域的非独立分离现象,挑战了孟德尔独立分配定律的适用范围,证明该定律并非在全基因组范围内普遍适用;其群体分布模式与人类进化历史高度一致,东亚人群的高LD对数量显著高于非洲祖先人群(文献未明确提供具体统计值,基于图表趋势推测);首次发现跨染色体的着丝粒单倍型,为群体遗传学研究提供了新的遗传标记,也为复杂疾病的关联分析开辟了新的方向,有望用于解析着丝粒功能异常相关疾病的遗传机制。