

1. 领域背景与文献
文献英文标题:PHap enables haplotype-resolved telomere-to-telomere assembly of autotetraploid potato genomes;发表期刊:Genome Biology;影响因子:17.906;研究领域:作物基因组学、多倍体基因组组装与功能研究
马铃薯是全球第三大粮食作物,年总产量约3.6亿吨,但其育种进程因同源四倍体高度杂合的基因组特征严重滞后。多倍体基因组组装领域的关键发展节点包括:早期依赖遗传图谱或单配子测序分箱的方法实现单倍型解析,但成本高、流程复杂;随后出现基于Hi-C数据的组装工具(如ALLHiC、HapHiC),无需额外实验但在高同源相同(IBD)区域易出错;近年出现仅用HiFi和Hi-C数据的组装流程,降低了实验复杂度但组装连续性不足(N50约5Mb)。当前研究热点聚焦于多倍体基因组的单倍型解析端粒到端粒(T2T)组装、单倍型 divergence 对性状调控的机制,未解决的核心问题是如何低成本、高效地实现同源多倍体基因组的高准确度单倍型解析T2T组装,以及复杂区域(着丝粒、亚端粒)的单倍型特征与功能关联。针对上述空白,本研究开发了PHap组装流程,仅用常规测序数据实现同源四倍体马铃薯的单倍型解析近T2T组装,为多倍体作物基因组研究与育种提供了技术支撑和资源。
2. 文献综述解析
作者对领域内现有研究按组装技术路线分为三类:依赖配子分箱或遗传图谱的方法、直接利用Hi-C数据的组装工具、仅用HiFi和Hi-C的组装流程。现有研究的关键结论显示,这些方法在多倍体基因组组装中各有侧重:配子分箱法(如Otava的单配子测序分箱)能获得较高准确度的单倍型,但需额外的单配子测序实验,成本高且耗时;Hi-C辅助工具(如ALLHiC、HapHiC)无需额外实验,但在高IBD区域易出现单倍型聚类错误;仅用HiFi和Hi-C的方法(如欧洲马铃薯泛基因组研究流程)降低了实验复杂度,但组装连续性不足,无法实现T2T组装。现有方法的共同局限性是难以同时兼顾组装的连续性、准确度和成本,且缺乏对多倍体基因组复杂区域的有效解析,限制了对单倍型 divergence 功能的研究。本研究的创新价值在于,首次开发了无需额外实验的PHap流程,仅用HiFi、ONT超长读长(ONT-UL)和Hi-C数据,实现了同源四倍体马铃薯的单倍型解析近T2T组装,组装连续性(N50=32.7Mb)和准确度(99.7%)均优于现有方法,且成本更低;同时首次系统解析了四倍体马铃薯单倍型在基因组结构、表观遗传、动态等位表达及复杂区域的 divergence 特征,填补了多倍体基因组功能研究的空白。
3. 研究思路总结与详细解析
本研究的整体框架为:开发适合同源多倍体的单倍型解析T2T组装流程→利用该流程组装四倍体马铃薯品种华薯4号的基因组并评估质量→从基因组、表观遗传、转录组层面解析单倍型 divergence 特征→解析着丝粒、亚端粒等复杂区域的单倍型差异→总结多倍体基因组组装技术与单倍型功能调控机制。核心科学问题包括如何实现多倍体基因组的高效高准确度单倍型解析T2T组装,以及单倍型 divergence 对马铃薯重要性状的调控机制。技术路线遵循“方法开发→基因组组装→多组学解析→复杂区域研究”的闭环逻辑。
3.1 PHap组装流程开发与华薯4号基因组组装
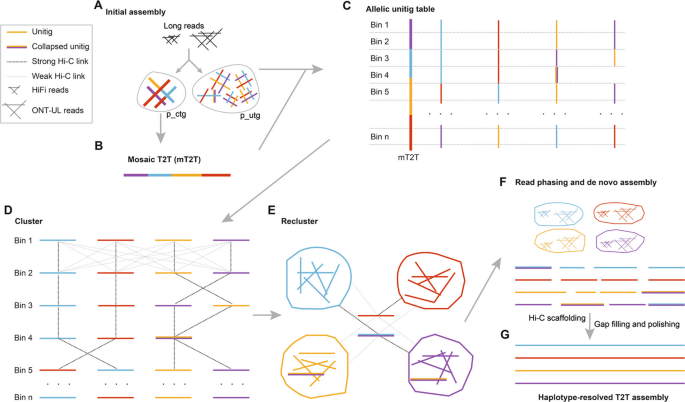
实验目的为开发适合同源多倍体的单倍型解析T2T组装流程,并完成四倍体马铃薯华薯4号的基因组组装。方法细节包括:首先利用Hifiasm对HiFi和ONT-UL reads进行混合组装,得到初级contig组装(p_ctg)和分相unitig组装(p_utg);通过剂量分析将p_utg的unitig分为单倍型unitig(haplotigs)和折叠unitig(diplotigs、triplotigs、tetraplotigs);基于p_ctg的全自比对构建 mosaic T2T(mT2T)参考基因组;结合Hi-C信号强度与mT2T比对结果对unitig进行初始聚类和重聚类;将reads分配至各单倍型组后,用Hifiasm独立组装每个单倍型,再通过Hi-C scaffolding、补洞和polish得到最终染色体水平组装。
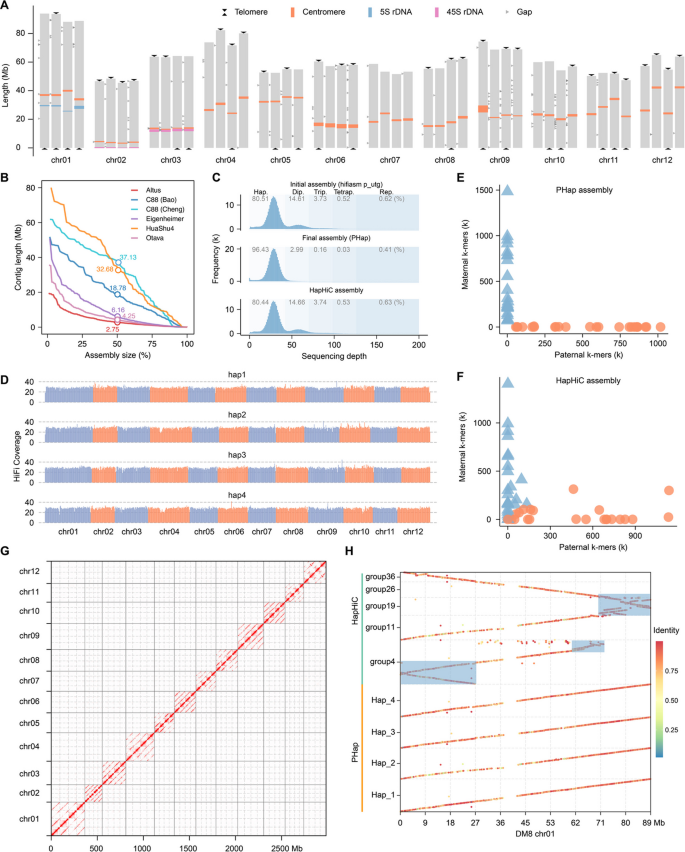
结果解读显示,华薯4号最终组装总长度3.12Gb,contig N50达32.68Mb,约为Otava、C88(Bao)、Eigenheimer和Altus组装的7.69倍、1.74倍、5.31倍和11.88倍;组装包含6条无gap染色体,全基因组仅174个gap,远少于其他四倍体马铃薯组装(如Otava含5657个gap)。通过亲本短reads的k-mer分析,单倍型准确度达99.74%,高于HapHiC组装的89.91%;HiFi、ONT-UL和Illumina reads的mapping率分别为99.91%、99.21%和99.13%,表明组装完整性极高。
产品关联:文献未提及具体实验产品,领域常规使用PacBio Revio平台进行HiFi测序、Nanopore PromethION平台进行ONT-UL测序、MGI/Illumina平台进行Hi-C和RNA-seq测序;组装工具包括Hifiasm、Minimap2、SAMtools等;分析工具包括SyRI、MACS2、Bismark等。
3.2 单倍型基因组序列 divergence 解析
实验目的为解析华薯4号单倍型之间的基因组序列变异与结构 divergence 特征。方法细节包括:通过单倍型序列比对鉴定IBD区域、单核苷酸多态性(SNP)、插入缺失(indel)和结构变异(SV);结合RNA-seq数据进行基因注释,分析基因的等位拷贝数与基因型分布;通过SnpEff鉴定有害突变的分布特征。
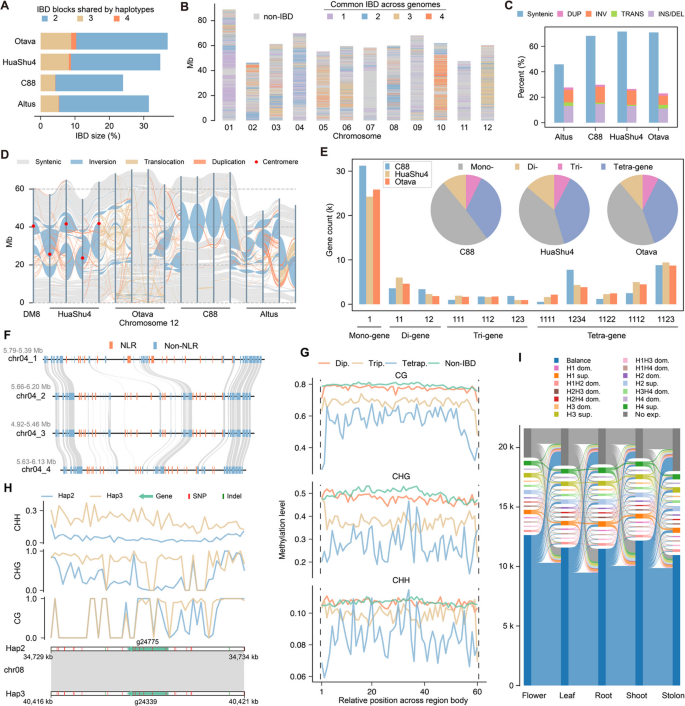
结果解读显示,华薯4号基因组中34.82%(1.04Gb)为IBD区域,与Otava相似但高于C88和Altus;单倍型之间的序列比对显示平均71.0%的区域为共线性,共鉴定到73033个大于50bp的SV,包括插入/缺失、倒位、重复和易位。基因注释得到每个单倍型含36446-37385个蛋白编码基因,形成60209个等位泛基因集,其中38.23%为四等位基因,40.28%为单倍型特异性基因;67.82%的潜在抗病基因(NLR)存在等位拷贝数变异;有害突变中91.51%为杂合,体现了多倍体对突变的高耐受性。
产品关联:文献未提及具体实验产品,领域常规使用SyRI进行结构变异分析、BRAKER进行基因注释、SnpEff进行变异效应预测。
3.3 单倍型表观遗传与动态等位表达 divergence 解析
实验目的为解析单倍型之间的DNA甲基化差异及其对基因表达的调控作用,尤其是块茎发育过程中的动态等位表达特征。方法细节包括:通过全基因组亚硫酸氢盐测序(WGBS)和长读长甲基化分析检测单倍型的DNA甲基化水平;利用5种组织和块茎发育8个时间点的RNA-seq数据,分析等位基因表达差异(ADE)及动态变化。
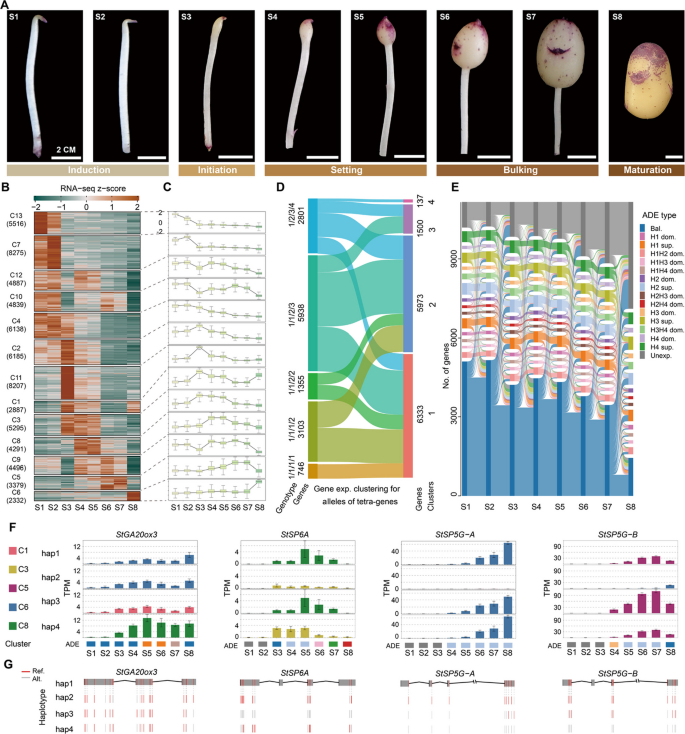
结果解读显示,IBD区域的甲基化水平显著低于非IBD区域,且共享单倍型越多的IBD区域甲基化水平越低;在序列相似性>98%的区域,检测到171Mb的甲基化差异区域。四等位基因中,9.34%的基因在至少3种组织中表现出ADE,其中32.3%的基因表达与基因体或上下游2kb区域的甲基化状态显著相关,26.8%的基因启动子或第一内含子存在indel或SV。块茎发育过程中,54.58%的四等位基因的等位基因表达模式分属不同聚类,部分基因在不同发育阶段呈现平衡表达与优势/抑制表达的动态转换,如StGA20ox3的四个等位基因在块茎发育各阶段的表达模式差异显著,表明动态等位表达大幅增加了转录组的复杂性与可塑性。
产品关联:文献未提及具体实验产品,领域常规使用Bismark进行WGBS分析、Modkit进行ONT甲基化分析、DESeq2进行差异表达分析、kallisto进行等位基因表达定量。
3.4 着丝粒与亚端粒区域单倍型 divergence 解析
实验目的为解析四倍体马铃薯着丝粒和亚端粒区域的单倍型 divergence 特征。方法细节包括:通过CENH3染色质免疫共沉淀测序(ChIP-seq)数据注释着丝粒区域;通过TIDK和SRF工具鉴定端粒与亚端粒卫星重复序列;比对单倍型的着丝粒和亚端粒序列,分析其大小、组成与结构差异。
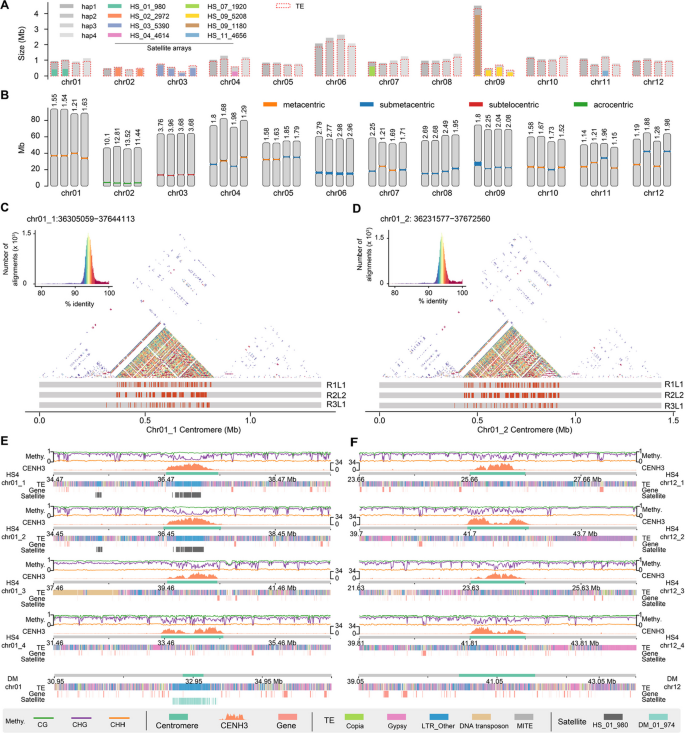
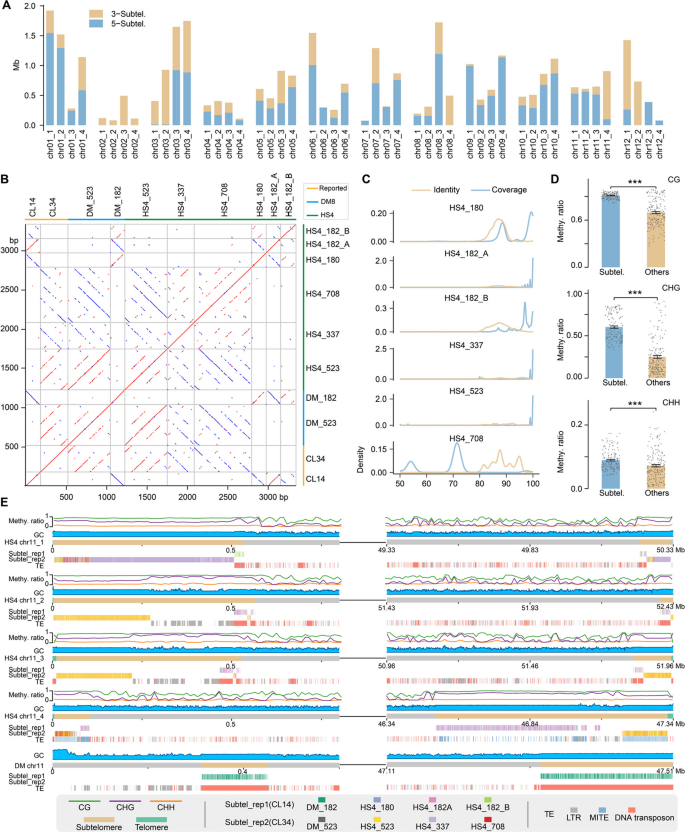
结果解读显示,组装覆盖了48个着丝粒中的41个无gap区域,着丝粒大小为0.25-4.5Mb,平均1.1Mb;同源染色体的着丝粒在大小、卫星阵列类型、转座子(TE)组成、甲基化水平等方面存在显著 divergence,如1号染色体着丝粒的不同单倍型中,TE家族Tekay和Athila的占比差异显著。亚端粒长度为4.84-1544.57kb,平均391.86kb,同源亚端粒在卫星重复类型、TE组成、甲基化水平等方面存在广泛变异,如11号染色体的同源亚端粒大小差异达45.84-807.71kb,卫星重复序列的分布特征明显不同。
产品关联:文献未提及具体实验产品,领域常规使用MACS2进行ChIP-seq峰鉴定、TIDK进行端粒注释、SRF进行卫星重复序列分析。
4. Biomarker研究及发现成果解析
Biomarker定位与筛选逻辑
本研究涉及的Biomarker主要包括两类:一是与抗病性相关的NLR基因等位拷贝数变异(CNV),二是块茎发育过程中的动态等位表达基因。筛选与验证逻辑为:NLR基因CNV通过单倍型序列比对结合功能注释鉴定,动态等位表达基因通过块茎发育时间序列RNA-seq数据的等位表达定量与聚类分析筛选,后续可通过PCR/qPCR或qRT-PCR进行验证。
研究过程与核心数据
NLR基因CNV来源于华薯4号的单倍型基因组序列,通过InterProScan和NLR-Annotator注释后,比对单倍型序列确认67.82%的NLR基因存在等位CNV,这些基因显著富集于防御反应相关功能。动态等位表达基因来源于块茎发育8个时间点的RNA-seq数据,通过kallisto定量显示,54.58%的四等位基因的等位表达模式分属不同聚类,其中部分基因在发育阶段的表达模式转换具有显著统计学差异(P<0.01)。DNA甲基化数据显示,IBD区域的甲基化水平显著低于非IBD区域(P<0.001),且共享单倍型越多的区域甲基化水平越低。
核心成果提炼
本研究首次在同源四倍体马铃薯中系统鉴定了两类功能Biomarker:NLR基因的等位CNV可作为抗病育种的潜在靶点,动态等位表达基因揭示了块茎发育过程中的转录调控新机制。创新性在于首次揭示了同源四倍体中动态等位表达的广泛存在及其在性状发育中的关键作用,为多倍体作物的分子育种提供了新视角。统计学结果包括:IBD区域占比34.82%(基于华薯4号单基因组分析),四等位基因中ADE基因占比9.34%(n=21020,P<0.05),块茎发育过程中54.58%的四等位基因呈现等位表达 divergence(n=13943,P<0.01)。