

1. 领域背景与文献
文献英文标题:Determinants of mutation susceptibility along the genome are largely invariant across human tissues;
发表期刊:Genome Biology;影响因子:17.906(2023年);研究领域:基因组学、肿瘤进化、衰老相关疾病研究
体细胞突变是肿瘤发生、衰老及相关疾病的核心驱动因素,其突变率在不同组织和基因组位置间存在显著差异,这一现象的解析是生命科学领域的研究重点。领域发展关键节点包括:20世纪末发现突变率与染色质结构、DNA修复效率相关;2010年后,高深度测序技术的普及推动研究进入单碱基分辨率,明确序列上下文、复制时间等特征对突变率的调控作用;近年来,机器学习模型开始应用于突变率预测,但仍存在未解决的核心问题。当前研究热点聚焦于解析突变易感性的多维度决定因素,以及这些因素在肿瘤进化和衰老中的应用。未解决的核心问题包括:不同基因组尺度下,各基因组特征对突变易感性的相对贡献尚未量化;人类不同组织间突变规律的保守性及差异来源不明确;缺乏能跨组织、跨健康/肿瘤状态的突变易感性预测模型。
针对上述研究空白,本研究旨在系统解析人类组织间基因组突变易感性的决定因素,通过整合146个基因组和表观基因组特征,建立单碱基分辨率的突变预测模型,量化不同尺度下各特征的贡献,并验证模型在跨组织、健康组织及未训练组织中的适用性,为肿瘤进化、衰老相关疾病的研究提供新的理论基础和工具。
2. 文献综述解析
作者对领域内现有研究的分类维度主要为基因组尺度(单碱基、千碱基、兆碱基级别)和研究方法的完整性(是否整合染色质及表观基因组特征),通过梳理不同研究的结论与局限性,凸显本研究的创新价值。
现有研究在大基因组尺度(兆碱基级别)上,已证实复制时间、GC含量、组蛋白修饰及DNA修复效率是突变率的主要决定因素,这类模型能解释55%-86%的突变率变异;在单碱基分辨率下,研究发现序列上下文、复制时间、基因表达水平等是突变率的关键预测因子,但部分模型未整合染色质特征,仅基于序列上下文进行预测。现有研究的技术优势在于能针对特定尺度解析突变规律,部分模型在特定组织中表现出较好的预测性能;局限性则包括缺乏跨组织的统一分析框架,未量化不同尺度下各特征的相对贡献,且未系统分析突变类型对预测性能的影响,同时多数模型仅针对肿瘤组织,未验证在健康组织中的适用性。
与现有研究相比,本研究的创新点在于首次整合146个涵盖基因组组织、转录活性、序列特征的多维度特征,建立了单碱基分辨率的跨组织突变预测模型;首次量化了不同基因组尺度下序列上下文与其他基因组特征对突变易感性的相对贡献,明确单碱基尺度下序列上下文占主导,大尺度下染色质特征、基因表达及GC含量起主要作用;同时系统验证了模型在健康组织及未训练组织中的适用性,证实人类组织间突变易感性的核心规律高度保守,弥补了现有研究在跨组织分析、多尺度量化及健康组织验证方面的空白。
3. 研究思路总结与详细解析
本研究的整体目标是解析人类基因组突变易感性的组织保守性与尺度依赖性决定因素,核心科学问题为“不同组织、不同基因组尺度下,哪些基因组特征决定突变易感性,以及组织间突变规律的保守性来源是什么”,技术路线遵循“数据收集与预处理→多模型训练与评估→跨组织与多维度验证→机制解析与模型优化”的闭环逻辑,通过系统的实验设计与分析,逐步验证研究假设。
3.1 数据收集与标准化预处理
实验目的:获取高质量的突变数据与基因组特征数据,排除选择压力与序列上下文的干扰,为模型训练提供标准化数据集。方法细节:收集TCGA数据库中10种肿瘤组织(脑、乳腺、结肠等)的外显子体细胞突变数据,PCAWG数据库的全基因组突变数据,以及SomaMutDB数据库中25种健康组织的突变数据;预处理步骤包括:过滤人群频率>1%的突变,排除在多个患者中重复突变的位点以减少正选择影响,按五聚体序列上下文匹配的方式,为每个突变位点(阳性样本)选择对应的非突变位点(阴性样本),平衡正负样本的序列上下文分布;同时整合146个基因组与表观基因组特征,包括基因组组织特征(复制时间、Hi-C数据、GC含量等)、转录活性特征(基因表达、组蛋白修饰、DNA甲基化等)及序列特征(保守性、非B型DNA结构等),部分特征按不同基因组窗口大小(1bp至1Mbp)进行平滑处理。结果解读:最终得到包含1,170,928个突变位点的训练数据集(n=10,覆盖10种组织),正负样本的序列上下文分布完全平衡,排除了序列上下文对模型训练的干扰;整合的多维度特征覆盖了已知与突变相关的所有关键因素,为模型训练提供了全面的输入。产品关联:文献未提及具体实验产品,领域常规使用基因组数据分析工具如bedtools、SAMtools,以及R语言的Bioconductor系列包(如rtracklayer、GenomicRanges)进行数据处理与特征整合。

3.2 多模型训练与性能评估
实验目的:比较不同机器学习模型的突变预测性能,筛选最优模型用于后续分析。方法细节:采用三种模型进行训练与评估,包括随机森林(RF)、逻辑回归(GLM)及带稳定性选择的LASSO(SL);采用染色体交叉验证(CWCV)方案,将22条常染色体依次作为测试集,其余作为训练集,以最小化空间自相关偏差;同时通过下采样分析验证样本量对模型性能的影响,通过移除超突变样本验证模型的鲁棒性。结果解读:随机森林模型在多数组织中表现最优,在6种组织中显著优于GLM和SL模型(DeLong检验,BH调整p<0.05,n=10),所有模型的AUC均在0.54-0.7之间,显著优于随机预测(单样本t检验,BH调整p<1×10⁻¹⁰,n=10);下采样分析显示样本量对模型性能无显著影响,移除超突变样本后模型性能仅在脑组织中略有提升,说明模型具有良好的鲁棒性,未受样本量或极端样本的干扰。产品关联:文献未提及具体实验产品,领域常规使用R语言的ranger包实现随机森林模型,glm包实现逻辑回归,c060包实现带稳定性选择的LASSO,pROC包进行性能评估。
3.3 跨组织模型验证与特征重要性分析
实验目的:验证模型的跨组织适用性,分析不同组织间突变易感性决定因素的保守性。方法细节:将一个组织训练的模型应用于其他组织的突变数据,计算预测性能;通过Gini重要性分析各基因组特征在不同组织中的贡献,并计算组织间特征重要性的相关性。结果解读:模型跨组织应用时性能仅出现轻微损失,预测性能主要取决于目标组织而非训练组织;不同组织间的特征重要性具有显著的正相关性(Pearson相关系数均>0.7,p<0.01,n=10),说明GC含量、复制时间、组蛋白修饰(H3K27ac、H3K4me3等)、基因表达等核心特征在所有组织中均为突变易感性的主要决定因素,组织间突变规律高度保守。产品关联:文献未提及具体实验产品,领域常规使用R语言的cor.test函数进行相关性分析,pheatmap包绘制特征重要性热图。


3.4 突变类型与基因组尺度效应分析
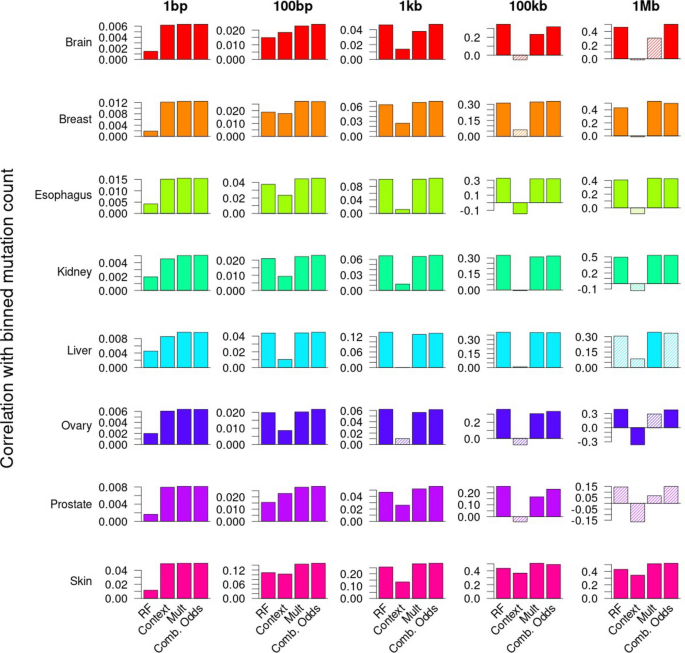
实验目的:解析突变类型对预测性能的影响,以及不同基因组尺度下各特征的相对贡献。方法细节:将突变按碱基替换类型(C>A、C>T等6种类型,合并反向互补类型)分层,分析不同突变类型的预测性能;将基因组分成不同大小的连续bin(1bp至1Mbp),分别计算基于序列上下文的模型、基于基因组特征的随机森林模型及两者组合模型的预测值与实际突变数的相关性。结果解读:不同突变类型的预测性能存在显著差异,如肺组织的C>A突变(AUC=0.63,n=3521,p<0.01)、皮肤组织的C>T突变(AUC=0.68,n=456455,p<0.01)预测性能较好,这些突变类型的诱变剂(如烟草烟雾、紫外线)与基因组特征的关联更紧密;在单碱基尺度下,基于序列上下文的模型预测性能最优(Spearman相关系数=0.42,p<0.05),而在大于1kb的尺度下,基于基因组特征的模型表现更优(Spearman相关系数=0.68,p<0.01),两者组合的模型在所有尺度下均表现出最佳性能,说明序列上下文主导小尺度突变变异,染色质特征等主导大尺度突变变异。产品关联:文献未提及具体实验产品,领域常规使用R语言的ROCR包进行分层性能评估,bedtools包进行基因组bin划分。

3.5 通用全组织模型构建与健康组织验证
实验目的:建立跨组织的通用突变预测模型,验证其在健康组织及未训练组织中的适用性。方法细节:整合所有10种肿瘤组织的突变数据与45个所有组织均可用的基因组特征,训练通用全组织模型;在25种健康组织(包括未用于训练的组织)中验证模型性能,同时构建全基因组通用模型并进行验证。结果解读:通用全组织模型的性能与组织特异性模型相当(AUC差异<0.01,配对t检验p>0.10,n=10),能有效预测健康组织的突变(平均AUC=0.556,单样本t检验p=1.6×10⁻³,n=25),对未训练组织的预测性能也显著优于随机预测(单样本t检验p=1.4×10⁻⁹,n=15);全基因组通用模型在健康组织中的平均AUC为0.582(单样本t检验p=1.4×10⁻¹²,n=28),同样表现出良好的适用性。产品关联:文献未提及具体实验产品,领域常规使用R语言的ranger包训练通用模型,rtracklayer包处理基因组数据。


4. Biomarker研究及发现成果解析
本研究中与突变易感性相关的Biomarker涵盖序列上下文特征、基因组组织特征、转录活性特征三大类,通过系统的筛选与验证,明确了这些Biomarker在不同组织、不同基因组尺度下的贡献,以及组织间的保守性规律。
Biomarker定位:本研究涉及的Biomarker类型包括:序列上下文Biomarker(五聚体序列)、基因组组织Biomarker(复制时间、GC含量、DNA甲基化、染色质可及性、着丝粒/端粒距离)、转录活性Biomarker(基因表达、组蛋白修饰、转录因子结合位点密度)。筛选与验证逻辑为:首先通过整合多维度特征训练机器学习模型,筛选出对突变易感性贡献显著的特征;然后通过跨组织验证、健康组织验证确认其保守性;最后通过不同基因组尺度的分析,明确各Biomarker在不同尺度下的相对贡献。
研究过程详述:Biomarker的来源为人类基因组的公共数据库(TCGA、PCAWG、ENCODE、GTEx等),涵盖肿瘤组织与健康组织的基因组与表观基因组数据;验证方法包括染色体交叉验证、跨组织预测性能评估、不同bin大小的相关性分析;特异性与敏感性方面,核心Biomarker(如GC含量、复制时间、H3K27ac修饰)在所有组织中均表现出显著的预测能力,模型AUC在0.54-0.7之间,跨组织应用时AUC损失<0.05,不同尺度下的相关性分析显示p<0.05(除个别小尺度非显著情况)。
核心成果提炼:本研究的核心成果包括:1. 明确人类组织间突变易感性的决定因素高度保守,GC含量、复制时间、组蛋白修饰、基因表达等核心特征在所有组织中均为主要决定因素,组织间突变差异主要由诱变剂与突变类型决定;2. 量化了不同基因组尺度下各Biomarker的相对贡献,单碱基尺度下序列上下文Biomarker贡献最大,大尺度下基因组组织与转录活性Biomarker占主导;3. 建立的通用全组织模型能有效预测健康组织及未训练组织的突变易感性,为肿瘤进化、衰老相关疾病的研究提供了工具;统计学结果方面,随机森林模型在6种组织中显著优于其他模型(DeLong检验,BH调整p<0.05,n=10),跨组织特征重要性的Pearson相关性显著(p<0.01,n=10),不同尺度下的相关性分析多数p<0.05。