

1. 领域背景与文献
文献英文标题:Genolator enables protein function interpretation using a multimodal large language model fusing genomic and structural interpretation with natural language interaction;
发表期刊:未明确;影响因子:未公开;研究领域:计算基因组学、蛋白质功能预测。
解码遗传密码以揭示基因组功能是推动疾病机制理解、靶向治疗开发的核心研究任务,领域发展经历了从传统实验解析到计算预测的关键演进:早期研究完全依赖实验手段验证蛋白质功能,随着基因组测序技术的突破,人类基因组测序完成后产生了海量未注释的序列数据,催生了各类计算预测方法;近年来大语言模型技术快速发展,将其应用于组学数据解读成为当前领域研究的热点方向。领域共识:目前现有大语言模型大多只能单独处理自然语言或基因组编码数据,同时融合多模态组学信息与自然语言交互能力的模型十分匮乏,现有基因组大语言模型存在对非技术用户不友好、下游任务需重新微调、缺乏自然语言理解能力、输入模态单一等核心问题,无法满足研究者通过自然语言交互探索未知蛋白质功能的需求。
当前人类基因组仍有大量区域功能未被解析,传统实验方法耗时耗力、可扩展性差,无法完成大规模蛋白质功能注释,因此开发一种能够融合多模态组学信息、支持自然语言交互的蛋白质功能预测模型具有重要的学术价值与应用意义,本研究针对这一研究空白,开发了多模态大语言模型Genolator,为基因组功能解读提供了全新的交互工具。
2. 文献综述解析
作者将现有研究按照技术路线分为三类,分别是传统实验解析方法、通用大语言模型、单模态组学大语言模型以及现有少量多模态组学模型,基于不同类型研究的特点梳理了各自的优势与局限性。传统实验解析方法是蛋白质功能鉴定的金标准,结果准确性高,但该方法资源消耗大、实验周期长,无法适配大规模未注释蛋白质的功能解读需求,样本扩展性存在严重局限。通用大语言模型比如GPT 4.1等,已经在自然语言处理领域取得突破,但应用于组学数据解读时存在明显缺陷,这类模型不仅容易产生幻觉,错误记忆基因组序列信息,对长度较长的蛋白质序列识别准确率极低,而且没有针对多模态组学数据做优化,无法真正理解基因组上下文的生物学意义,无法完成准确的蛋白质功能预测。单模态基因组大语言模型比如Evo2等,已经能够基于基因组序列提取有效的生物学特征,预测遗传变异功能、识别核心生物元件,但这类模型大多不支持自然语言交互,针对每个新的下游任务都需要重新微调,对非技术用户不友好,而且这类模型通常只能处理一种模态的数据,无法同时整合DNA序列、氨基酸序列、蛋白质结构的多维度信息,预测准确性存在提升空间。现有领域已有的多模态组学模型比如ChatNT,初步实现了核苷酸序列与自然语言的融合,但该模型没有整合氨基酸序列与蛋白质结构信息,输入序列长度上限较低,也没有针对蛋白质功能预测基于基因本体论术语做训练,无法回答开放型的蛋白质功能相关自然语言问题,仍存在明显的功能局限。
通过对现有研究的梳理可以发现,本研究的核心创新点十分明确,属于领域内首次开发整合DNA序列、结构增强氨基酸序列与自然语言查询的多模态大语言模型,实现了通过自然语言交互完成蛋白质功能解读的功能,在蛋白质功能确认/否定任务上,性能显著优于现有通用大语言模型和领域专用基线模型,同时通过系统的可解释性分析与消融实验证明了多模态融合的有效性,填补了融合多模态组学信息与自然语言交互的蛋白质功能预测模型的研究空白,为未知蛋白质的功能探索提供了新的技术范式。
3. 研究思路总结与详细解析
本研究的整体研究框架清晰,研究目标是开发可支持自然语言交互的多模态大语言模型,实现蛋白质功能的准确解读;核心科学问题是如何融合基因组序列、氨基酸序列、蛋白质结构的多模态信息与自然语言查询,提升蛋白质功能预测的准确性和可及性;技术路线遵循“研究问题提出→多模态问答数据集构建→多模态模型架构设计与微调→多维度性能评估→可解释性与模态重要性分析→结论总结”的完整闭环,逻辑清晰完整。
3.1 多模态问答数据集构建
实验目的:构建符合模型训练需求的大规模蛋白质功能问答数据集,同时设计合理的数据划分策略避免数据泄露,保证模型评估的可靠性。方法细节:基于MANE Select 1.4版本数据获取每个经典蛋白编码基因的代表性转录本,提取对应的DNA序列与氨基酸序列,从AlphaFold蛋白质结构数据库获取对应蛋白质的结构文件;基于基因本体论的三个核心维度(分子功能、细胞组分、生物过程),构建三种类型的问答数据集,分别为确认型问答(验证蛋白质与对应功能的真实关联)、否定型问答(验证模型能否识别蛋白质不存在的功能关联)、开放型问答(要求模型自主输出蛋白质的功能信息);总共生成超过36.5万对问答样本,为避免传统基于基因名称划分数据导致的同源序列数据泄露问题,采用相似感知的K均值聚类划分策略,在多模态嵌入空间对基因聚类,保证相似序列分配到同一个数据集,最终按照约80%/10%/10%的比例划分训练集、验证集和测试集。结果解读:随机选择56个基因的问答样本由两名研究者独立盲审,保证了数据集标注质量,划分后的测试集共包含34743个问题,其中确认型问题15463个(n=15463),否定型问题14943个(n=14943),样本量满足模型评估的需求,该划分策略有效降低了同源序列导致的数据泄露风险,评估结果更具可靠性(文献未明确提供该数据的统计学P值)。文献未提及具体实验产品,领域常规使用BioPython等生物信息学工具包完成数据提取与整理。
3.2 多模态嵌入提取与模型构建
实验目的:提取不同模态的生物学特征,构建多模态融合的大语言模型架构。方法细节:DNA序列嵌入采用预训练Evo2 7B基因组基础模型提取,对每个基因提取token级嵌入后进行平均池化,得到4096维的基因嵌入向量;氨基酸序列嵌入采用ESM2 3B蛋白质语言模型提取,对于长度超过1000氨基酸的序列分割为子序列分别推理,最终经平均池化得到2560维嵌入;结构增强氨基酸嵌入采用PST模型,整合AlphaFold提供的蛋白质结构信息,提取每个氨基酸的嵌入后经平均池化得到固定维度的结构增强嵌入;以经过生物医药微调的Llama 3 8B作为基础大语言模型,为每个模态设计独立的虚拟token投影器,将不同模态的嵌入映射到Llama原生的token嵌入空间,每个模态生成8个虚拟token,拼接后置于文本输入token之前,对投影后的嵌入做范数归一化对齐,保证其规模与原生文本token一致;训练过程中保持Evo2、ESM2、PST的参数冻结,仅训练虚拟token投影器和Llama骨干网络,最终构建两种模型版本:融合Evo2+ESM2的序列-only版本和融合Evo2+PST的结构增强版本,同时设置仅训练投影器、冻结Llama骨干网络的消融版本用于对照。结果解读:该架构成功实现了多模态组学信息与自然语言查询的融合,模型既可以回答确认/否定型的二分类问题,也可以回答开放型的蛋白质功能询问,支持用户通过自然语言交互探索未知蛋白质的功能。
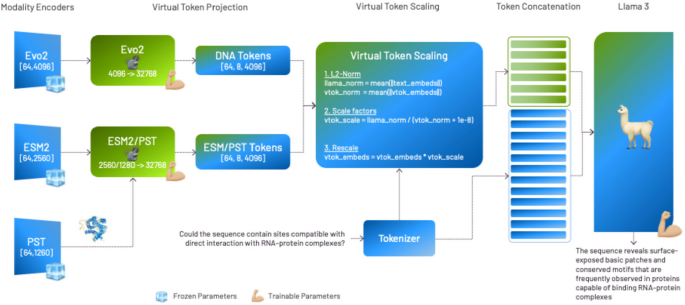
文献未提及具体实验产品,领域常规使用Hugging Face、PyTorch等深度学习框架完成模型构建与训练。
3.3 模型性能评估
实验目的:对比Genolator与各类基线模型的性能,验证Genolator的准确性优势。方法细节:对于确认/否定型任务,将其转换为二分类问题,共对比六种模型:两个全微调Genolator版本、两个仅投影器微调的消融版本、XGBoost基线分类器、GPT 4.1基线分类器,采用准确率、精确率、召回率、F1分数、马修斯相关系数(MCC)作为评价指标;对于开放型问题,仅评估性能最优的Evo2+PST全微调模型,采用GPT 4.1作为模型评判器,将模型输出和真值都映射到简化版GO Slim术语,分别计算精确匹配、部分重叠、无重叠的样本比例,同时对比预测与真值的GO术语频率分布。结果解读:性能评估结果显示,全微调的Evo2+PST结构增强模型性能最优,总体F1分数约为0.98,马修斯相关系数为0.959(n=34743,文献未明确提供P值);Evo2+ESM2全微调模型总体F1分数为0.97,马修斯相关系数为0.948(n=34743);所有Genolator版本性能均优于基线模型,其中GPT 4.1的马修斯相关系数仅为0.179,XGBoost基线的马修斯相关系数为0.913,仅投影器微调的两个版本马修斯相关系数分别为0.895和0.924,均低于全微调版本。开放型问题评估结果显示,生物过程维度5.44%的样本达到精确匹配,78.51%的样本预测与真值存在重叠,21.49%无重叠;细胞组分维度5.83%精确匹配,89.19%存在重叠,10.81%无重叠;分子功能维度2.51%精确匹配,89.59%存在重叠,10.41%无重叠,模型预测的GO术语频率分布与真值整体高度一致,仅在少数术语上存在计数偏差,证明模型已经学习到了蛋白质功能的真实分布规律。
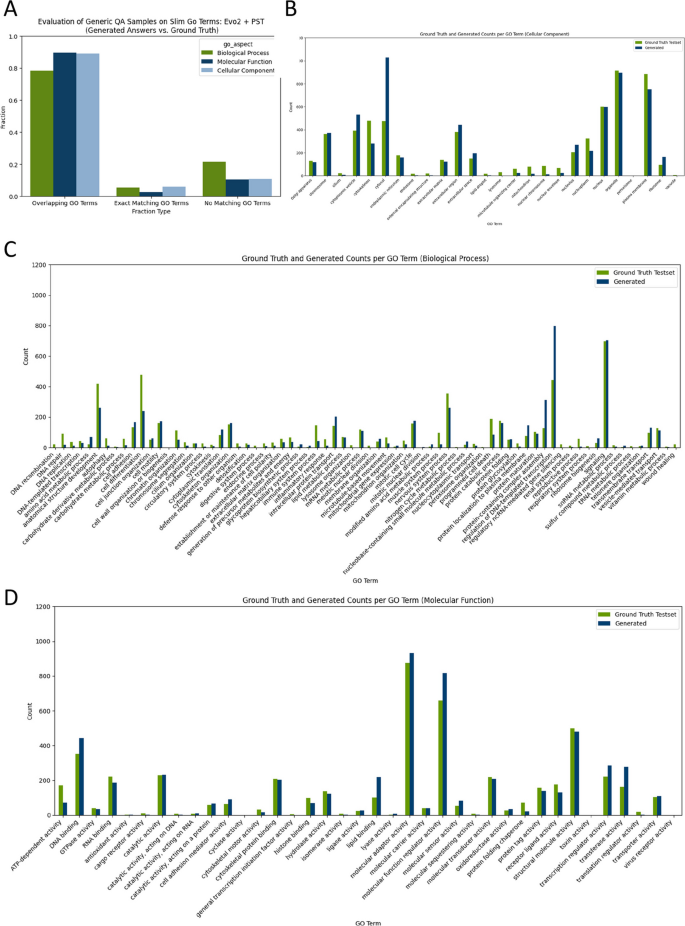
文献未提及具体实验产品,领域常规使用机器学习指标计算工具完成性能评估。
3.4 模型可解释性与模态重要性分析
实验目的:分析Genolator学习到的隐藏表征是否符合生物学逻辑,验证多模态融合的有效性,量化不同模态对模型性能的贡献。方法细节:提取Llama最后一层输出的隐藏状态,采用t分布邻域嵌入(t-SNE)将高维隐藏状态投影到二维空间,分析不同GO术语的聚类模式;计算GO术语平均隐藏状态之间的成对余弦相似度,分析功能相关术语的相似性是否符合生物学逻辑;分析所有32个Transformer层、每个层所有32个注意力头的注意力权重分布,研究不同模态的注意力分配规律;开展虚拟token消融实验,将对应模态的虚拟token替换为零向量,计算测试集交叉熵损失的上升幅度,量化不同模态对模型性能的重要性。结果解读:可解释性分析结果显示,Genolator的隐藏表征完全符合生物学逻辑,t-SNE可视化结果显示,模型可以清晰区分确认和否定的功能关联,生物学功能相关的GO术语会在嵌入空间聚集在一起,比如DNA模板转录调控邻近染色质组装,细胞周期和细胞死亡邻近DNA修复,不同GO维度(生物过程、分子功能、细胞组分)可以形成三个明显可分的簇,完全符合基因本体论的层级结构。余弦相似度分析显示,功能直接相关的跨维度GO术语余弦距离更小,比如跨膜运输(生物过程)和转运体活性(分子功能)的余弦相似度为0.015,呈现高度相似,而DNA结合(分子功能)和细胞外基质组织(生物过程)的余弦相似度为0.185,相似性极低,完全符合生物学实际。
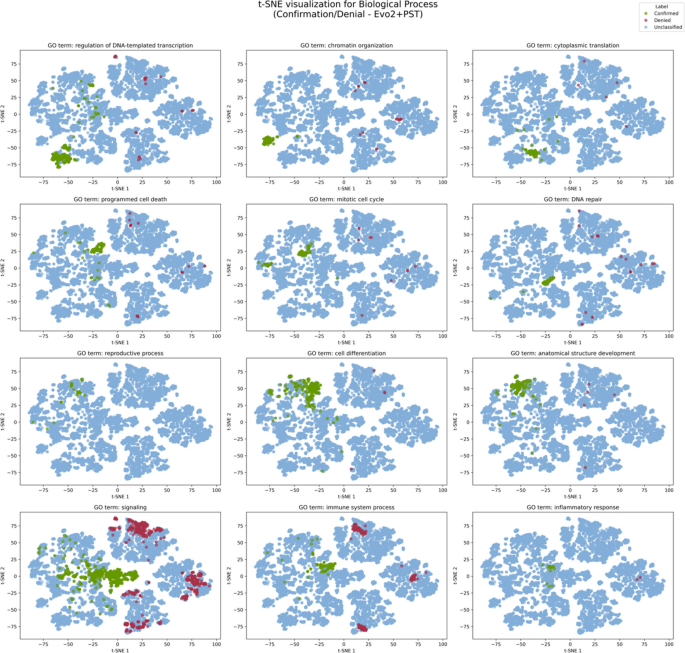
模态重要性分析结果显示,在Evo2+ESM2模型中,从第2层到第31层,Evo2 token的平均注意力超过0.6,在第29层达到峰值0.837,ESM2 token的注意力普遍很低;消融实验显示,去掉Evo2 token导致交叉熵损失上升1.32%,去掉ESM2仅上升0.51%,说明Evo2 DNA嵌入对该模型的贡献更大。在Evo2+PST模型中,第一层PST token的平均注意力为0.138,多个注意力头的注意力超过0.2,从第二层开始PST注意力迅速下降,Evo2注意力逐渐上升,在第29层达到峰值0.708;消融实验显示,去掉PST token导致损失上升3.31%,去掉Evo2仅上升0.56%,说明结构增强的PST嵌入对模型性能贡献更大,证明整合蛋白质结构信息可以显著提升模型对蛋白质功能的预测能力。
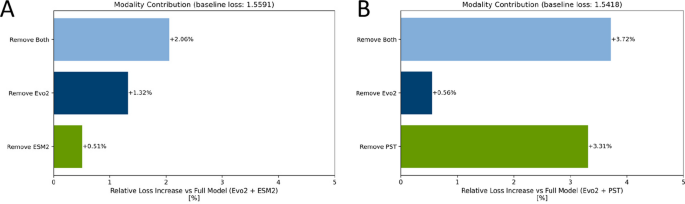
文献未提及具体实验产品,领域常规使用机器学习可视化与统计工具完成可解释性分析。
4. Biomarker研究及发现成果
本文属于计算方法学研究,核心目标是开发用于蛋白质功能解读的多模态大语言模型,未涉及新生物标志物的筛选、验证与临床应用研究,因此无相关Biomarker研究成果。本研究开发的Genolator模型可以为未知蛋白质的功能注释提供工具支持,有助于加速潜在疾病相关生物标志物的功能鉴定研究。