

1. 领域背景与文献
文献英文标题:Decoding the cancer microbiome: multi-omics, AI, and translational opportunities。
发表期刊:文献未明确提供;影响因子:未公开;研究领域:肿瘤微生物组学,计算肿瘤学。
领域共识:癌症仍是全球范围内重大公共卫生问题,每年新增约2000万病例,预计2050年将达到每年3050万新发病例。癌症的发生、进展、治疗应答不仅受肿瘤细胞内在突变、代谢和信号通路异常等固有因素影响,也受肿瘤微环境、肿瘤宏观环境中的肿瘤外在因素调控,癌症微生物组(包含肠道微生物组和肿瘤相关微生物组)是关键的肿瘤外在调控因素。
早期癌症微生物组研究因解剖位置 proximity 集中于结直肠癌,后续研究发现肠道微生物组可作为肿瘤宏观环境的组成部分,系统性调控宿主免疫和代谢,影响消化系统外多种癌症的发生、进展、治疗应答和免疫相关不良事件,饮食诱导的微生物组组成改变在其中发挥重要作用。与肠道微生物组的系统性作用不同,肿瘤相关微生物定位于肿瘤微环境局部,组成具有癌症类型特异性,可定位于肿瘤细胞和免疫细胞的胞内外,在肿瘤内呈现空间组织特征,可通过感染、炎症和代谢产物影响肿瘤微环境,多项实验模型和人类队列研究将肿瘤内微生物与多种癌症的进展、预后和治疗应答关联起来。
计算方法一直是癌症微生物组研究的核心支撑,早期研究依赖差异丰度分析等经典统计工具鉴定与癌症风险、生存、治疗应答相关的分类单元,但这类方法难以处理微生物组数据高维、稀疏、零膨胀和组成型的特征,结果可重复性差。后续基于网络的方法拓展了分析框架,可建模微生物相互作用,鉴定与癌症过程相关的群落结构,但仍然难以捕捉复杂非线性关系。近年来人工智能尤其是深度学习技术,可整合微生物组和多组学数据,更好地建模非线性和高阶相互作用,提升了生物标志物发现和临床结局预测能力。
尽管领域已经取得上述进展,仍然存在多个核心挑战限制人工智能模型的可靠性、可解释性,以及癌症微生物组发现的临床转化。数据层面,领域缺乏样本采集、DNA提取、测序和分类分析的标准化流程,不同平台和参考数据库之间存在显著技术变异和不一致性;肿瘤相关微生物研究中,难以区分真实微生物信号与实验室污染或错误分类的序列,尤其是从宿主转录组测序数据推断微生物信号时,这些问题导致批次效应和队列特异性偏倚,降低了结果的可重复性和泛化性。模型层面,多数人工智能模型依赖高维小样本数据集,过拟合风险高,降低了生物标志物稳定性,且缺乏强有力的外部或前瞻性验证;尽管可解释人工智能方法提升了模型透明度,深度学习框架整体仍处于半透明状态,难以区分虚假相关性和真实的微生物-宿主因果机制。这些问题共同阻碍了可靠的人工智能衍生微生物组生物标志物开发,以及向临床可应用方向的转化。
本综述针对上述问题,构建了人工智能重塑癌症微生物组研究的整合框架,从数据生成、预处理到预测建模、生物学解读再到临床转化进行系统梳理,为领域提供清晰的研究范式和转化路径指导。
2. 文献综述解析
本文以人工智能在癌症微生物组研究中的全流程应用为核心主题,按研究推进的逻辑顺序分类梳理现有研究,依次从癌症微生物组数据资源、人工智能数据预处理、人工智能建模框架、癌症微生物组生物学证据层级、临床转化路径五个维度展开评述,对比不同技术方向的优势与局限,明确未解决的核心问题。
现有研究已经开发了多类组学技术用于癌症微生物组研究,基因组层面,16S核糖体RNA测序成本低廉,可在属水平估计群落组成,但结果受测序可变区域选择影响,分类分辨率有限;全长16S测序可提升分辨率至物种水平,降低区域特异性偏倚;宏基因组鸟枪法测序可获得样本中全部基因信息,同时实现分类分析和功能通路、耐药预测,但不同技术获得的组成和功能推论存在差异。宏转录组学可捕获微生物实时基因表达和动态活性,但由于RNA稳定性差、样本处理要求高、转录水平活性解读难度大,在大规模癌症微生物组研究中应用仍然有限。宏蛋白质组学可直接捕获表达蛋白,提供与患者分层和癌症发病机制相关的蛋白标志物和功能通路,但其在癌症领域应用十分有限,截至2026年6月,仅检索到9项相关研究,存在明确研究空白。代谢组学可检测微生物产生的小分子代谢物,反映微生物对宿主生理的影响,空间代谢组学技术进展可进一步绘制肿瘤内区域特异性代谢改变,帮助理解局部癌症-微生物相互作用,但区分微生物来源和宿主来源代谢产物仍然存在较大挑战。在肿瘤相关微生物检测方面, bulk组学和已有数据重分析可获得有用信息,但肿瘤内微生物丰度低,信号容易被污染干扰,专门开发的单细胞测序和空间组学方法可解析肿瘤内微生物的空间和细胞异质性,但性能依赖组织特异性微生物丰度、检测灵敏度和合适的宿主背景对照。多组学匹配的宿主-微生物数据集可支撑宿主-微生物相互作用研究,但生成配对数据集成本高,公共数据多为回顾性收集,配对样本少,不同组学平台数据结构差异大,整合难度高,同时存在队列效应和个体内时空异质性问题。
数据预处理层面,针对肠道微生物组高生物量特征,传统基于规则的过滤方法在异质性数据集中鲁棒性不足,新一代基于人工智能的方法可实现组装和样本水平的整体评估,提升了质控性能;去污染是肿瘤相关微生物研究的核心挑战,新一代统计和概率方法可同时处理共享外源污染和样本间交叉污染,提升低信号背景下的信号可靠性。宿主序列去除和分类注释层面,传统方法依赖参考数据库,难以检测新的或低丰度分类单元,基于人工智能的方法通过表示学习提升了对新分类单元的泛化能力,针对肿瘤相关微生物数据,专门开发的整合机器学习评分的计算框架可提升微生物鉴定精度,过滤低置信度注释。领域已经提出了判断肿瘤相关微生物可信信号的多维度标准,强调需要阴性对照、严格分析、正交验证多类证据支持,但归一化和批次校正策略在肿瘤微生物组研究中仍然存在争议,需要经验性评估而非先验选择,不同预处理策略下需要评估预测特征的稳定性。
人工智能建模层面,现有框架分为经典机器学习、深度学习和基础模型三类,三类框架具有互补优势:经典机器学习包括逻辑回归、正则化线性模型、支持向量机、随机森林等,依赖显式定义特征,在小样本场景下可解释性强、计算高效、鲁棒性好,基准研究显示其性能可与复杂模型相当,仍然是数据有限研究的可靠基线;深度学习可灵活建模非线性和高维度相互作用,支持直接从微生物组和多组学数据中学习表示,不同框架适配不同数据类型,但容易过拟合,可解释性不足,计算成本高;基础模型通过自监督学习获得可迁移表示,可缓解标记数据稀缺问题,提升跨队列泛化性,但其在癌症微生物组研究中应用仍处于早期,存在预训练数据领域不匹配、计算成本高、可解释性差的问题。在应用方向上,人工智能已经实现从简单癌症/健康二分类到更精细的转移状态预测、跨队列稳健预测、多类癌症区分的发展,整合多组学数据可提升治疗结局预测性能,但整合多数据层会增加模型复杂度,加剧过拟合风险。模型可解释性已经从简单特征排序发展到基于归因、方向感知、网络水平的解释,但模型得到的重要特征仍需要作为生物学假设,通过特征稳定性评估、外部队列验证和正交实验验证确认可靠性。模型验证层面,强调需要无信息泄露的验证设计,采用适配任务的评估指标,尽可能开展独立外部队列验证,提升结果可靠性。
相较于现有分散性综述,本文创新点在于首次系统构建了从数据生成到临床转化的全流程人工智能应用整合框架,明确了各环节的核心挑战,提出了可操作的标准化改进方案,厘清了癌症微生物组研究不同证据层级的科学价值,阐明了临床转化的分阶段路径和待解决的核心问题,弥补了领域缺乏系统性规范性指导的空白,为推动癌症微生物组研究从关联性观察向临床可应用方向发展提供了重要支撑。
3. 研究思路总结与详细解析
本文的研究目标是系统梳理多组学结合人工智能技术在癌症微生物组研究中的发展现状,解决当前领域模型可靠性不足、转化路径不清晰的核心问题,构建从数据生成、预处理、建模、验证到生物学证据确认再到临床转化的完整技术框架。核心科学问题包括:如何处理癌症微生物组数据尤其是低丰度肿瘤相关微生物数据,获得适合人工智能分析的可靠特征;如何选择合适的人工智能模型适配数据特征,提升模型可靠性和可解释性;如何将癌症微生物组发现从关联性研究推进到临床可应用产品。技术路线遵循:领域核心问题提出→数据资源与技术梳理→预处理方法与标准总结→建模框架与应用分析→生物学证据层级归纳→临床转化路径总结→未来研究方向展望的完整逻辑闭环。
3.1 领域核心框架构建
实验目的:整合现有研究进展,提炼癌症微生物组人工智能研究的完整转化框架。
方法细节:采用系统性综述方法,按研究推进顺序梳理已发表技术和研究成果,以可靠性和转化潜力为核心标准对比不同方案的优劣。
结果解读:本文明确癌症微生物组人工智能研究分为五个相互关联的阶段,第一阶段通过多组学技术获得肠道和肿瘤相关微生物的多维度数据,作为下游分析的基础;第二阶段对原始测序数据进行质控、去污染、宿主序列去除、分类注释、归一化、批次校正和微生物信号验证,生成适配人工智能分析的特征矩阵;第三阶段采用机器学习、深度学习、图神经网络、转化器、基础模型等不同框架开展预测任务和多组学整合,同时进行模型解释和严格验证;第四阶段对人工智能衍生的假设通过关联研究、机制研究、扰动实验建立多水平生物学证据;第五阶段将验证后的发现通过生物标志物开发、分析和临床验证、人工智能辅助临床决策支持系统开发转化为临床应用,最终推动精准肿瘤学发展。该框架清晰呈现了领域研究的完整逻辑,为后续研究提供了系统性指引。
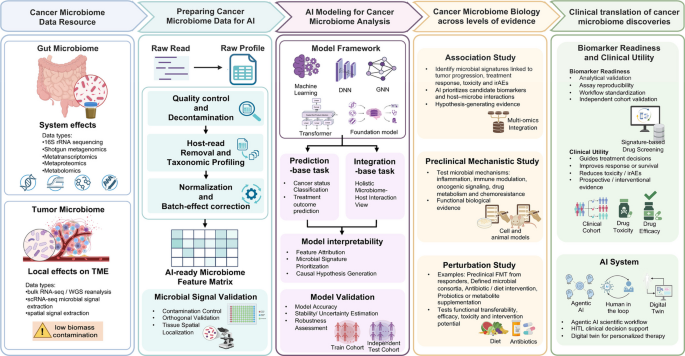
文献未提及具体实验产品,领域常规使用测序仪、质谱仪等多组学检测设备,生物信息学分析软件及计算服务器开展相关研究。
3.2 全流程方法学标准总结
实验目的:明确各研究环节保障结果可靠性的实用标准,为领域提供规范指引。
方法细节:分别针对数据预处理、人工智能建模、模型验证三个核心环节,梳理现有方法的适用场景,总结已被验证的改进策略。
结果解读:在数据预处理环节,本文提出可信肿瘤相关微生物信号需要满足四项互补标准,包括设置提取空白、试剂对照、无模板聚合酶链式反应对照、批次匹配环境对照等合适阴性对照,采用整理后的参考数据库开展保守的宿主序列去除和分类注释,评估批次结构、测序深度和背景微生物图谱,尽可能开展正交验证。在归一化和批次校正环节,强调肿瘤微生物组研究需要经验性评估不同预处理策略的影响,开展原始数据与校正数据的对比,评估不同策略下预测特征的稳定性,不能直接先验选择单一策略。在人工智能建模环节,提出算法选择需要平衡预测性能、模型复杂度、可解释性、计算成本和验证稳定性,不能默认选择更大更灵活的模型;经典机器学习在数据有限场景下仍然是可靠的性能基线,深度学习适合整合多组学数据建模非线性相互作用,基础模型的应用仍有待进一步发展。在模型验证环节,提出无信息泄露的验证设计要求,所有数据自适应预处理和模型开发步骤需要严格在训练拆分内完成,而非基于全数据集训练,优先采用嵌套交叉验证和分组感知的验证策略,需要采用适配预测任务的性能评估指标,通过置信区间、重复交叉验证等方式评估模型不确定性,尽可能在独立外部队列验证模型泛化性。最终本文形成了包含六个步骤的可靠癌症微生物组人工智能分析实用流程,为领域提供了可直接参考的操作规范。
文献未提及具体实验产品,领域常规使用生物信息学分析软件及计算服务器开展相关研究。
3.3 生物学证据层级与转化路径归纳
实验目的:明确癌症微生物组发现从关联到临床应用的证据等级要求,梳理临床转化的分阶段路径。
方法细节:按肿瘤发生进展、治疗应答两个核心研究方向,整理不同研究类型的证据等级,总结临床转化各阶段的核心目标和评价标准。
结果解读:本文将癌症微生物组研究证据分为两个层级,第一层级为关联性研究,通过观察性分析和人工智能整合筛选候选微生物特征和宿主-微生物相互作用,属于假设生成阶段;第二层级为机制验证研究,通过预临床模型、扰动实验提供因果支持,筛选具有真实生物学意义的发现。临床转化阶段需要依次完成三个层级的证据积累,分别是分析验证,确定检测方法的准确性、可重复性和稳健性;临床验证,确定检测特征在独立人群中可重复关联临床状态或结局;临床效用证明,确定基于生物标志物的决策可改善患者结局。当前多数癌症微生物组生物标志物仍处于发现或早期分析验证阶段,结直肠癌粪便宏基因组分类器最为成熟,跨队列荟萃分析得到的可重复分类特征在独立队列中仍保持约0.8的预测精度;免疫检查点抑制剂应答预测生物标志物处于中间阶段,在队列水平具有稳健关联,但跨队列泛化性不足,没有单一分类单元可作为稳定的生物标志物;肿瘤内在微生物特征信号仍需要解决污染和分类错误导致的假阳性问题,信号可靠性有待进一步验证。在干预层面,应答者来源粪便微生物群移植、特定活生物治疗、高膳食纤维饮食都显示出初步积极信号,但仍存在安全风险、产品标准化不足等问题,需要大样本随机对照试验验证安全性和有效性。
文献未提及具体实验产品,领域常规使用细胞系、模式动物、临床检测试剂盒开展相关验证研究。
4. Biomarker研究及发现成果
Biomarker定位
本文涉及的癌症微生物组生物标志物主要分为三类,分别为粪便微生物分类与功能特征(用于结直肠癌等癌症的诊断与风险分层)、肠道/肿瘤相关微生物分类特征(用于预测化疗、免疫检查点抑制剂的治疗应答和不良事件)、微生物代谢产物特征(用于关联肿瘤发生和治疗应答)。筛选验证的完整逻辑为:基于多组学队列数据通过人工智能筛选候选特征→关联性分析初步评估关联显著性→独立队列验证信号稳定性→机制实验验证生物学功能→分阶段完成分析验证、临床验证和临床效用证明推进转化。
研究过程详述
生物标志物的来源主要包括临床粪便样本、肿瘤组织样本、血液样本;验证方法包括多组学测序、定量聚合酶链式反应、原位杂交、免疫组化、酶联免疫吸附实验、动物模型扰动实验等。在诊断生物标志物方面,结直肠癌粪便微生物分类模型经过多队列验证,在独立外部队列中受试者工作特征曲线下面积约为0.8(文献未明确提供统一样本量,为多研究汇总结果)。在治疗应答预测生物标志物方面,多个独立队列一致显示,肠道微生物多样性升高、普拉梭菌丰度升高与免疫检查点抑制剂良好应答相关,而梭杆菌丰度升高与耐药相关;最新的CIAO临床试验显示,头颈部癌中肿瘤内细菌总丰度是免疫检查点阻断应答的预测特征,高细菌丰度与中性粒细胞积累、T细胞和其他适应性免疫细胞耗竭标记的免疫抑制性肿瘤微环境相关(文献未明确提供样本量与P值)。在化疗毒性预测方面,结直肠癌患者卡培他滨治疗后,粪便样本中甲基萘醌生物合成基因富集,后续小鼠实验验证显示甲基萘醌-4补充可减少化疗诱导的外周感觉神经病。
核心成果提炼
当前癌症微生物组生物标志物研究已经筛选获得多个具有临床潜力的候选特征,其中结直肠癌粪便微生物诊断标志物最为成熟,已经完成多队列交叉验证,预测曲线下面积约为0.8,具备进入临床转化的条件。微生物特征可有效预测癌症治疗应答和毒性,帮助患者进行治疗分层,改善临床结局,但是多数候选标志物仍处于关联性研究阶段,缺乏跨队列验证和临床效用证明。本文首次系统总结了癌症微生物组生物标志物从发现到临床转化的证据层级要求,明确了当前各类型标志物所处的转化阶段,为后续领域内生物标志物开发提供了规范性框架,避免了不规范研究导致的假阳性发现和转化浪费。
推测:随着标准化实验和计算流程的建立,以及大样本前瞻性队列的积累,癌症微生物组生物标志物将逐步完成临床验证,进入临床应用,辅助癌症的精准诊断和治疗决策,推动精准肿瘤学发展。